

知道哪些回答显得情商高,确实可能影响自评结果。但从这里不能跳到两个相反的结论:所有情商自评都毫无意义,或者一张高分报告已经证明这个人在说谎。需要分清“能够美化”和“在这一次实际美化了”。
模拟求职实验发现了什么
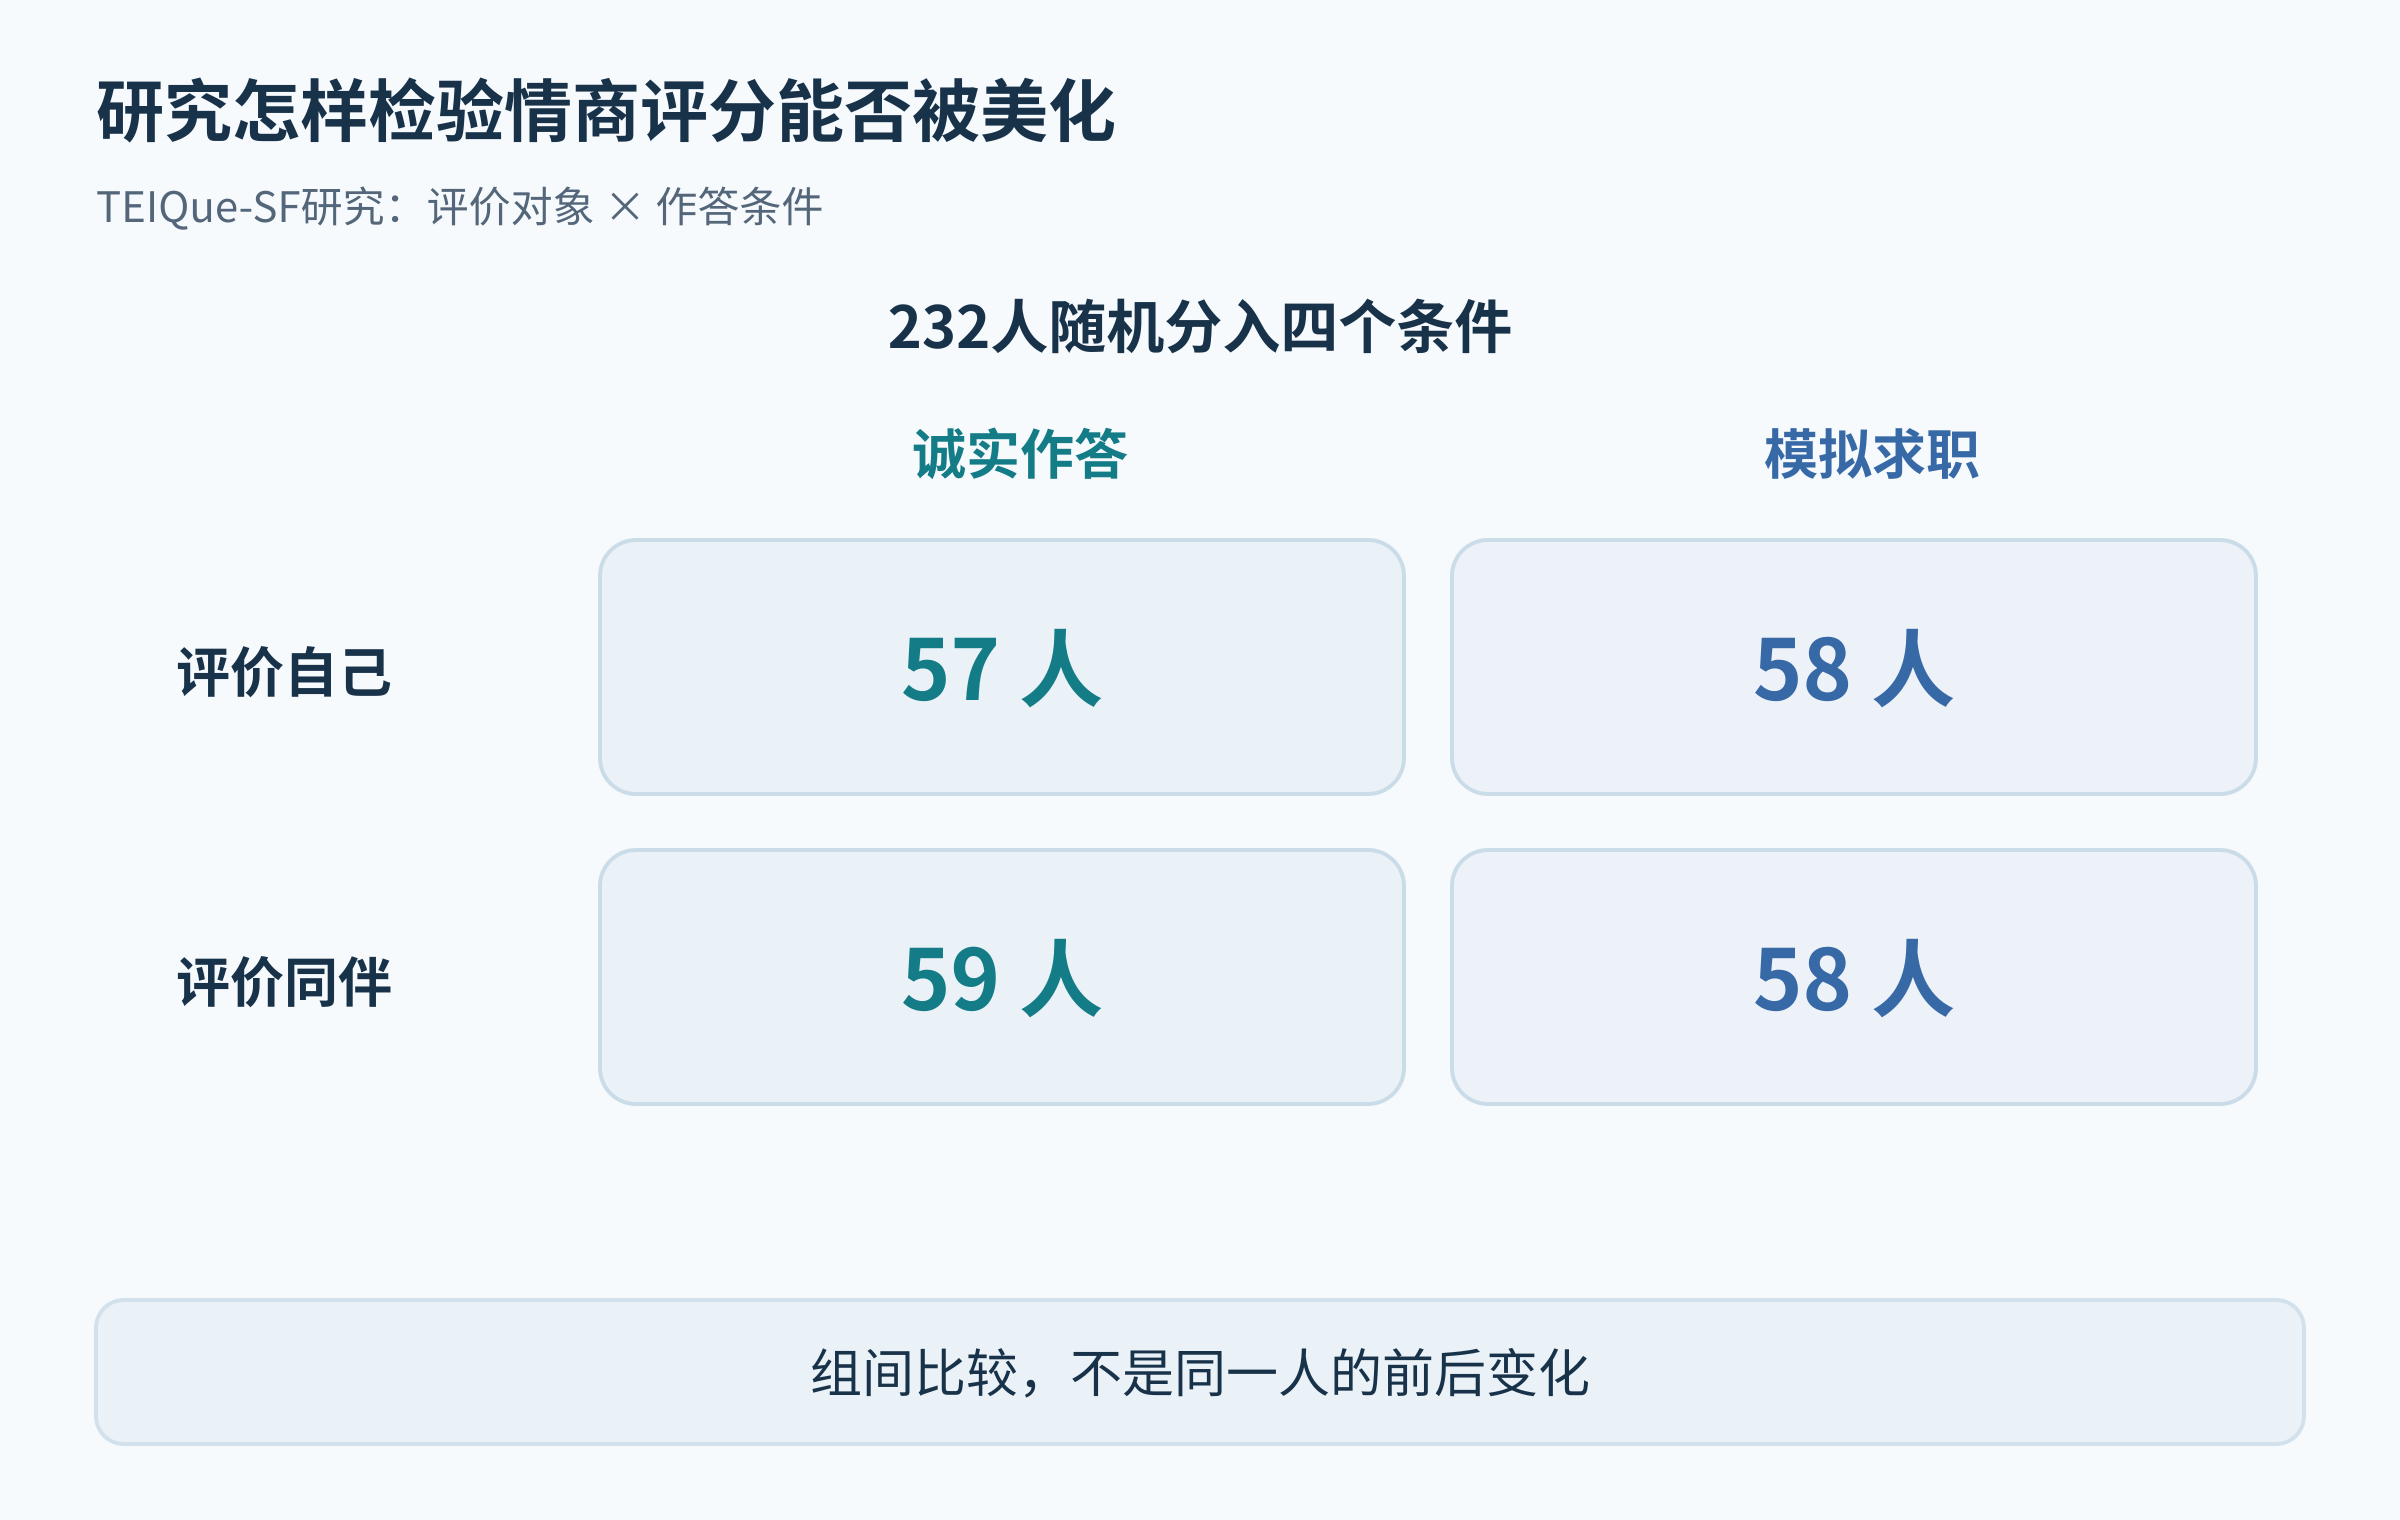
Walker与MacCann的一项研究,让232名成人分别完成TEIQue-SF自评,或为一名同伴评分;参与者被随机分到诚实作答或模拟求职条件。两种评分来源与两种指导条件交叉,形成四个组,而不是同一个人反复完成四次。
在模拟求职条件下,自评和他评的平均分都明显高于诚实条件。这说明,至少对这项工具和研究设置,人们既能把自己的描述变得更有利,也能替别人作更有利的描述。请熟人填写,并不能天然排除有意呈现理想形象。
实验均值,不是识别个人说谎的分界线
研究比较的是不同条件下的组平均差异。图中的数字是原研究使用的TEIQue-SF总分,不是统一的EQ标准分,更不是超过某个数字就可认定美化的阈值。

模拟求职让参与者明确朝某种呈现方向作答,它可以检验“是否能做到”,却不直接告诉我们现实中有多少人会这样做、具体会提高多少,或某位真实受测者有没有这么做。不能把实验差值从一份个人报告里扣掉,声称找到了他的真实情商。
这也不是说所有自评与他评不一致都来自美化。理解题意、观察情境、对自身表现的看法都可能不同;这些来源需要分别核对,而不是先以其中一份为真、另一份为假。
可被美化,为什么仍可能有使用价值
一份自评可以提供一个人怎样描述自身情绪倾向的信息。在清楚目的、允许如实表达的条件下,它可成为研究或讨论的一个起点。它的价值不要求每次回答都完美无偏,也不意味着可以把分数当作脱离情境的真实能力证明。
用途越重要,越不能让单一评分独自承担结论。若用于选拔或其他有明显利害关系的决定,应有该用途的验证依据,并结合与目标相关的其他资料。换一个评分者,只改变信息来源,并没有自动完成效度验证。
同样,答得慢、答案有变化,或看起来不像“全选最好”,都不能单独证明诚实。对作答质量的判断需要适用方法,不能靠几个表面特征把人分成可信与不可信。
普通读者可以怎样看自己的结果
先回想填写时想呈现的是“平时的我”,还是“我希望成为的我”。如果两者混在一起,可以在反馈时说明,而不是不断重做直到分数看起来满意。讨论具体情境,例如一次受挫后怎样回应,比争论一个总分更容易找到可观察的内容。
若他人根据你的高分指责你“太会包装”,这份实验也不能为这种指责提供个人证据。研究提示的是测量的可变性,不是授予任何人识破内心的能力。
更稳妥的结论是:情商自评需要连同作答目的与条件一起解释。分数可以带来线索,但不应替代对实际行为、情境和证据范围的了解。
参考资料
Walker与MacCann:Faking Good on Self-Reports Versus Informant-Reports of Emotional Intelligence,2023年在线发表、2024年卷期刊载;重点参见研究设计与表1。