

“我的感受明明是真的,情商测验为什么还能给答案判分?”这个疑问很合理。要分清的是:测验让你报告自己的体验,还是要求你完成一项关于情绪信息的判断任务。
描述此刻的难过、愤怒或紧张,与判断一个规定情境中的情绪线索,是不同任务。能力型情绪智力测验尝试评价后者的表现,不是替一个人的真实感受规定对错。
自评问卷与表现任务,计分问题不同
自评问卷通常请人描述自己惯常怎样感受和行动,计分反映所报告的特征。能力型任务则要先规定解决的问题,再建立可以评价回答的依据。MSCEIT系列属于能力型情绪智力测量的重要例子,理论上关注情绪信息的知觉、联系、理解与管理等方面。[2]
这不意味着所有关于情绪的问题都存在一个放之四海而皆准的答案。题目必须足够清楚,评分需要有依据,还要检验分数是否能支持预定解释。现实生活里信息不全、目标不同的互动,也不能直接照搬成一道考试题。
先认清旧版V2.0与新版MSCEIT 2
这两个名称很相近,却不能当成同一个版本。2025年发表的新版开发研究,回顾了早期的共识评分思路及旧版MSCEIT采用专家共识的做法:回答与参照群体或专家判断的对应关系,参与形成计分。
这种思路自然会引出疑问:很多人同意的答案,是否一定更好?少数人的判断是否可能更准确?新版研究正是在既有争论和研究积累上,对评分方法作了调整,而不是简单重发旧版材料。[1]
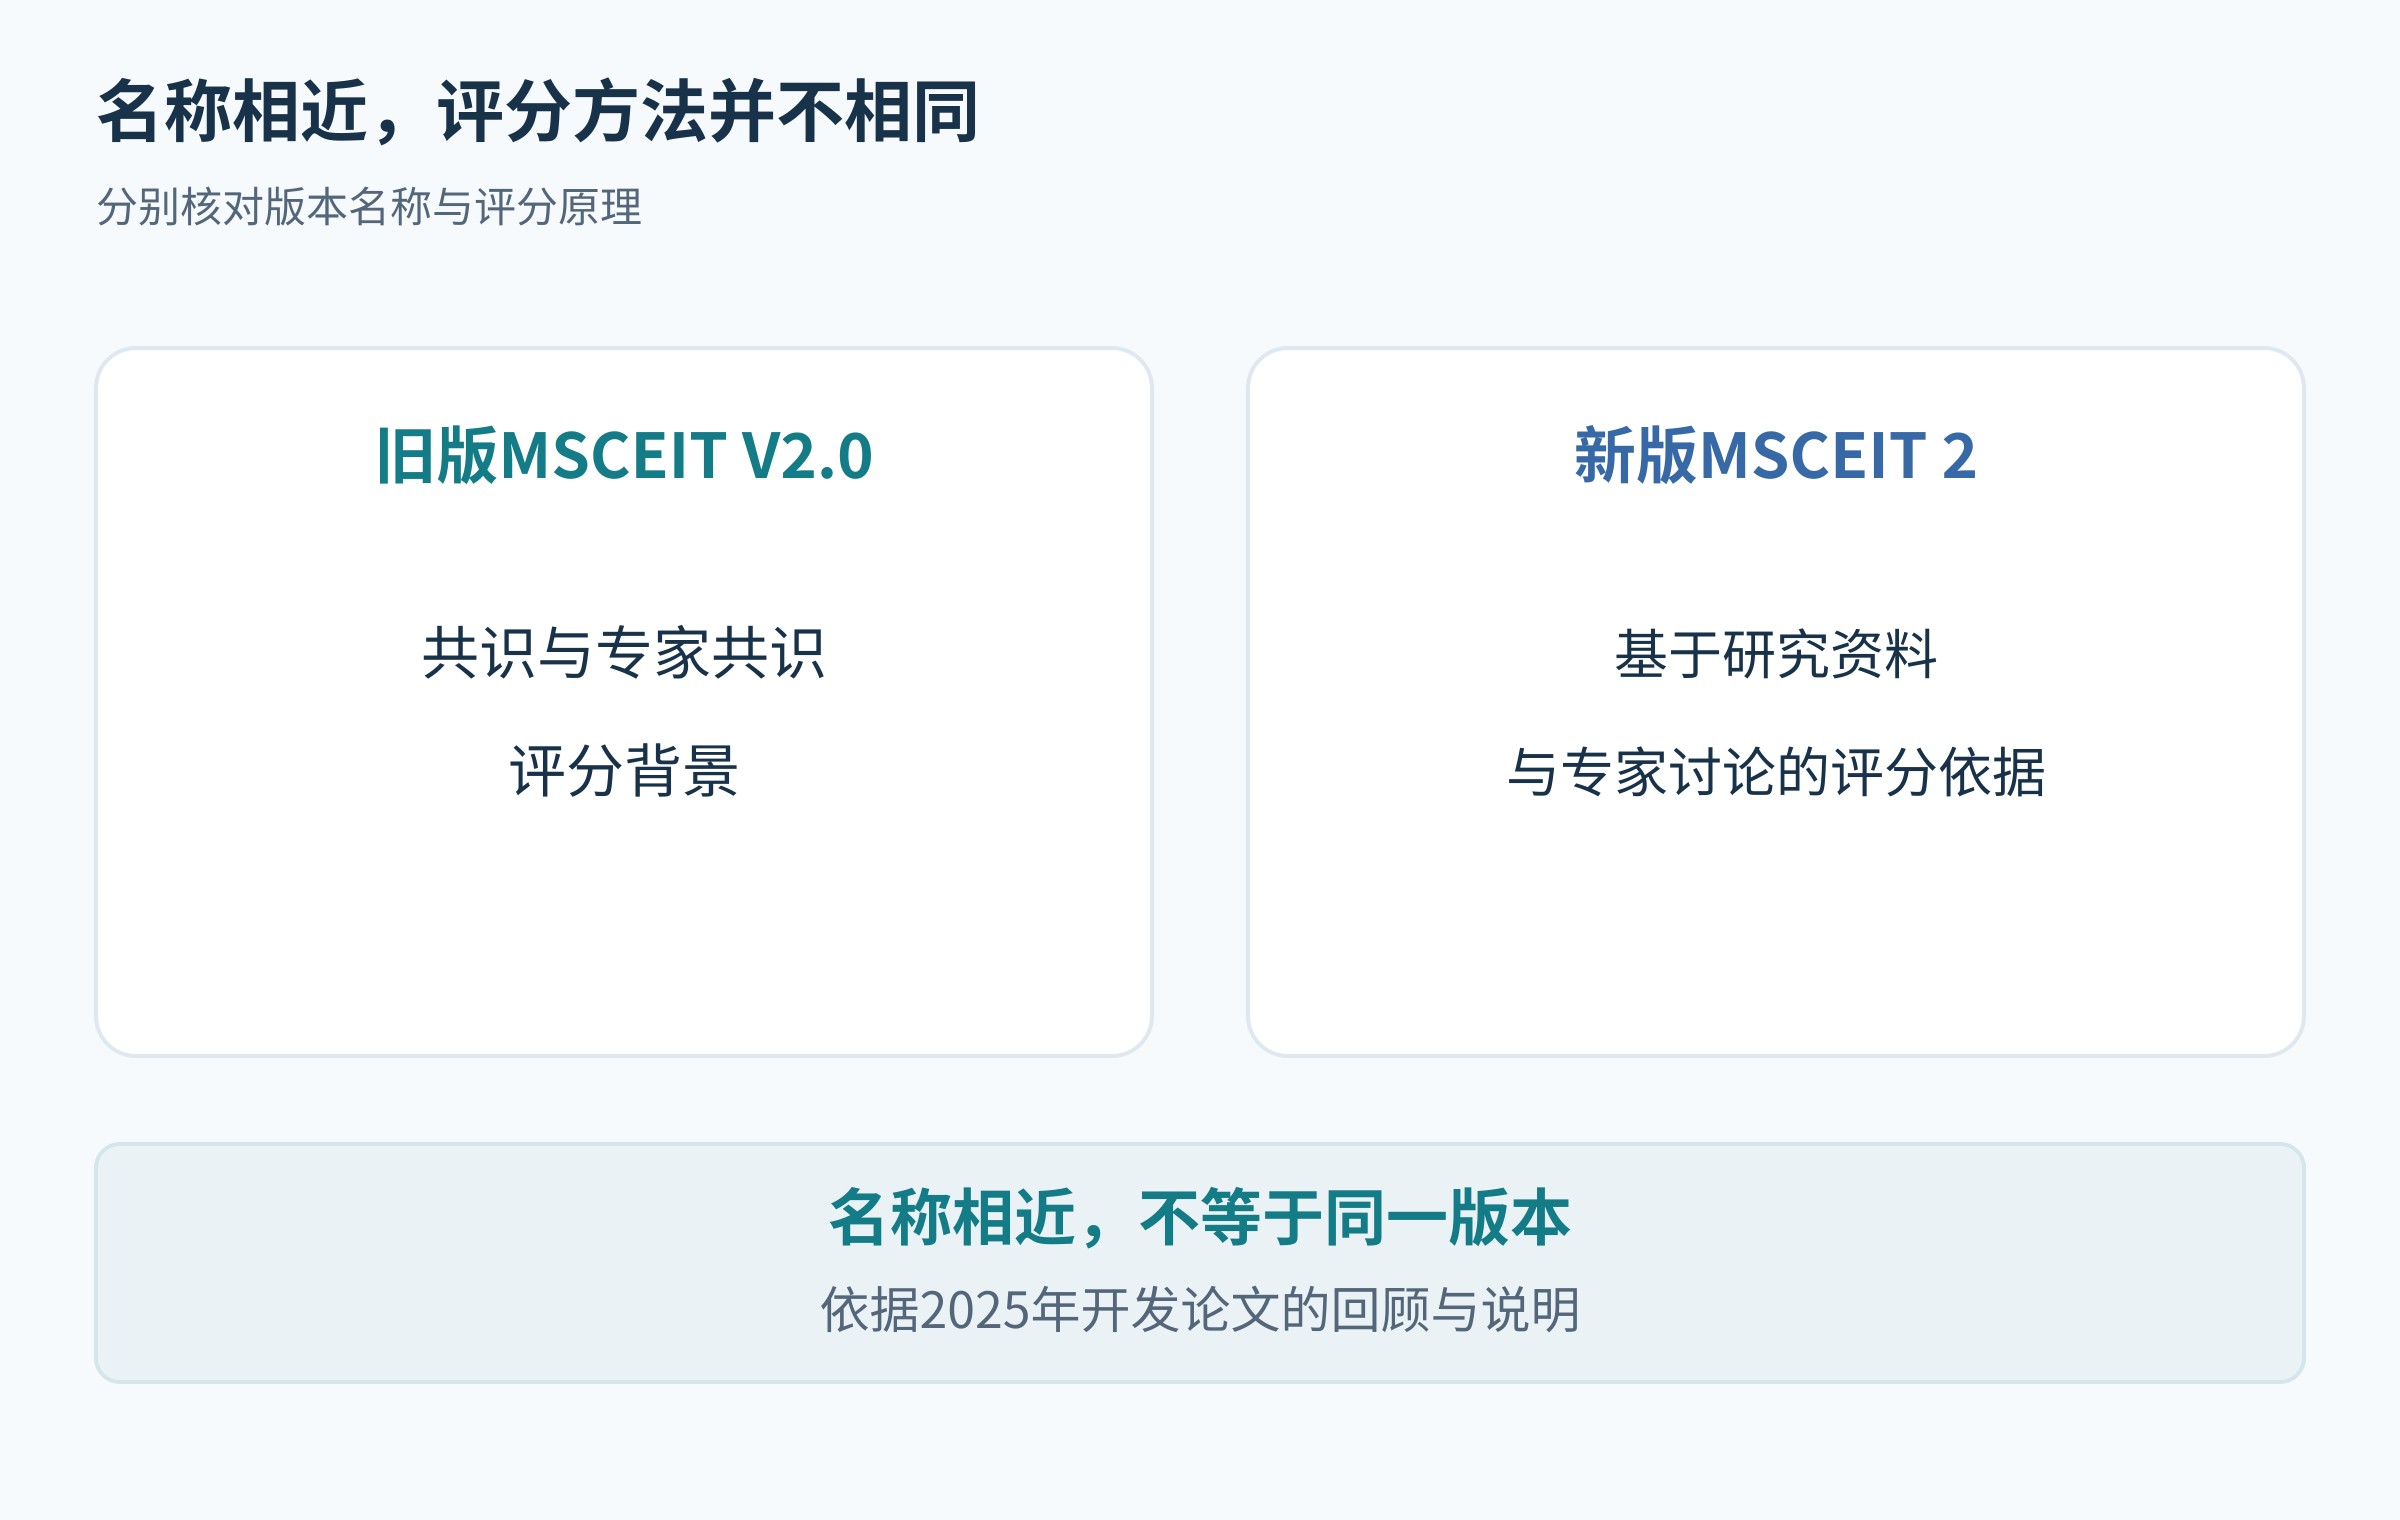
新版更强调研究证据与专家共同讨论
MSCEIT 2的开发论文将其方法称为veridical scoring。文中描述的流程包括依据情绪研究开发材料,让相关领域专家参考研究资料、讨论解释分歧,并据此形成评分依据;不能达成一致的有问题项目会被剔除。[1]
这里的“专家”不只是在互不讨论的情况下各自投票,研究证据与项目解释本身都进入了过程。之后还需要通过样本研究检验项目和分数的测量性质。专家参与是方法的一部分,并不能取代实证检验。
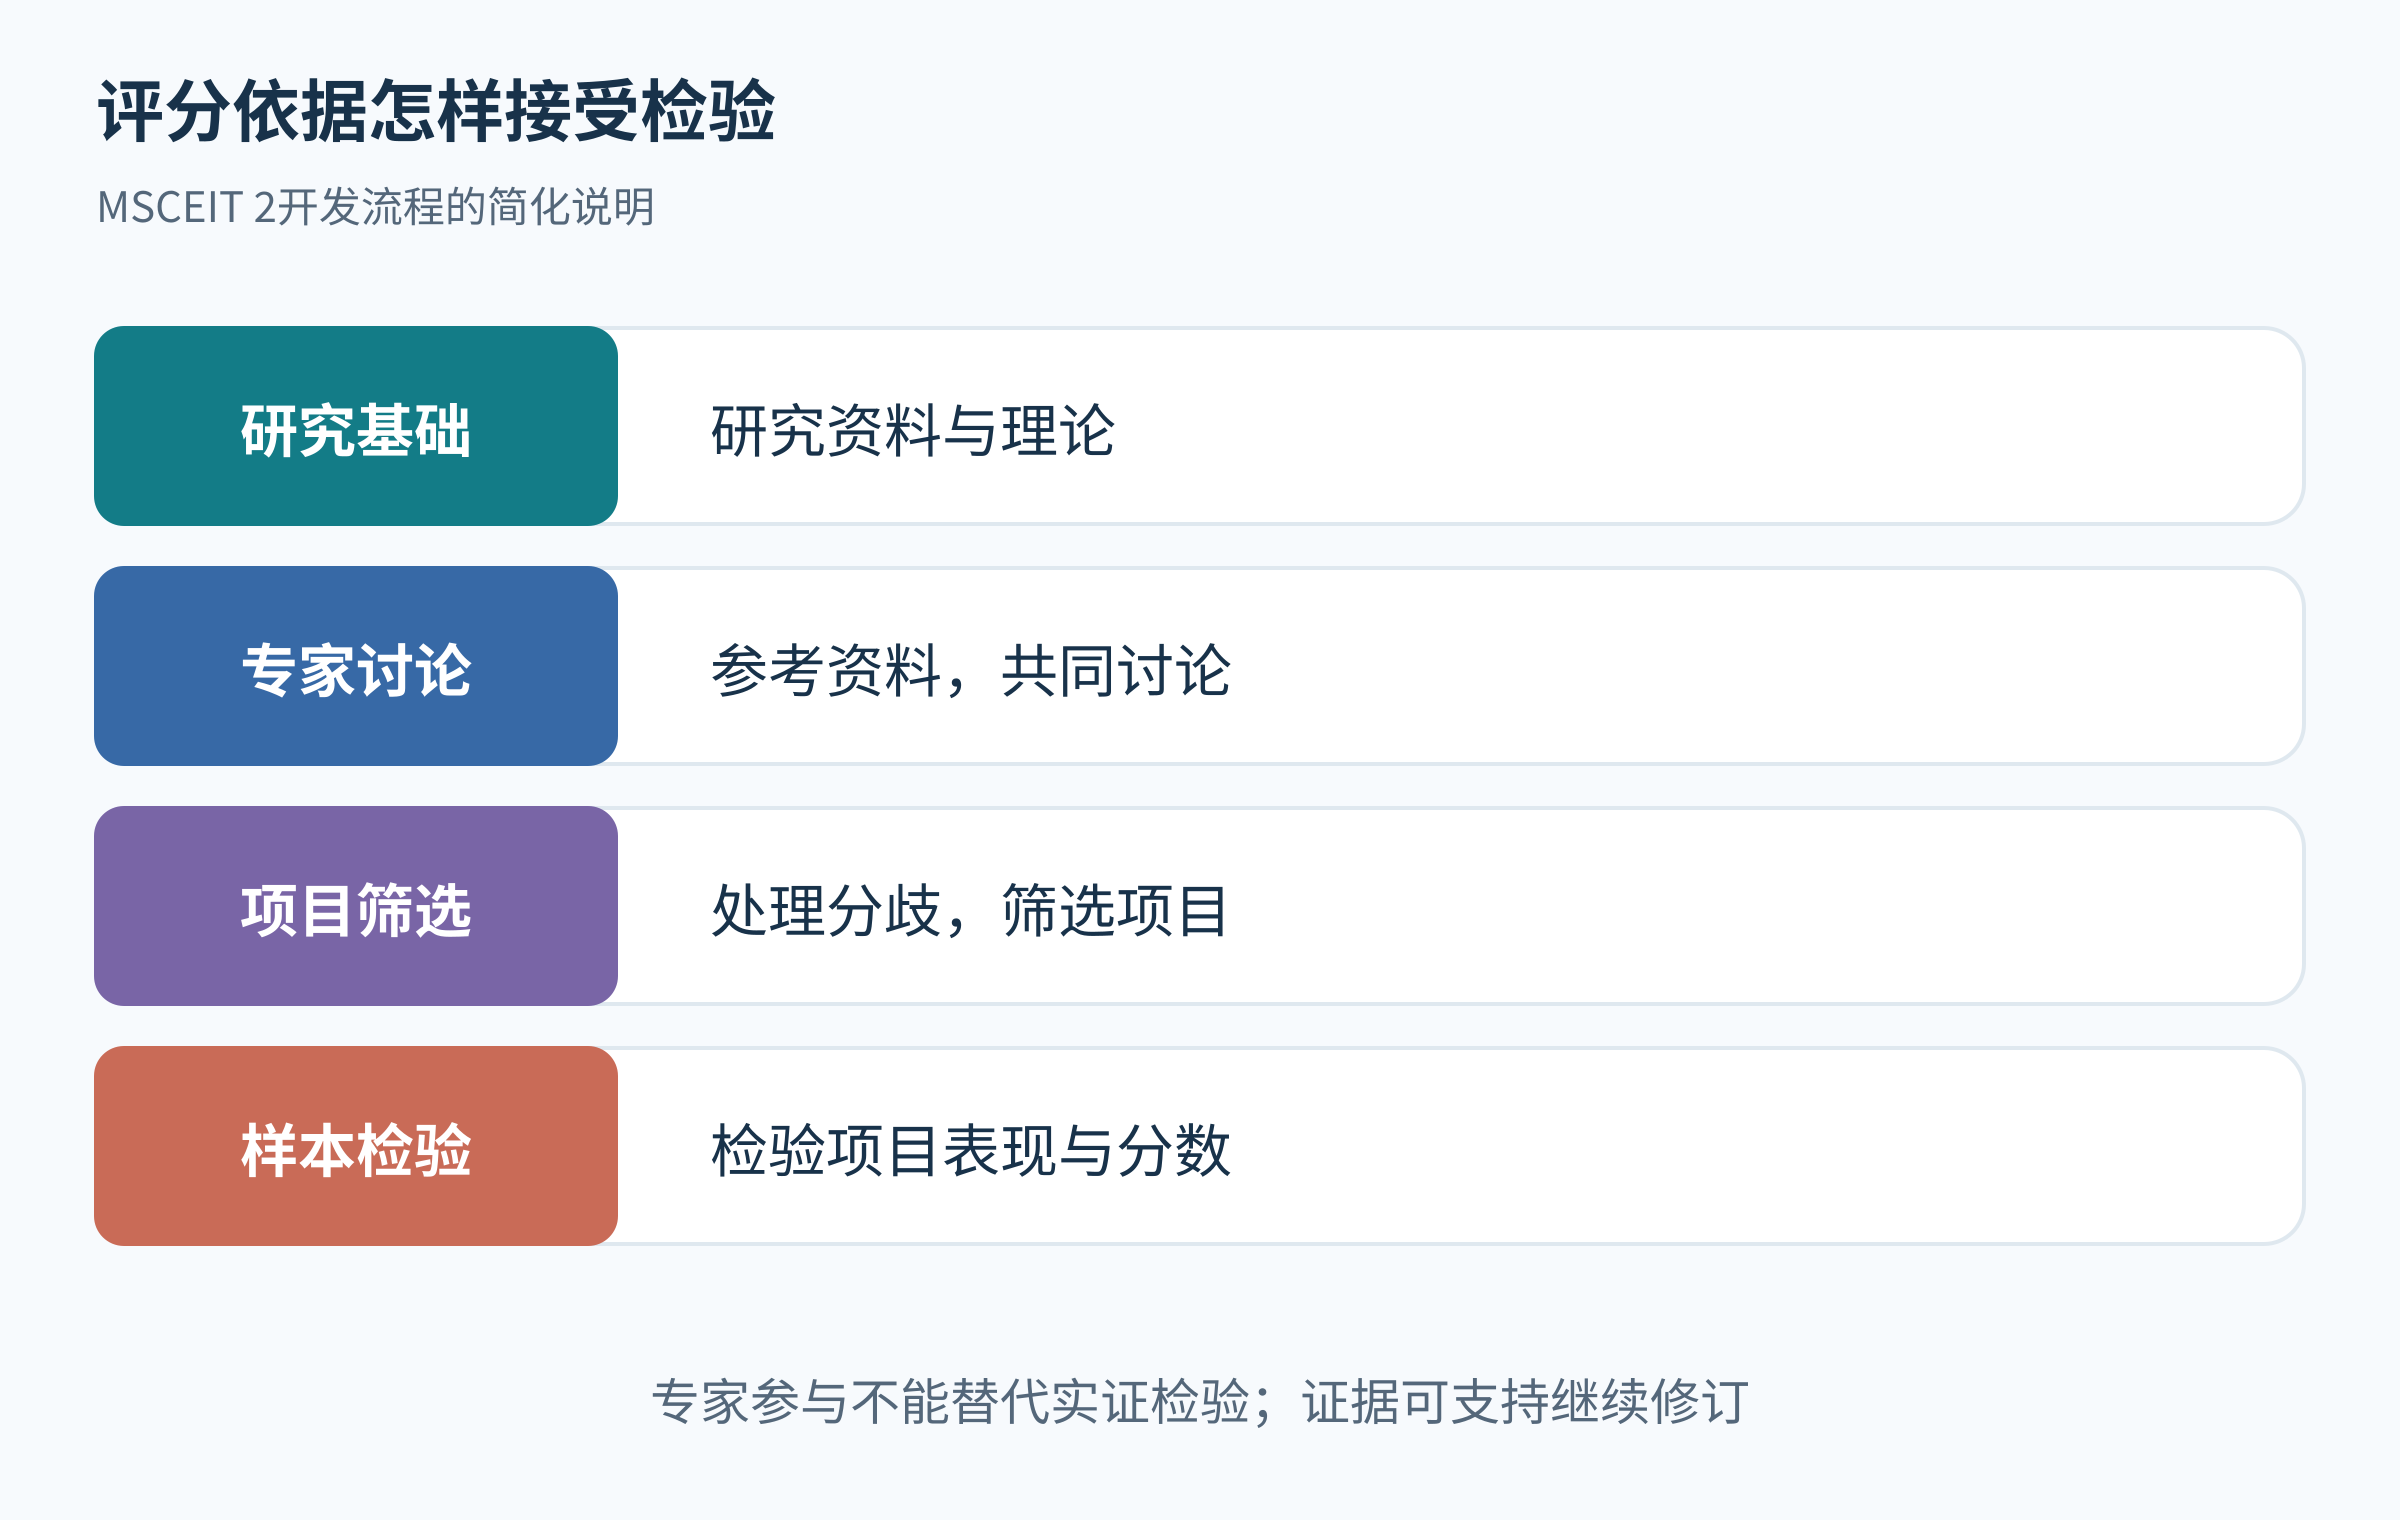
有评分依据,仍然有解释边界
首先,测验只抽取了一部分情绪相关任务。一个分数无法穷尽人在所有关系、压力和文化情境中的表现。其次,总体分数与各领域分数的精度可能不同,阅读报告不能把每个细小起伏都当作确定的长短处。
新版原始研究报告了初步的结构与可靠性等证据,同时也显示不同领域的测量表现并不完全一致。介绍这些结果时,应保留“具体版本、具体样本和初步验证”的范围,不能变成“情商已经可以被无误差地测出来”。[1]
语言翻译与跨文化使用也需要另有适用依据。新版英文工具的开发论文,不能自动证明某个网络中文问卷就是它的正式版本,更不能替代中文人群的验证。
对普通读者,最有用的是问清这三点
做的是自评还是表现任务?采用哪个版本及评分规则?这份分数准备解释什么、有哪些限制?如果提供方只说“国际标准情商”,却说不清这些信息,先把具体来源补齐,再判断结果的价值。
不必为了得到高分寻找流传答案。熟悉正式项目会改变测量条件,也可能让结果失去原来的解释基础。更值得做的,是在真实互动中核对感受、理解情境,再把专业测评作为其中一种有限的信息来源。