

课题组把心理测评结果导成Excel发给统计人员,对方却问:“同一个编号为什么有两行?这里的0是没有症状,还是没有作答?Q3已经反向计分了吗?”这些问题不解决,即使文件顺利导入统计软件,也可能分析了另一种含义的数据。
交付前,项目执行人与统计人员应先约定记录单位、字段含义和缺失表示方法,再用少量合成记录试一次导入。最终交出的不仅是分数,还有足够解释分数来源的说明。
一行记录什么,先写在文件说明里
对需要复测的研究,一种可用的交付结构是:一行对应一名参与者在一次测评中完成的一份指定版本问卷。人员编号用于连接同一个人,测评记录编号用于区别每次记录;轮次、工具版本和作答时间各自占列。
这样,同一个人出现两行可能是两次正常测评,不能按人员编号直接删除“重复项”。同一轮确实做了两次,也要保留记录编号和项目确定的选取说明,不能由统计人员凭行的先后决定留哪次。
下面是完全合成的教学数据。Q1、Q2是虚构的两道演示题,选项编码均为0、1、2;演示合计仅在两题都有回答时相加,不代表任何真实心理量表,也没有筛查或诊断意义。“空”只为网页阅读标出,实际文件按双方约定使用真正空单元格。
| 人员编号 | 记录编号 | 轮次 | Q1原始编码 | Q2原始编码 | Q2缺失原因 | 演示合计 |
|---|---|---|---|---|---|---|
| SYN01 | R001 | T0 | 0 | 0 | 无缺失 | 0 |
| SYN01 | R002 | T1 | 1 | 2 | 无缺失 | 3 |
| SYN02 | R003 | T0 | 1 | 空 | 未回答 | 空 |
| SYN02 | R004 | T1 | 2 | 1 | 无缺失 | 3 |
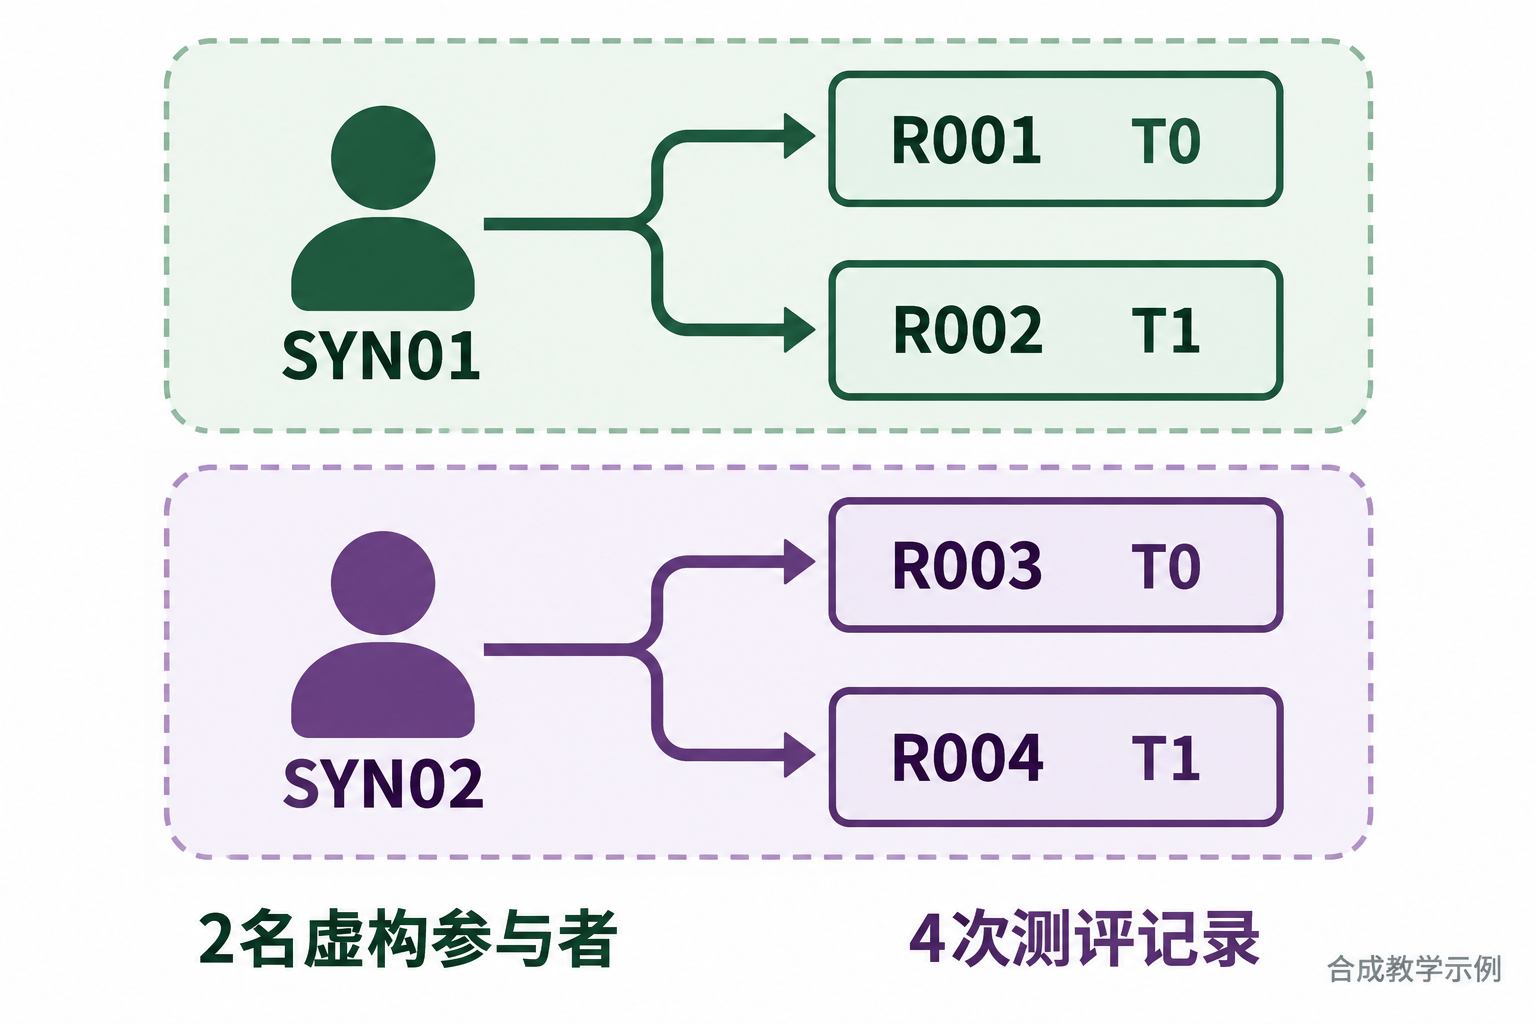
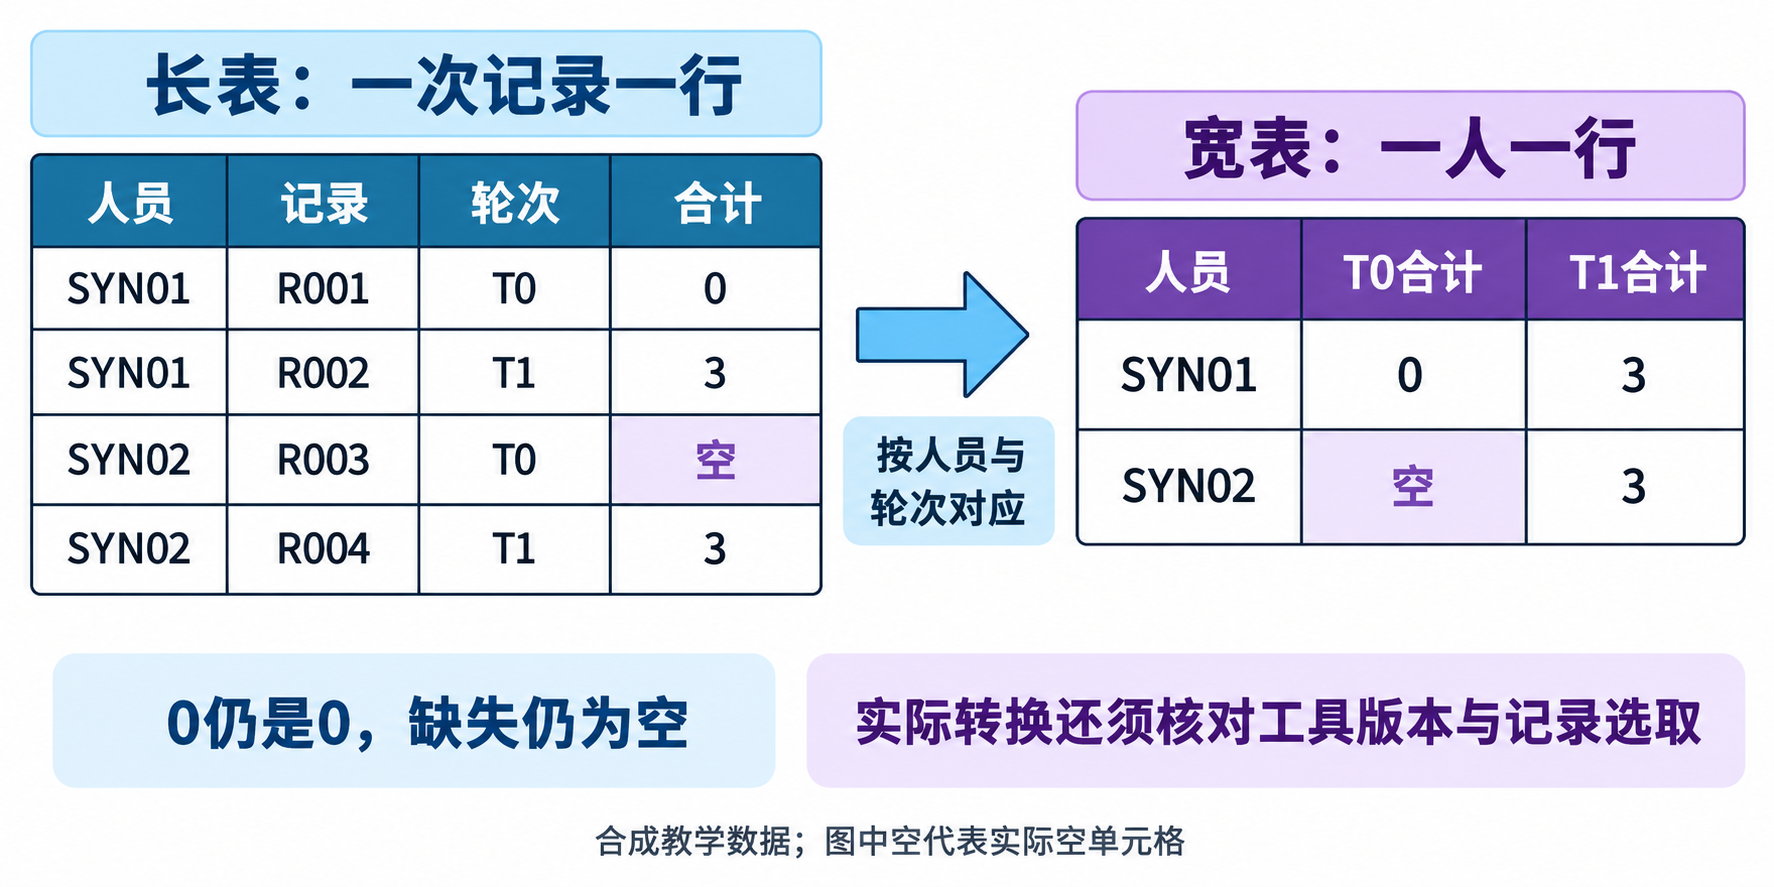
这四行对应两名虚构参与者、四次记录。R001的0是实际答案产生的数值,R003的空表示没有取得该题答案。把两者都变成0,就改变了观察结果。
真实文件还应列明工具名称、版本和必要的时间信息。上表为突出结构而省略这些列,不能直接当作完整研究数据模板。
字段名旁边,要有一份能独立阅读的字典
“Q1”“总分”“时间”都不够具体。变量字典至少应说明字段名称、含义、类型、允许取值、缺失表示及来源。比如,上表对应的字典可以写成:
- participant_id:文本型,项目内稳定的研究编号;同一人跨轮次保持一致,不填姓名或联系方式
- record_id:文本型,每次问卷记录的唯一编号;不能拿它代替人员编号做复测关联
- wave:文本型,T0为本例基线,T1为本例计划复测;真实项目应另说明时间窗口
- q1_raw:数值型,虚构题Q1的原始选项编码,0=从未、1=有时、2=经常;空值表示未取得答案。本例四条记录的Q1均有回答,没有Q1缺失;真实交付如出现Q1缺失,也应另列相应原因字段
- q2_raw:数值型,虚构题Q2的原始选项编码,0=从未、1=有时、2=经常;空值表示未取得答案,原因见q2_missing_reason
- q2_missing_reason:文本型,本例取“无缺失”或“未回答”;其他情况应先有定义,再增加编码
- demo_sum:数值型,本例Q1与Q2原始编码之和,范围0—4;任一题缺失则为空。这只是教学规则,不能用于真实量表
真实量表的字段说明应指向获准使用的问卷版本和题号,避免把题目正文无授权复制到公开附件。若编码1在一份表中表示“从未”,另一份表中表示“有时”,列名相同也不能直接合并。
UK Data Service的数据提交指导要求表格数据具有完整的变量和取值标签、明确的缺失码,并附数据字典;纵向数据还需要轮次标识及跨轮次变化说明。课题组可借鉴这套文档做法,把记录单位、编码和缺失规则随数据一起交出。
空值、未施测和未计分,不要挤进同一个0
除了漏答,研究中还可能出现某题未呈现、按规则跳过、某次未施测、数据尚未核清等情况。原因不同,后续可采用的处理也可能不同。先保存已知原因;不清楚的就标为“原因待核”,不要靠空白位置猜测。
缺失可以用空单元格配合原因列,也可以使用统计人员明确约定的特殊编码。若用99、999等代码,必须确认它不与合法取值冲突,并在导入时声明为缺失,不能让它进入均值或总分。CSV通常不会自动替读者保存这些解释,字典和导入说明要随文件一起走。
整轮未测与一份问卷漏答也应分开。如果SYN02根本没有参加T1,可能没有R004这条测评记录;这时需要另附最小必要的轮次状态资料,或按预先约定的结构表示“该轮无观测”,不能临时造一份全0问卷。
电子问卷要求必填,只能减少某些空题,不能保证回答真实、认真或适用于研究。真实量表是否允许缺题计分、怎样处理缺失,需遵循相应工具说明与研究方案;数据交付人员不应自行用均分填补,再把它当原始答案交出。
原始答案与派生分数,各自保留身份
题目列中出现数字,并不意味着它就是原始选项。有的软件导出选项代码,有的导出题目得分,还有的只导出维度分或总分。对于反向题,已转换的题目得分若被再次反向处理,就会改变结果。
交付时,建议用明确名称区分原始答案、题目计分值、维度分、总分及标准化结果。若分析确实需要这些字段且已获授权,分别列出;若只交付总分,也要说明总分类型、适用版本、来源和计分规则依据,不能让接收者误以为还可以复原逐题回答。
SDQ开发方的SDQadmin指南提供了一个真实例子:导出说明区分报告标识、开始与完成时间、报告者前缀、总分和分量表字段;逐题数据需要选择Full,完整导出变量另有代码说明。因此,交付前应核对实际选择的导出范围,并随文件附上对应字段说明。
若课题组另行生成派生变量,原导出文件应作为受控来源保留,分析副本另存,并记录转换步骤、使用规则及版本。只拿到总分时,原始答案应写“未交付”,不能反推或补造。
复测结构由分析需要决定,转换过程要能追溯
上面的逐次记录结构通常称为长表。统计人员可能需要转换成每人一行的宽表,例如分别放置T0总分与T1总分。两种结构都可以使用,关键是转换前确定人员标识、轮次、工具版本和记录选取规则。
只有编号和轮次相同,还不足以保证可以直接比较。若复测换了工具版本,或同一轮包含不同问卷,合并条件中就要保留这些区别。计划轮次与实际作答时间也应分别说明,不能把所有晚完成记录都当成按时复测。
转换后,核对人数、记录数和缺失情况是否保持预期关系,并保存转换说明。这里的检查是为了保证统计输入没有被改写;分数变化意味着什么、能否归因于干预,则是后续研究分析的问题。
先试交付,再收下整批数据
正式收数前,让统计人员用合成样例测试导入最省返工。重点检查编号是否保持文本、前导零是否丢失,日期与时间是否按约定读取,缺失码是否正确识别,原始字段和派生字段是否被混用。正式交付时再核对文件版本、行列范围与已知异常,并确认文件转换没有丢失信息。
一份可接收的材料通常包括:获准范围内的数据文件、变量字典,以及说明记录单位、研究轮次、处理过程和未解决问题的说明文档。可复用的整理脚本或操作记录也应留存。接收者应能凭这些材料解释R003为何没有合计,而不用翻聊天记录寻找答案。
科研用途并不意味着应把所有逐题答案、姓名、联系方式或咨询记录一并交出。只提供研究目的和授权范围内必要的字段,通过机构批准的方式交给获授权人员。研究编号与身份对应资料应分开保管;去掉姓名也不能承诺完全匿名,时间、稀有经历或其他字段的组合仍可能暴露身份。
如果准备使用橙星云承接测评组织工作,可以先把这份字段需求交给服务方逐项核对:哪些内容能从当前版本取得,哪些说明由课题组补充,哪些尚不能满足研究需要。实际字段、格式及交付安排需具体确认,不能从“能查看报告”推断为“能导出完整科研数据”。让统计人员在收数前参与这一步,往往比结题时再解释一张陌生表格更有效。