


做完题,除了记答案,再记一次有多大把握。把相似信心的题放到一起核对,才能看清自己的八成把握究竟值多少,也更容易把复查时间花在需要的地方。
八成把握要放到一组题里看
一道题选完答案,觉得八成能对。答案公布后,它只会是对或错;单凭这一题,没法判断“八成”估得准不准。信心校准看的是一组判断:长期把许多答案都标成 80% 时,其中答对的比例是否接近 80%。[1]
这也说明,标了 80% 的题偶尔答错很正常。更值得留意的是,积累一段时间后,你标 80% 的题只答对六成,或者已经答对九成以上。前者提示这一组信心偏高,后者提示信心偏低;结论要带着题目范围和样本数量一起看。
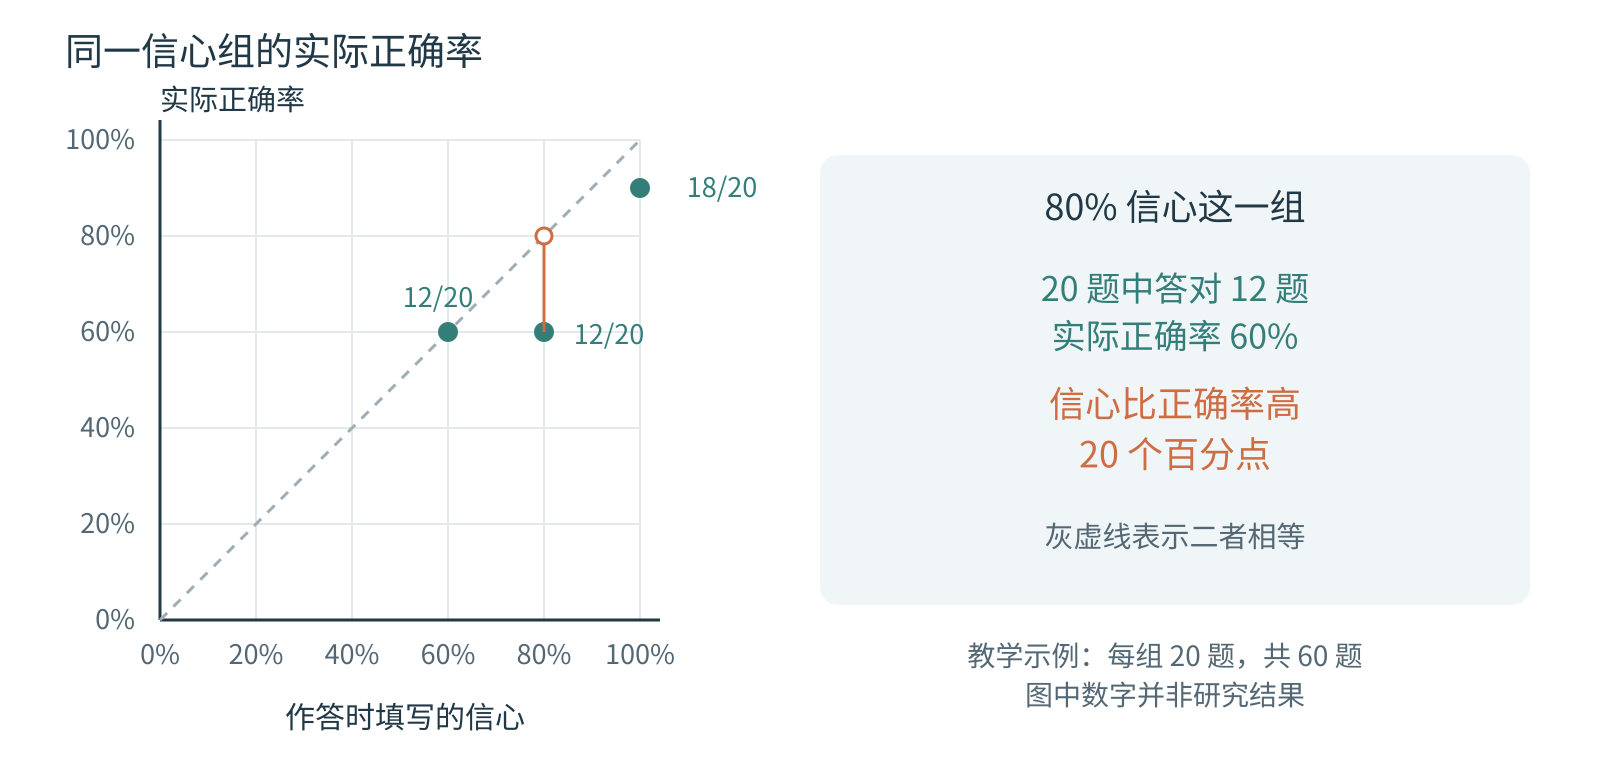
图 1 同一信心水平的题放在一起,才有可比较的实际正确率。数据为教学示例,不能据此推出任何人的能力或研究结论。
用手边的练习留下四列记录
从你正在做的练习里选一个范围,例如同一科目的题目。要求答案可可靠核对,能按同一规则判定对错。先别把开放式观点题混进来,也别急着把几门熟悉程度很不同的学科合在一起。
每做完一题,在看答案前留下四列记录:题目或题号、初答、答后信心、核对结果。最后一列暂时空着。把“好像会”换成一个你愿意承担其含义的百分比,如 60%、80% 或 90%;使用的刻度尽量一致。
填 80% 的意思是,假如有许多与你此刻把握相似的判断,你预计大约八成能答对。这个数说的是答案正确的可能性,与是否喜欢自己的答案无关,也不等于愿意花多少时间坚持它。
可以另留一栏,记下信心的来源,比如“能说清依据”“排除了其他选项”或“只是觉得熟悉”。这些标签不自动换算成分数;等到核对后,你可以观察哪些依据常常可靠,哪些只是让人感觉放心。
完成这一组,再用可靠答案填写结果。不要在公布答案后改写当时的把握;如果题目本身有歧义或答案出处不可靠,就先标记出来,暂不拿它计算校准。记录的目的是了解判断,不必为了让表格好看而回头修饰。
把信心分组再算正确率
积累同类记录后,把填写相同信心的题放到一起,分别数题目总数和答对数。不必等所有信心档位都填满再看,但要保留空档,也不要把做过的题反复作答,当成一批全新的判断。
图 1 的数据完全是教学示例:标 60% 的 20 题答对 12 题,标 80% 的 20 题也答对 12 题,标 100% 的 20 题答对 18 题。中间一组的正确率是 12 ÷ 20 = 60%,比填写的信心低 20 个百分点。图上落在对角线下方,表示这一组信心高于实际正确率。
记录时一起看每组有几题。某一组只有两三题,增减一道就会让比例大幅变动。也要把不同题型、难度和阶段分开留档,避免把一张漂亮的总表当成自己在所有事情上的判断力。[1][2]即使每组有20题,也只能作初步观察;看见的差距仍可能包含抽样波动。
答得准和知道哪题更可能错有区别
正确率回答“总共对了多少”;校准回答“报出的把握和实际结果是否相称”;分辨力关心“较有把握的答案是否确实更容易答对”。这几个问题相关,却不能互相代替。[1]
例如,一个人在某类题上长期对八成,所有题都统一填 80%,整体可以校准得不错,却没有用信心把更容易错的题挑出来。要安排复查,既要看百分比是否实在,也要看不同信心组之间有没有可用的差别。
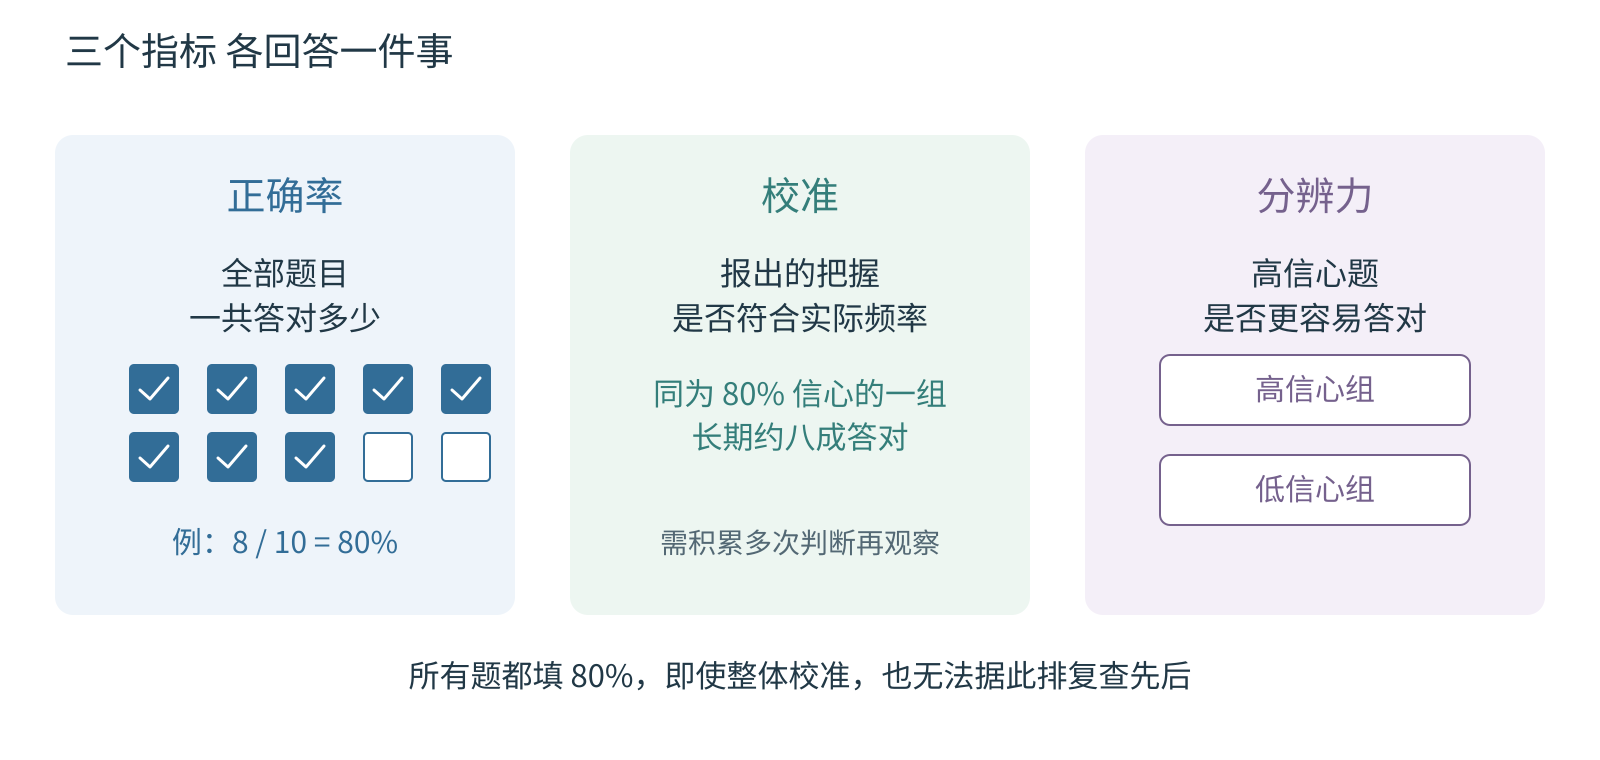
图 2 高正确率、良好校准和可用的分辨力是不同信息。想决定先查哪题,还需要知道信心能否区分相对容易出错的答案。
复查时给信心一个具体任务
如果过去记录显示低信心题确实更容易错,在分值和检查成本接近时,可以优先复查这些题。但低信心也可能来自完全不会,反复盯着它未必有用;能重新计算、重读条件或核对出处的题,更容易通过检查得到新信息。重要后果的判断,也不宜只因自己很自信就省略核对。
复查时加一句“有什么具体条件会推翻我的答案”。Koriat 等人的实验中,要求参与者提出反对已选答案的理由,改善了信心判断的适当程度。[2] 这提供了一种检查方向,不保证每次都提分。保留初答和初始信心,再记复查后的答案,才能看清检查究竟有没有帮上忙。
参考文献
[2] Asher Koriat Sarah Lichtenstein and Baruch Fischhoff (1980). Reasons for Confidence.