
在网页上做完一组图形题,屏幕跳出“智商120”。这个数字能不能带去解释学习困难,或者证明自己适合某份工作?先别急着比较高低,值得先看的是:这份结果究竟经过了怎样的测量。
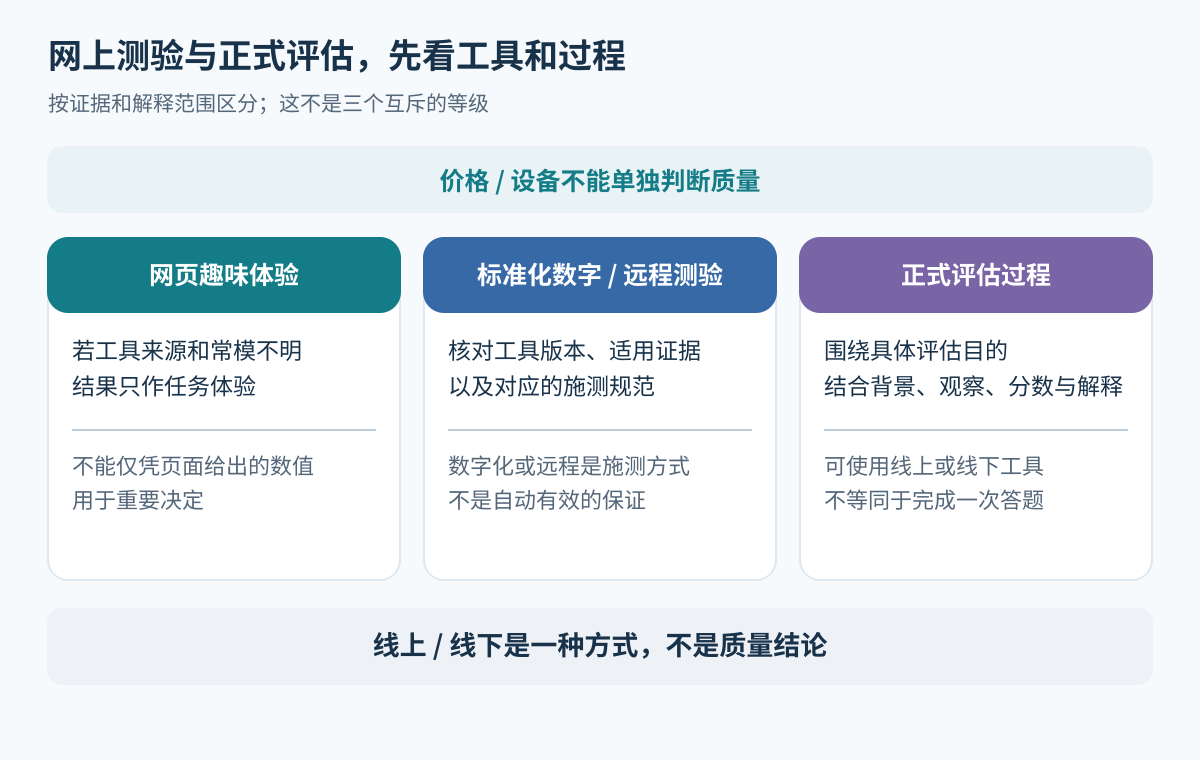
网上答题和正式评估之间,差别不只在于有没有去现场。收费、免费、手机、纸笔,都不能单独决定测验的质量。真正影响结果用途的,是工具来源、适用人群、施测条件,以及有没有把分数解释清楚。
先分清自己参加的是哪一种
有些网页提供的是图形游戏或趣味题,适合体验解题过程。如果没有工具名称、版本和常模说明,页面给出的“IQ”就缺少可以核对的依据。“超过90%的用户”也可能只描述参加该网站测试的人,不能直接理解成超过全国90%的同龄人。
另一类是有明确工具和程序的数字化测验。它可能在现场使用平板,也可能由专业人员远程主持。数字化描述的是呈现和记录方式,并不自动说明它属于娱乐,也不自动证明它与纸笔版等效。
正式智力评估通常还要回答一个具体问题:为什么来评估,想了解哪些能力,这次表现与日常情况怎样联系。测验分数之外,施测人员会根据目的收集相关背景、观察作答过程,并说明哪些结论有依据、哪些仍需其他信息。一次网页自动出分,未必包含这些工作。
远程施测也有条件,不能只看“支持视频”
以美国版本WAIS-5为例,出版方提供了远程施测指导,同时明确提醒:其常模数据来自面对面施测,远程方式偏离了原来的标准化情境,需要结合研究、专业判断和个体条件处理。官方说明中可用于远程情境的非运动指数,也不应被随意写成所有任务、所有分数都与现场完全相同。[1][2]
这说明远程测评可以有专业规范,但不能因为“有人视频看着”就认定有效。具体用哪个版本、怎样处理环境与设备限制、哪些分数可以解释,都要回到相应工具的说明。这里的国际版本示例,也不代表中国本土版本已有相同证据,更不代表任何平台已经提供这一服务。
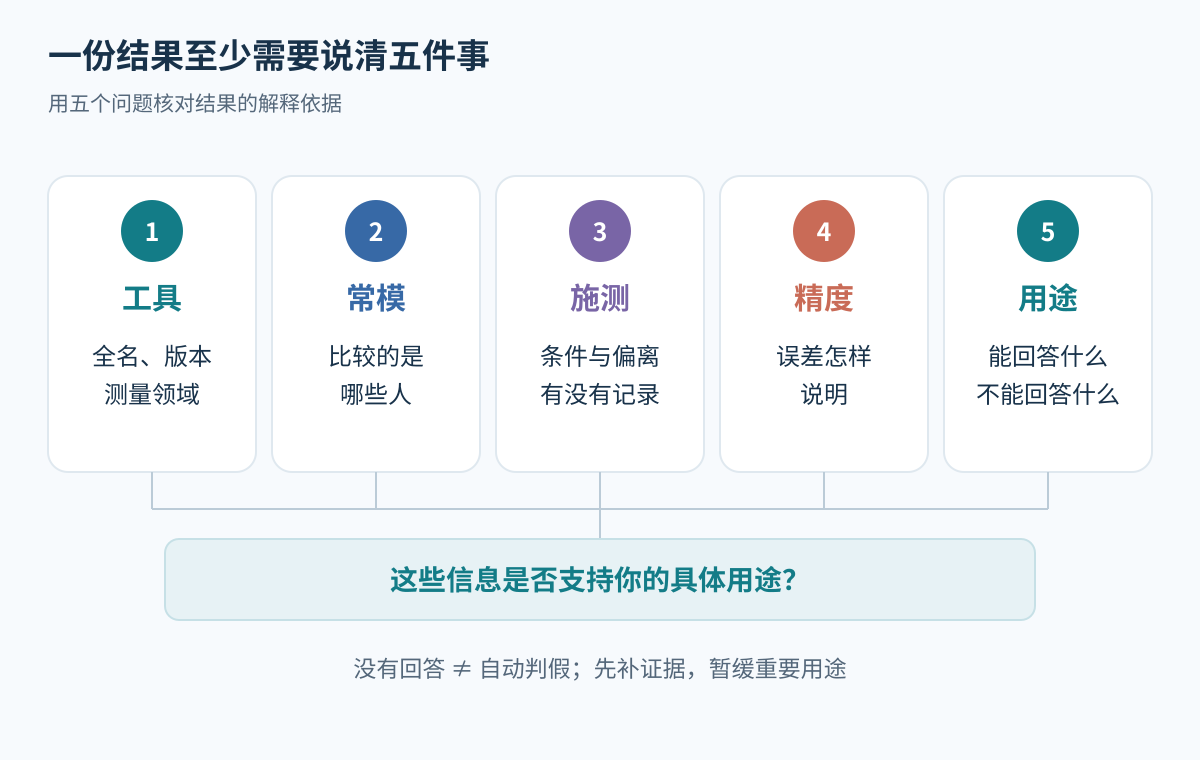
拿到分数前,可以问这五件事
- 测的是什么?请给出工具全名和版本,说明是图形推理,还是覆盖多个领域的综合认知测验。
- 与谁比较?常模的年龄、语言、地区及采集年代是否适合这次解释?“大数据用户”不等于具有代表性的常模。
- 怎样完成?指导语、时间要求、中断记录与协助规则是否清楚?是否把异常情况记入报告?
- 有多大不确定性?有没有误差说明、置信区间或其他与该工具相符的精度信息?
- 准备用来做什么?结果能回答哪个问题,由谁解释,哪些决定不能只靠这一个分数?
把结果放在与它相称的位置
如果只是好奇自己喜不喜欢推理题,可以把体验留在兴趣层面,不必把截图当作能力证明。若为了学习支持、转介评估或重要工作决定,就要提前说明用途,选择能够提供相应测量依据和专业解释的服务。
分数与日常表现明显不一致时,也先别连续刷新网页求一个满意结果。保留工具名称、测试日期、当时条件和原报告,向施测方询问差异可能来自哪里,会比再做十个不明来源的测试更有帮助。
无论分数高低,都不需要急着拿它定义自己或孩子。先弄清这一次测到了什么,再决定它值得参与多大分量的判断。