

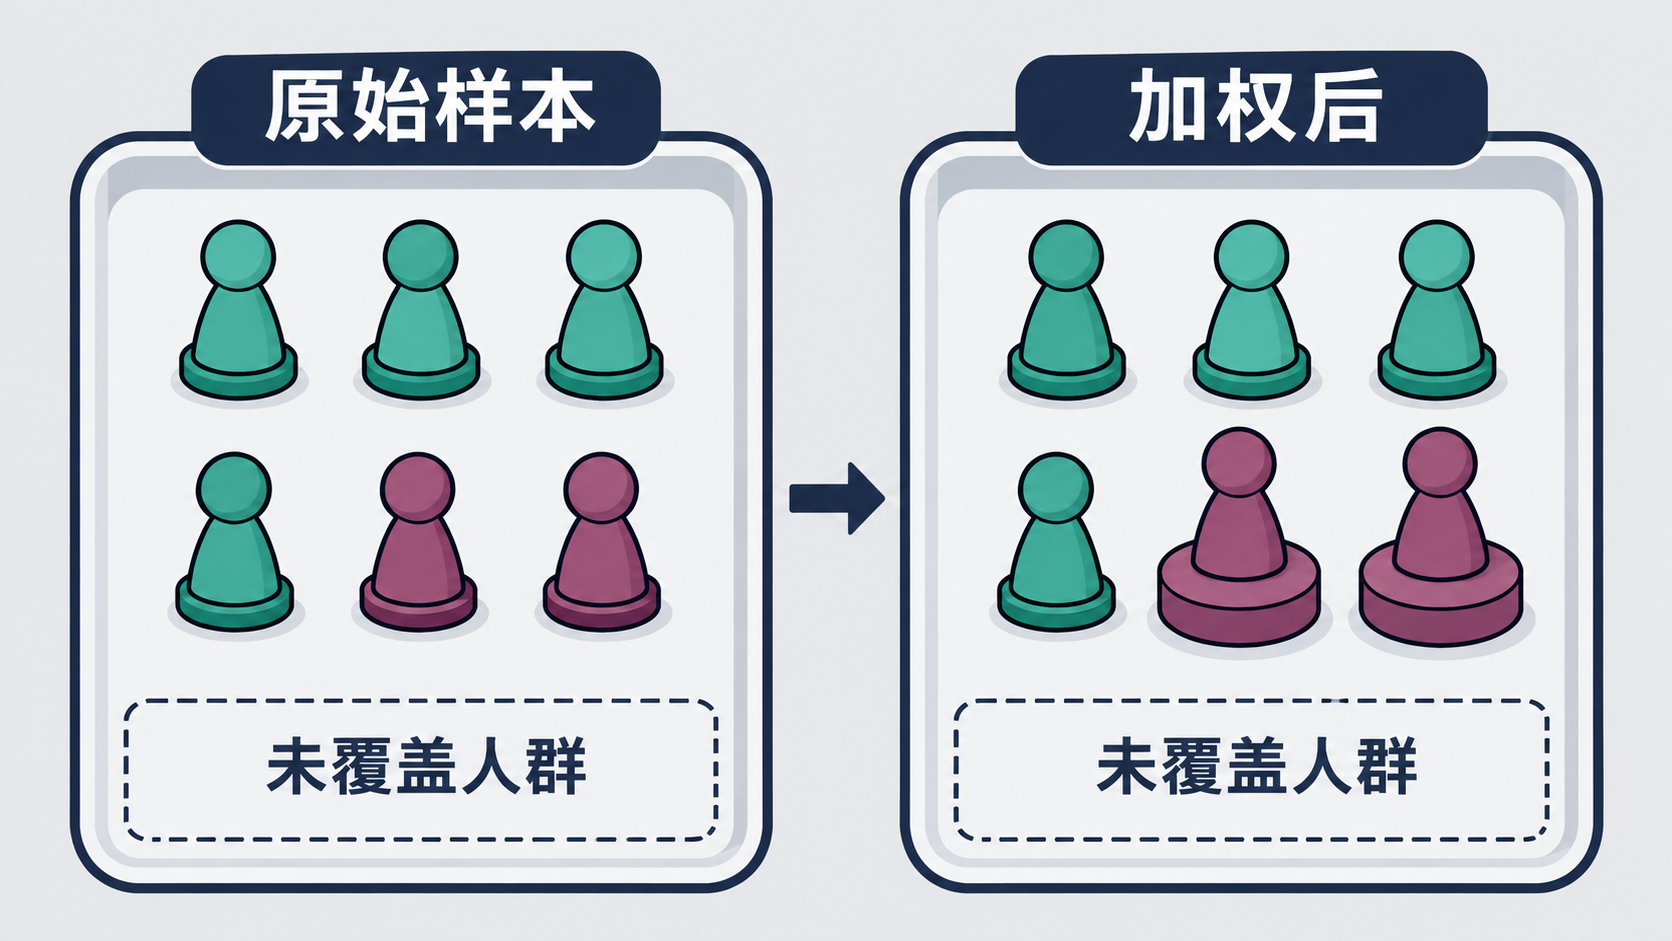
心理测评样本与目标人群不一致时,加权可以调整部分已观察到的比例差异,但不能凭空补出没有采到的人,也不能保证消除未观察到的选择偏差。是否值得加权,要先看缺的是比例、整类人群,还是决定谁来测评的关键信息。
同样说“样本偏了”,补救方法并不相同
假设一家机构想建立本地区在职成年人的参照资料,现有数据却来自主动预约心理服务的人。需要先问:目标究竟是全体在职成年人,还是本机构服务对象?两者的求助意愿、困难程度和获得服务的机会可能不同,不能只把年龄、性别比例调齐,就认为选择问题解决了。
下面用虚构情境说明三种不同缺口,不涉及任何真实机构数据。
| 发现的差异 | 可以考虑的处理 | 仍然不能保证什么 |
|---|---|---|
| 各年龄组都有样本,但比例与目标人群不同 | 核对可靠的人口资料,评估分层或校准加权 | 同年龄组内的求助者能代表所有人 |
| 目标包括夜班员工,样本中一个也没有 | 补充相应样本,或明确缩小使用范围 | 给白班员工加大权重就能代替夜班员工 |
| 相同年龄和岗位中,困扰较重者更愿意参与 | 研究选择机制,寻找相关辅助资料并做敏感性分析 | 只按年龄、岗位加权就消除了偏差 |
这一判断依据来自调查方法,而不是某个软件按钮。AAPOR的在线样本质量报告指出,调整后还剩多少选择偏差,与我们对入样过程及相关辅助变量了解多少有关。将这个原则用于心理测评服务数据,仍需核对具体人群和用途。
权重改变每条记录的贡献,不会增加真实观察
举一个仅用于解释的简化虚构例子:假设按居住区域分成城区组和乡镇组,目标人群中城区组占60%,现有样本中城区组占30%;乡镇组相应占40%和70%。在两组内部都具有适当代表性、分类口径一致等假设下,可让城区组记录的相对权重为2,乡镇组约为0.57,从而调整两组在汇总中的贡献。
这并没有让城区组多出新的受测者。原来没观察到的分数、经历和个体差异,依然没有观察到。如果某小组只有很少的人,却被赋予很大权重,少数记录就可能左右均值或分位位置。
Pew Research Center对加权方法的研究说明,权重差异过大可能增加估计的变异。因而报告不能只列原始样本总数,还要说明权重分布、估计的不确定性,以及与具体估计方法相适应的有效样本信息。一个漂亮的大样本数字,不能代替这些检查。
分层参照和加权参照,回答的问题也不同
若不同岗位确有足够样本,并且分组具有合理依据,可以考虑分别呈现岗位内的参照资料。但“分别报告”不会自动修复每组内部的选择偏差,小组过小还会让分位数不稳定。
若目标是描述整个地区的分布,加权汇总则需要可信的目标分布和成立的调整假设。两种结果可以各有用途,不必为了得到一个统一总表,把所有差异都揉在一起。它们也不能把一般参照分位转换成临床诊断阈值。
采用前,至少留下可回查的依据
可以把决定写成一份简短说明:数据来自谁,目标是谁,哪些人未覆盖;权重用哪些变量、参照哪一年的资料;极端权重如何处理;不加权、加权及合理替代方案下,关键分位是否明显改变。若结论对少数记录或某种处理方式非常敏感,应收窄解释,而不是只保留最顺眼的结果。
AAPOR的方法披露要求也强调说明覆盖范围和权重计算过程。对于心理测评云平台或管理系统中的历史数据,能计算权重只是技术环节;能否形成适用的参照,还取决于样本来源、测量一致性及验证。遇到整类人群缺失时,补充抽样或缩小用途,往往比继续调整权重更诚实。