

心理测评表里有几千行回答,统计结果就一定很有把握吗?如果学生来自若干班级、员工来自若干部门,还要知道这些人分成了多少组,以及同组回答之间有多大关联。一个班增加二十份问卷,与再增加一个来自不同环境的班级,带来的信息并不相同。
心理测评数据分析中的“组内相关”,讨论的是这些原本就存在的组织分组。它与根据分数把人重新聚成几类的聚类分析不同;班级、部门及其上层学校或单位,都是分析前就应保留的层级信息。
问题出在把相关的回答当成彼此独立
同组的人可能具有一些共同条件,导致在模型已经考虑解释变量之后,剩余误差仍有关联。如果计算标准误时仍假定每一行都独立,就可能低估估计结果的不确定性,使置信区间过窄、显著性检验过于乐观。Cameron与Miller的聚类稳健推断论文详细讨论了这种情况。
这里关心的是分析模型的误差结构。看到同班同学分数接近,可以提示检查层级,却不能仅凭这件事就判断需要怎样调整;加入哪些变量、准备估计哪一种关系,都会改变具体问题。也不能保证每一次采用聚类稳健方法,标准误都会比原来更大。
一个常用描述量是组内相关系数,简称ICC。在连续结果的两层随机截距模型中,它表示组间方差占组间与组内残差总方差的比例,也可理解为该模型下同组两个人结果的相关程度。这一定义依赖模型;加入解释变量后的ICC有了条件含义,不能把它当成题目内部一致性或重测信度。Stata官方ICC文档给出了相应定义。
一个小ICC,也可能影响大组的精度
下面只作假设算例,不代表班级心理数据的典型水平:共有30个组,每组20人,总计600人,假定ICC为0.10。在等组规模等简化条件下,针对简单均值精度的设计效应可近似写成“1+(每组人数-1)×ICC”,得到2.9。
用600除以2.9,得到约207的有效样本量。这里的“有效”只是说,在这组假设和相应估计下,均值精度大约相当于多少独立观测提供的信息;600份问卷仍然全部存在,没有删除任何人。Cochrane手册第23章以聚类试验为背景说明了这种设计效应和有效样本量的近似。
这条公式不能给所有心理数据分析统一打折。组规模不等、权重、分层、协变量和估计目标都会影响计算。回归中还要看解释变量在组内有多相似:某项安排如果对整个部门完全相同,其独立信息更依赖部门之间的差异。只看一个较低的总体ICC,就宣布可以忽略分组,仍可能漏掉重要问题。
先问要估计什么,再选处理层级的方法
如果研究关心某种总体平均关联,回归形式本身合适,但同组误差可能相关,可以考虑与设计相符的聚类稳健标准误。它主要调整系数的不确定性和统计推断,不会自动解释班级或部门之间的差异,也不能修复遗漏变量造成的偏差。
如果问题本来就包括“班级之间有多少差异”“个人层面的关系和班级层面的关系是否相同”,就需要明确表示这些层级。多层模型可以通过组层随机效应等设定描述层间变异,但结果依赖所设模型与假设。它与聚类稳健方法承担的任务不同,必要时也可以结合使用,无须把两者排成一条简单的升级路线。
例如,假设要分析学习负担与压力的关系。“同一班里,负担高于班级平均的学生是否压力更高”,与“平均负担更高的班级,平均压力是否更高”,是两个问题。若把两类差异混在一个斜率中,解释可能发生变化。Preacher等人的多层方法研究讨论了层内与层间成分混合所带来的解释问题。
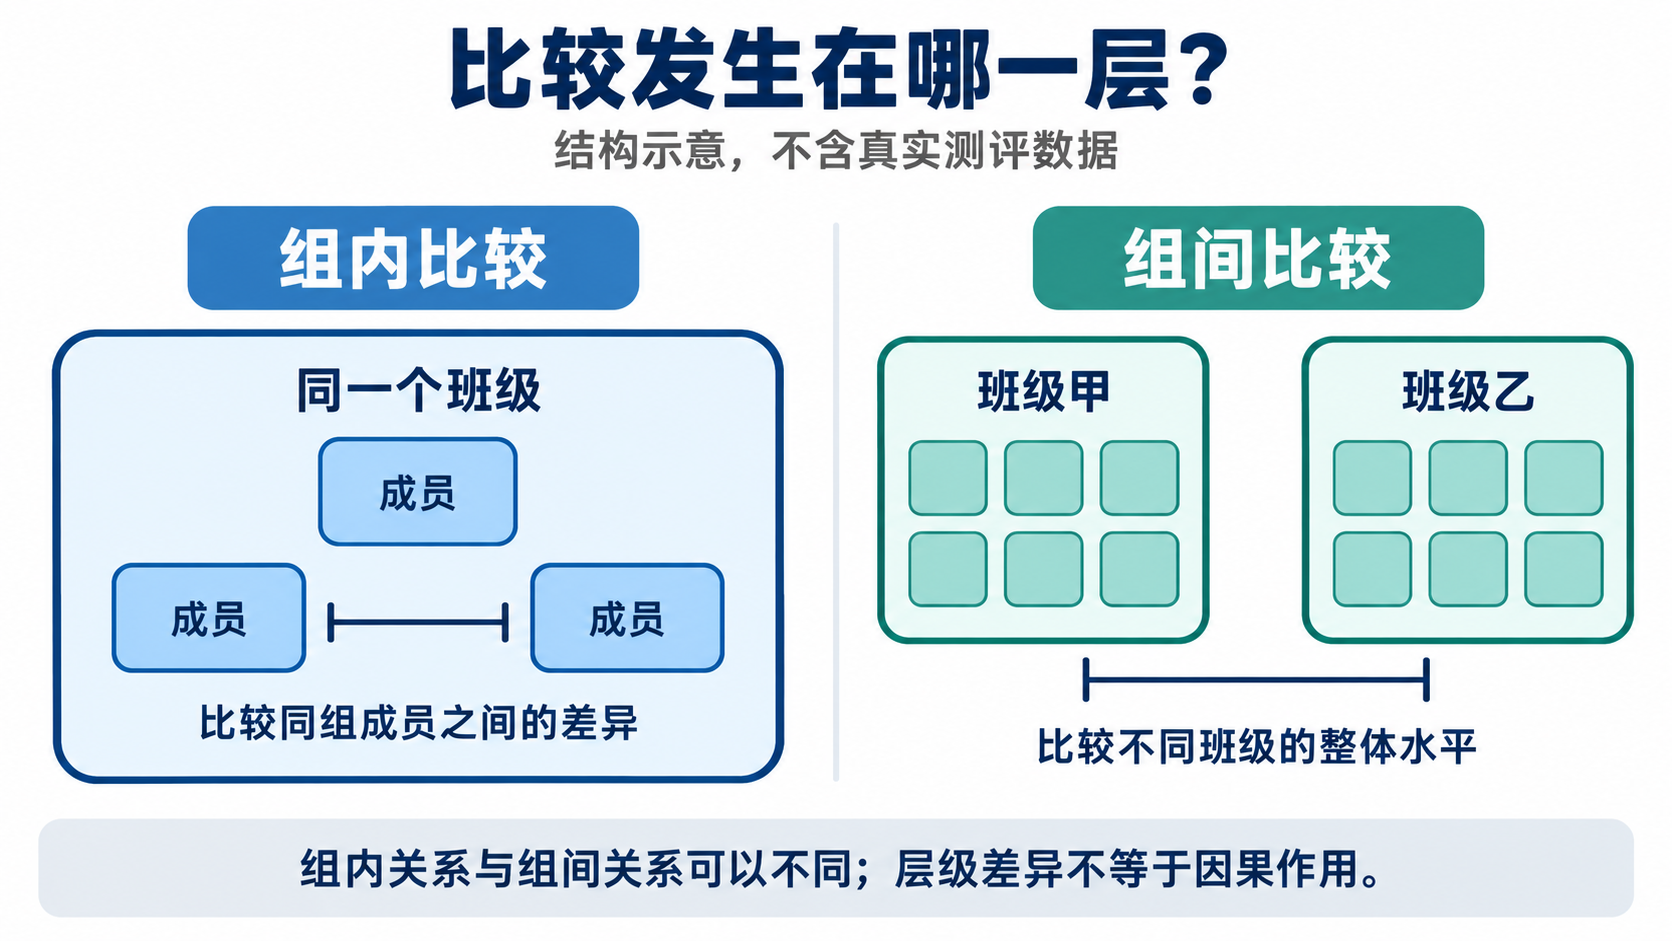
图示仅区分比较层级,不展示真实测评数据。组内关系与组间关系可以不同,识别出层级也不等于证明组织环境造成了心理差异。
报告人数时,同时交代组数与组规模
方法是否可信,还取决于有多少相互独立的组。常规聚类稳健推断依赖组数增加时的性质;只有少数部门时,每个部门再增加很多员工,也不能自动消除小组数推断的问题。组规模特别不均衡、某个组影响很大,或关键解释变量只在少数组中变化,都需要进一步评估适用方法。
因此,一份可解释的分析至少应交代人数、组数、组规模差异、使用的层级、估计目标及处理相关性的办法。组少时,应采用适合该情形的方法并如实表达不确定性;不存在某个组数一过就完全可靠的统一门槛。添加组别固定效应,也不能自动担保剩余误差已经独立。
班级或部门差异最后应当留在它的证据范围内。无论用了稳健标准误还是多层模型,组织成员的构成、未测量因素及其他解释仍可能存在。统计上识别出组间差异,可以推动进一步了解情况,不能直接给组织分配因果责任,更不能把组层系数变成每个成员的个人诊断。