
几条上下滑动的纯音,初听可能像电子哨声;知道对应的语句后,同一段声音却可能变得可懂。正弦波语音把一个问题显了出来:声音送来的信息,与听者已经知道的内容,怎样共同参与理解?
声音没换 听起来却可能有了词句
听一段陌生音频时,如果只能听见几条忽高忽低的哨音,很难想象里面藏着一句话。接着听它对应的清晰原声,再回到刚才的版本,原先分散的音调却可能像连成了词句。这种变化见于正弦波语音研究,前后播放的简化信号可以完全相同。[1][2]
值得比较的细节是:哨音的奇怪音色未必消失,语言内容却可能变得容易辨认。“听起来像不像真人”与“能不能知道他说了什么”,并不总是同一个判断。[1]
三条纯音保留了什么
说话时,声道的形状不断变化,会加强某些频率附近的能量,形成共振峰。经典正弦波语音取出原声中前三个共振峰的中心频率及幅度变化,再用三条随时间变化的纯音去近似它们。[1][4]
这里的“三条”指同时变化的三个声学分量,并非三个音节,也不是三个固定音高。它们随着原句的发音过程上升、下降和改变强弱。自然嗓音中的许多细节被移除了,留下的变化关系仍能支持部分语言识别。[1][4]
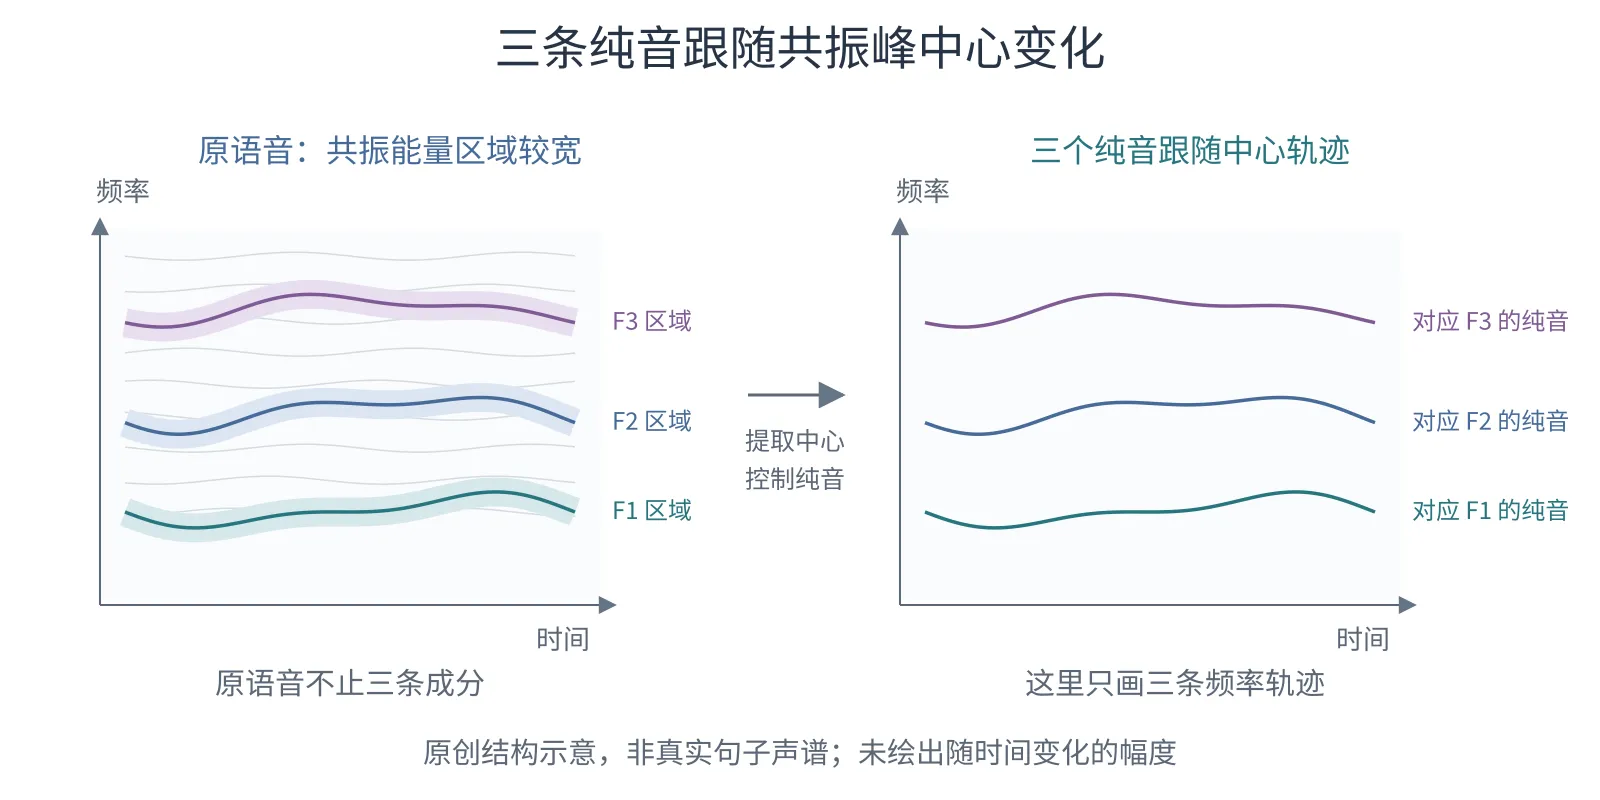
图 1 原语音的共振峰中心频率可用于合成三条随时间变化的纯音。此图为原创结构示意,不是真实句子的声谱,也不能用来播放语音。
图 1 把这个过程画成频率随时间变化的轨迹。曲线的位置表示频率高低,不代表嘴巴移动的路线;原声中的宽带共振结构与合成后的窄纯音,也需要分开看。
知道它是语音和知道原句各提供了什么
Remez 等人 1981 年的实验给不同组听者不同的指令。有的组只报告第一印象,有的组被告知会听到电脑生成的句子并尝试写下来,还有的组事先获知目标句、再判断能否辨认。听者得到的线索不同,报告也随之改变。[1] 这些组间比较不能直接写成每个人都经历了相同的前后转变。
后续研究也使用了更直观的顺序:先听正弦波句子,再听清晰原句,最后重听相同的正弦波版本。Khoshkhoo 等人在皮层记录研究中采用这种安排,观察到原先未能理解的参与者在接触清晰版本后能够理解。[2]
清晰原句给听者提供了一个可以对照的言语模式。接下来,几处声音变化可能被组织成音节和词语。这个解释同时需要声学结构与已有知识;不能由此推出,给任何随机哨声配上一句文字,都能得到同样的识别结果。
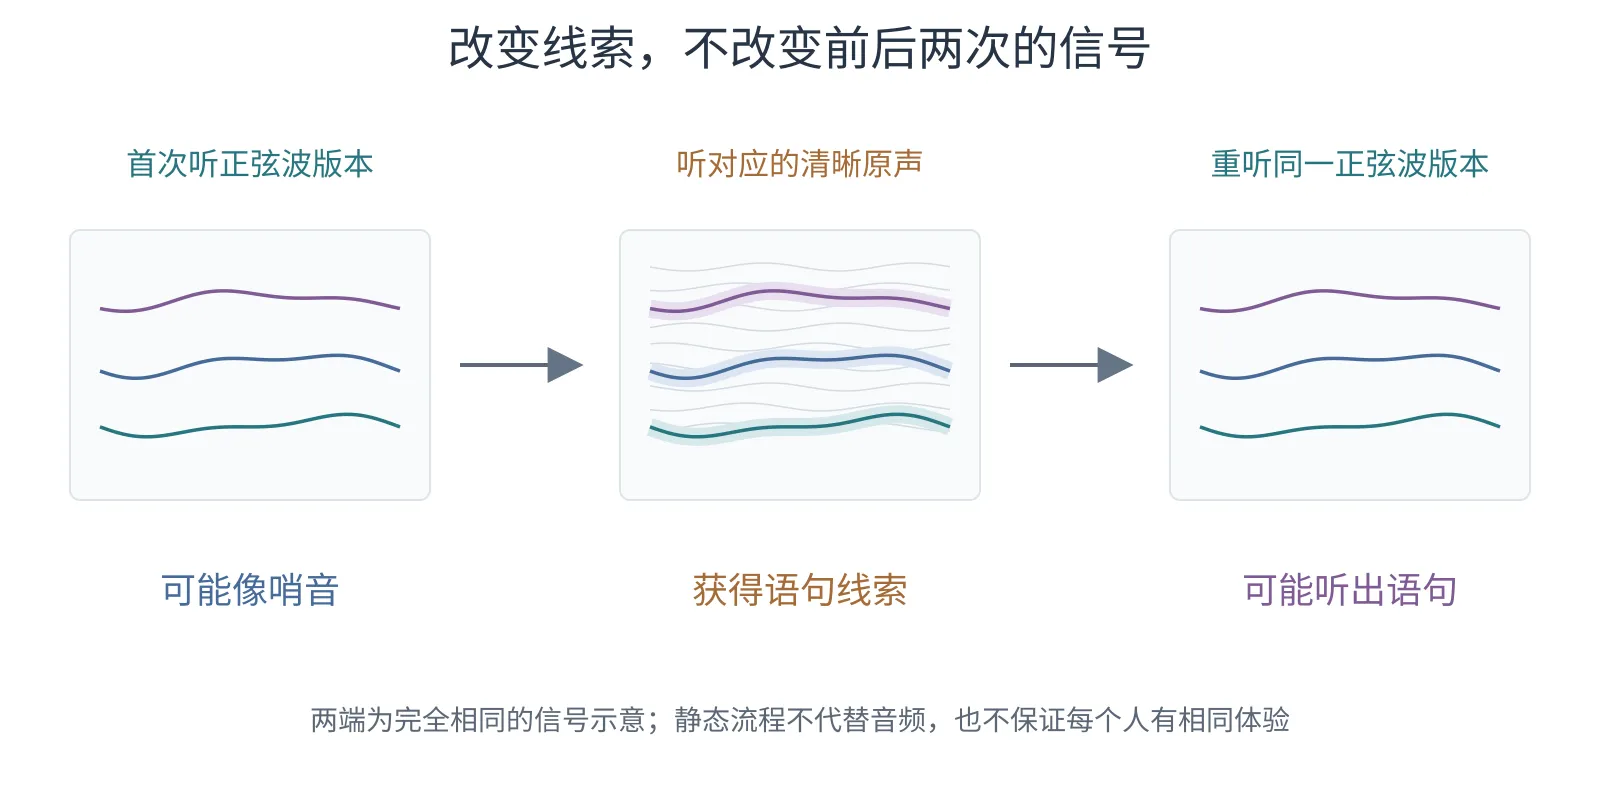
图 2 先听清晰原声,再回到同一正弦波版本,可以比较线索前后的理解。两端图形完全相同;它表示任务顺序,不是实际音频或人人都会出现的结果。
这种转变并非人人都一样
Möttönen 等人使用两种经过正弦波处理的无意义语音串,让 21 名参与者先把它们当作不同声音分类,再提供语音说明和自然原声配对练习。练习后,16 人报告把相同信号听成了语音,另外 5 人仍把它们听作非语音。[3]
这项研究说明,同样的物理输入可以对应不同的知觉方式,也提醒我们,出现转变的比例与材料和任务有关。短语音串的分类、整句的听写、觉得“像有人说话”,各自回答不同的问题,不能一概称为听懂了全部内容。
体验时先确认回放的是同一个版本
Haskins Laboratories 的官方演示页提供配套的 Sinewave 与 Natural 音频。可以用舒适音量,比较正弦波版本、自然原声,再回放原来的正弦波版本。[4] 页面同时展示原句,提前看过文字后,首次试听便已经带有内容线索。
材料是英语,清晰版本本身能否听懂也会影响体验。可以留意两件事:声音的音色是否仍像哨音,以及能辨认出的词句是否改变。不要仅凭一次体验给自己的听力或语言能力打分。
两张静态图只能说明结构与比较顺序。正弦波语音最有意思的地方,在于听懂一句话既依赖声音中保留的变化,也与听者怎样解释这些变化有关;文件不变,理解仍可能不同。
参考文献
[4] Haskins Laboratories; Philip Rubin (未标年). Demos: Sinewave Synthesis: Tone Combinations.