

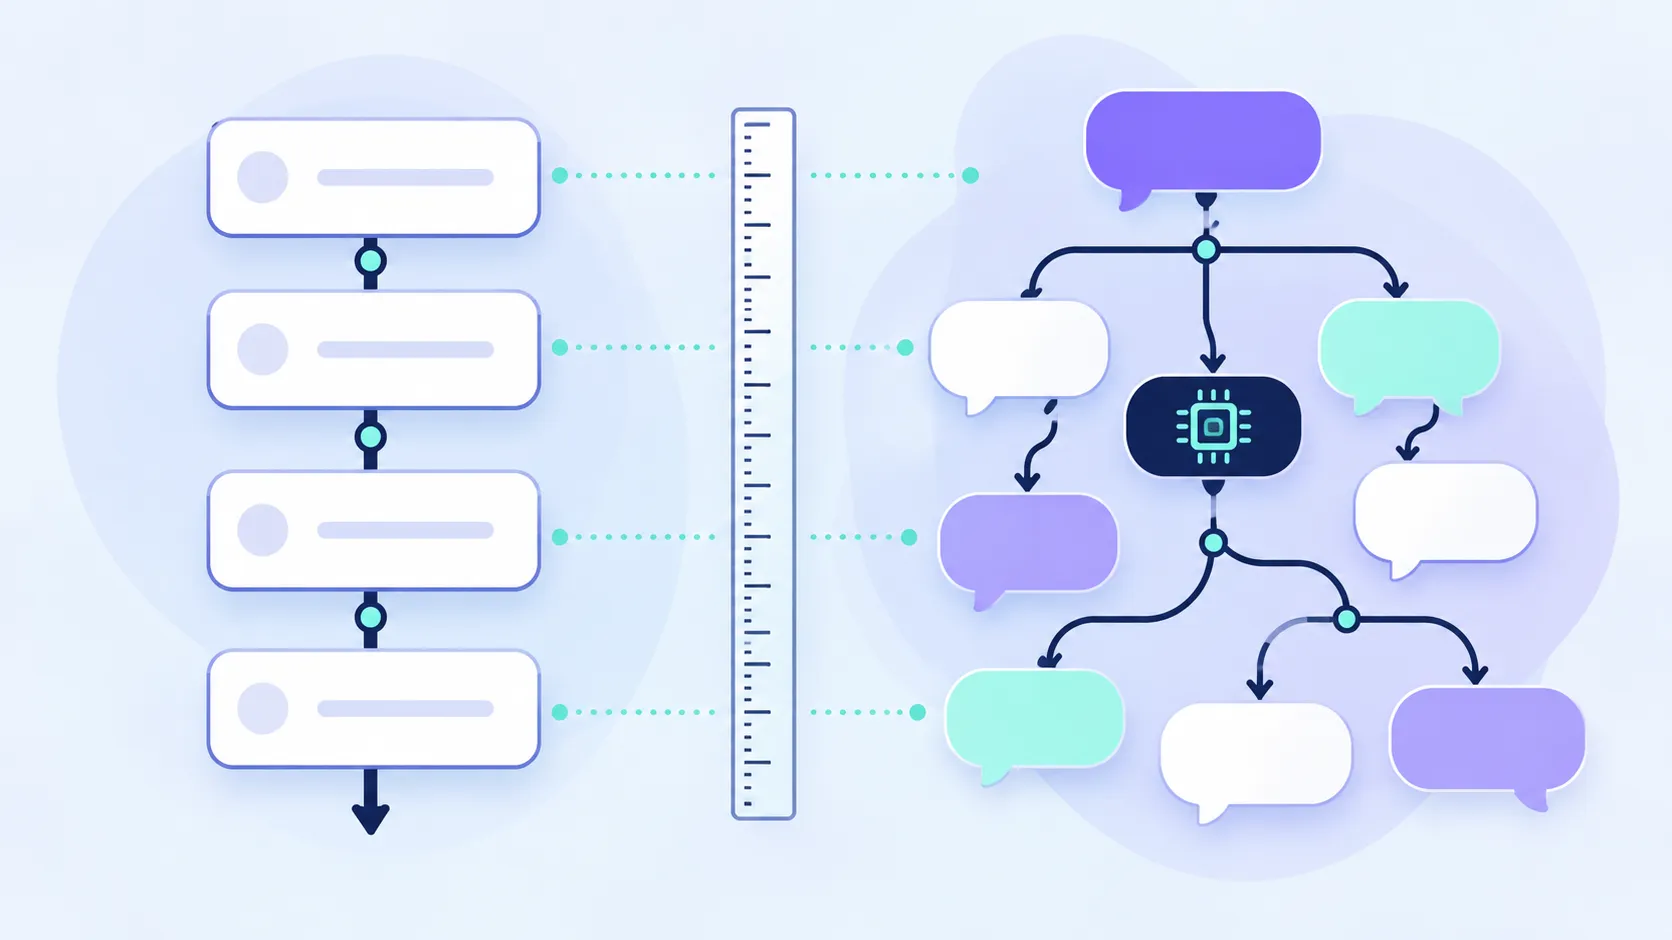
机构试用AI心理测评时,一个容易被界面吸引力盖住的问题是:这次边聊边答得到的分数,能不能接在原来固定问卷的分数后面,继续画趋势图?
答案要看实际改变了什么。聊天呈现、从题库中选择问题、临时生成追问,涉及不同的测量任务。对话更流畅可以改善使用体验,分数是否具有同样含义,还需要与具体做法和用途相配的证据。
先看聊天背后,问题是怎样来的
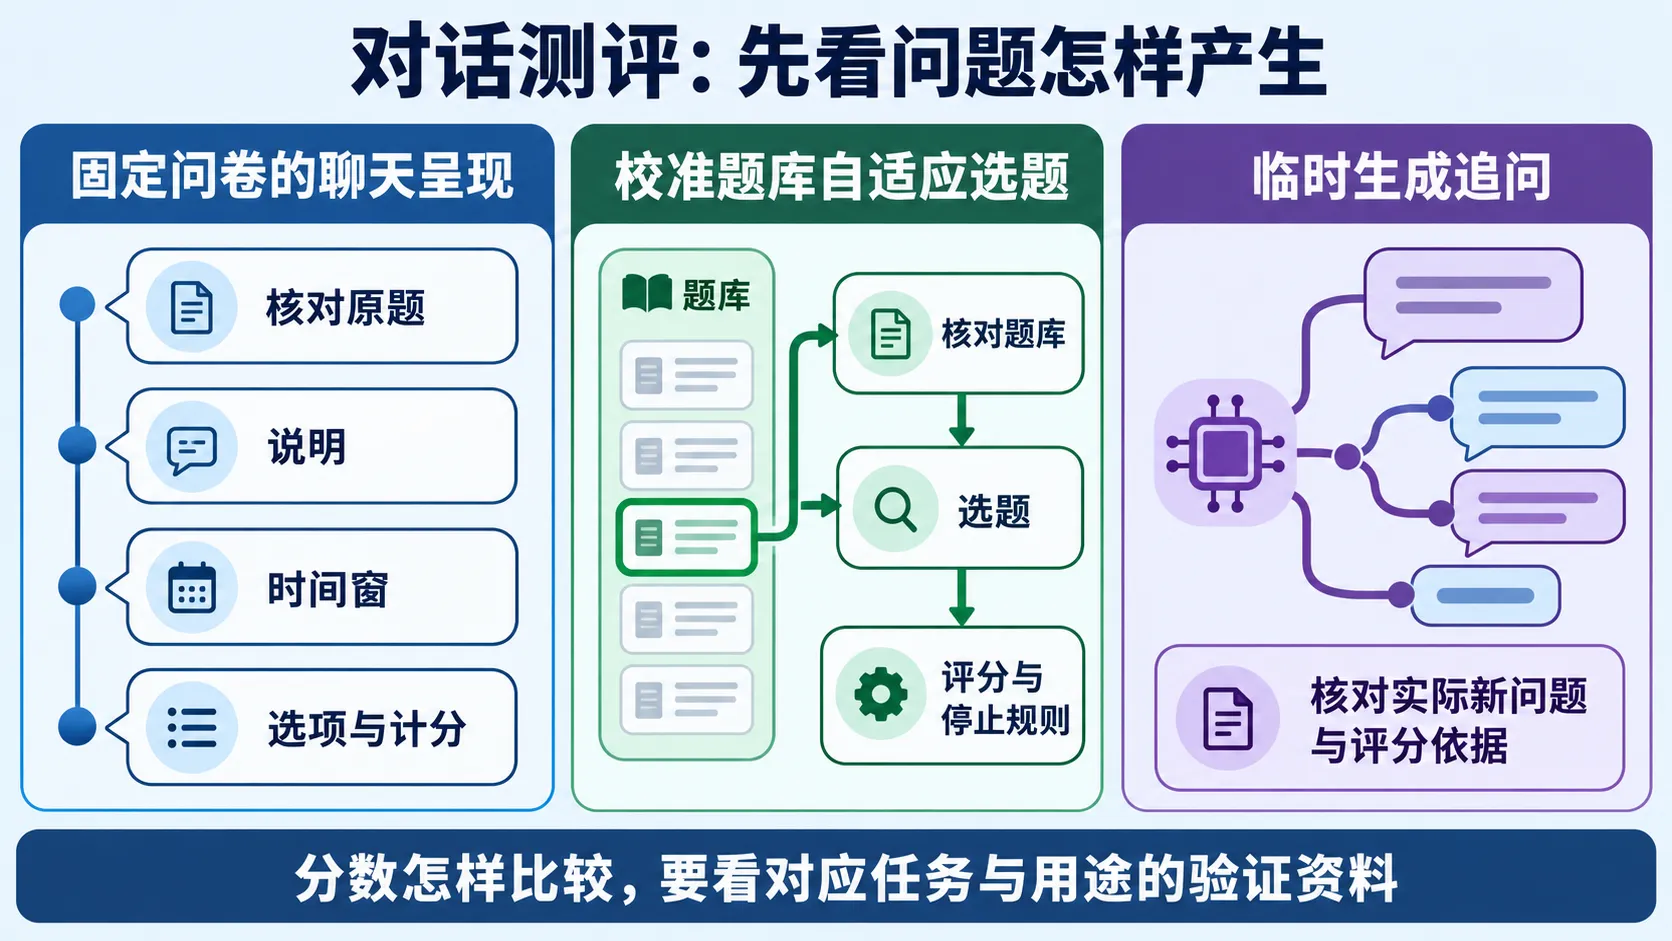
第一种是把固定问卷放进聊天界面。题目逐条出现在对话框里,原来的说明、回忆时间、选项和计分仍被保留,由本人选择回答。这时首先核对的是呈现与操作变化,包括有没有额外解释、暗示,或替参与者选择答案。即使文字保持一致,也应了解实际实施方式的比较资料,不能只凭界面看着像原问卷就宣布等同。
第二种是根据回答,从已校准的题库中继续选题。这类计算机自适应测验通常简称CAT。不同人接到不同题目,可以是预先设计的一部分;需要说明题库依据、选题与计分规则,以及何时停止。题目不同本身不能证明分数无效。
例如,Gibbons等人2012年的心理CAT开发研究先建立项目库和统计模型,再研究选题、停止与测量表现。这说明自适应测量有明确的开发和验证对象;该研究没有替今天任意一个大模型聊天服务提供验证。
第三种是模型临时改写或生成追问。这可能帮助展开经历,也可能改变了正在回答的问题。举个说明性的变化:原来关注一段时间内发生得多频繁,追问却转向“此刻有多难受”;或者原来由本人选择选项,后来由模型根据一段叙述代填。这些都需要看实际内容和评分依据,不能仅用“还是在聊同一件事”来解释。
把“可比”落实到准备怎样使用分数
只想帮助来访者把经历说得更完整,与打算把结果接续到原问卷的个人趋势图,是两种不同目标。后一个目标还要了解,两种方式的分数有没有系统差异、差异是否因人而异,以及误差是否足以影响对变化的解释。
ITC与ATP的技术测评指南要求比较主张与实际变式、使用目的及相应资料对应。机构不必先记住所有统计术语,可以围绕自己的工作向提供方提出三项具体要求:
- 看得见实际任务。拿一段完整演示,或经适当处理的真实样例,核对开始说明、每次收到的问题、追加内容、回答方式和最终计分。不能只看一张报告或一段精修后的聊天片段。
- 说明证据对应哪一版做法。验证用的是哪种语言、哪些参与者、什么题目或生成规则,比较了什么结果。若引用CAT研究,要能说清当前服务如何对应其中的题库与算法,不能把所有“会追问”的系统归为同一种方法。
- 回答具体使用问题。若打算连续观察同一个人,就请提供方说明换用对话方式后,怎样区分任务改变造成的分差与本人实际变化。若资料只支持另一种用途,报告和项目约定中也应说清使用范围。
两个总分相关较高,还不足以保证逐人可以互换。举一个假设:两种方式都能把一群人的结果大致排出相似顺序,但其中一种方式对某些人持续给出更高分。把两次不同方式的结果直接连线,就可能把方法差异读成个人变化。总体关系与个人接续比较,需要分别回答。
当现有证据只支持对话帮助整理经历时,可以先把它保留为独立资料,在后续沟通中使用。固定问卷的分数按原有任务解释,对话内容保留它展开的情境与细节。将来若要把两者合并成同一种分数,再补足那个具体比较主张的证据。