
两份报告都写着“SSEIT,33题”,一份只给情商总分,另一份却分成几个维度,名字还未必一致。这不一定是谁算错了,但也不能直接拿两张雷达图比较。题数相同,只说明表面长度接近;报告怎样组织分数,还取决于具体版本和采用的结构依据。
先确认是Schutte量表,别只认33这个数字
SSEIT通常指Schutte等人开发的情绪智力量表,也会见到Schutte自报情绪智力量表等名称。它让作答者描述自己的情绪相关体验与倾向,属于自评工具,不是通过情境答案来直接判定表现的能力测验。
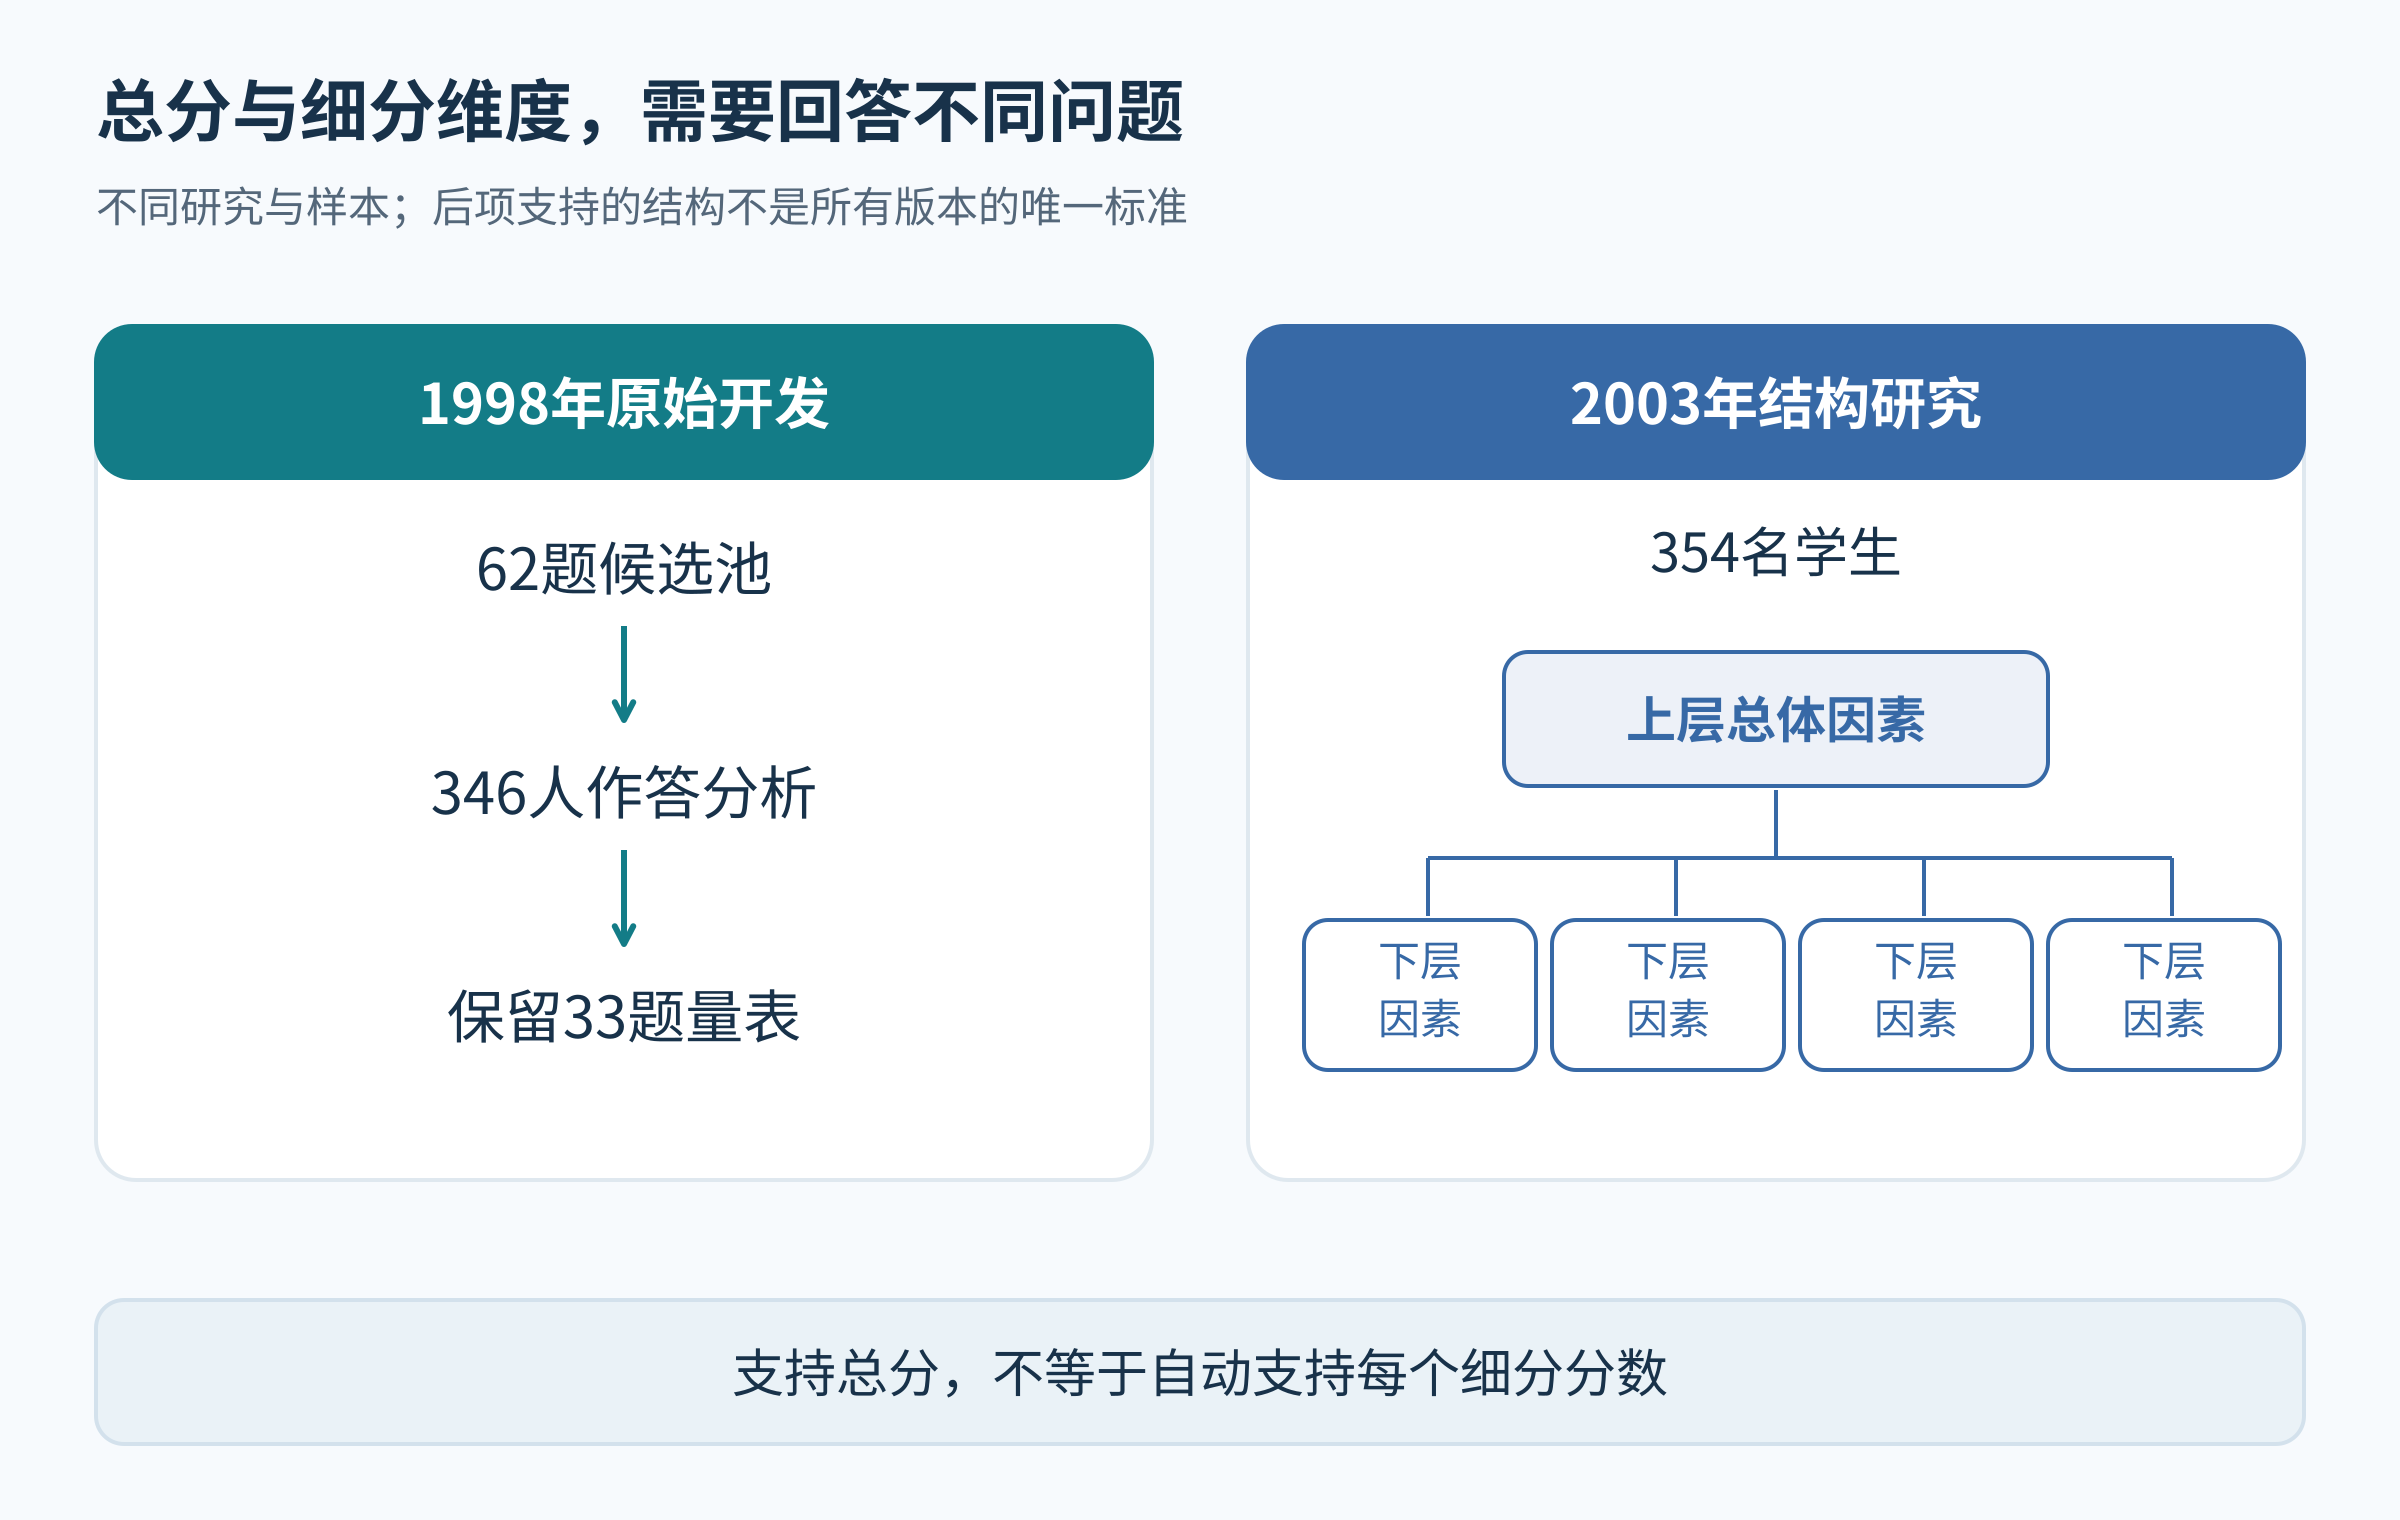
原始研究从62个候选题目出发,分析346名参与者的作答后形成33题量表,并继续检验其可靠性与相关证据。因此,33题有特定的开发背景;网上任何33道情商题,都不能仅凭数量就被认作同一个工具。1998年的原始开发记录是核对出处的一条线索。
能给总分,与能分几个维度,是两层问题
总分试图概括较广的自评情绪倾向。细分维度则进一步追问:题目是否形成稳定的不同内容组?每一组的分数能否单独解释?原始开发重视总体分数,后续研究继续考察内部结构,因而会出现不同的分组方案。
例如,2003年一项354名学生参与的研究,通过探索与验证分析,支持一个上层总体因素加四个下层因素的层级结构。这说明总体与细分层次可以同时讨论,并非有了多个维度就必须否定总分。不过,一项研究支持四个因素,也不能推出所有译本、年龄与场景都应照搬同一张四维图。该研究的结构结论有其样本和分析范围。
为什么同名维度有时不是同一回事
报告编制者可能采用不同的既有研究方案,也可能对原题做过翻译、删改或重新分组。同样叫“情绪管理”,有的内容偏向管理自身情绪,有的可能混入对他人情绪的判断。名字相似,并不能保证两项分数覆盖相同内容。
还有一种容易混淆的情况:理论介绍中把情绪能力分成若干领域,报告就直接把这些领域当成已验证的分量表。理论说明“想关注什么”,结构研究则检验“这些题目的作答关系能否支持这样分”。两者需要衔接,不能省掉中间的证据。量表整体可靠,也不自动意味着每个较短的细分分数都同样精确。
拿到报告,可以问这四件事
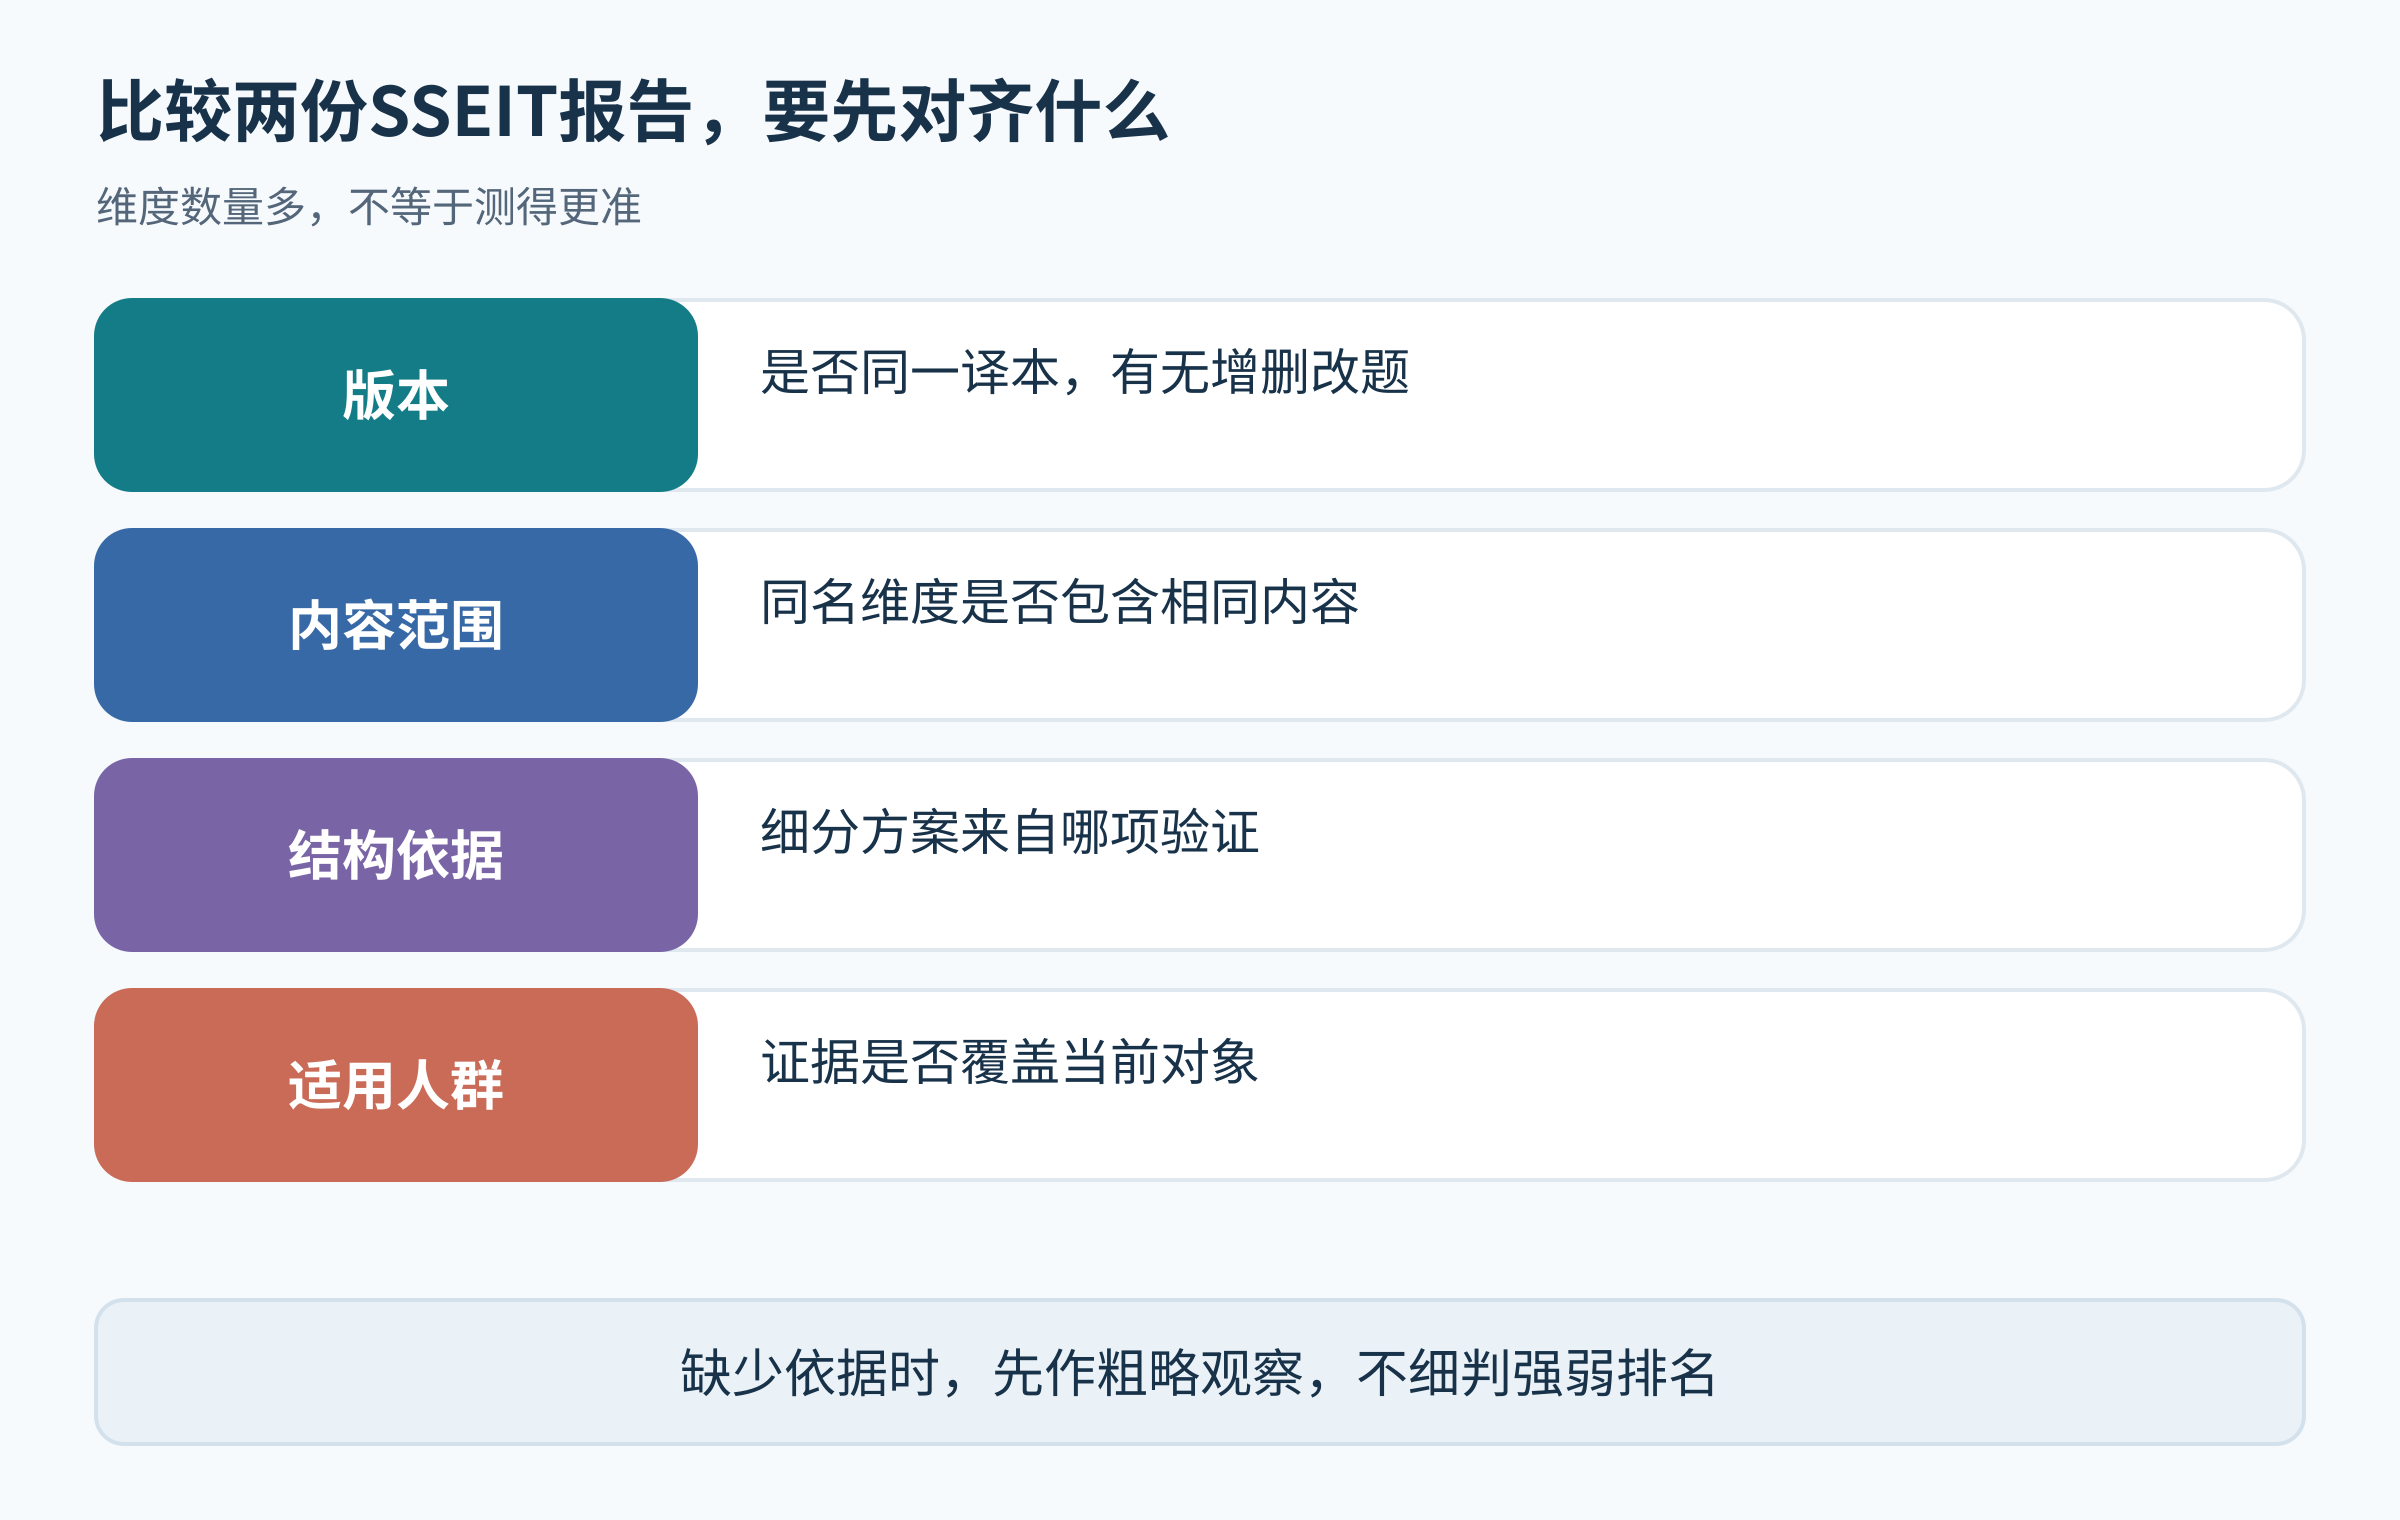
- 版本是什么?有没有明确作者、译本来源与改编说明,而不只是一个英文缩写?
- 维度依据是什么?细分方案来自哪项研究,还是仅为了报告排版自行命名?
- 各维度能单独解释吗?是否提供分量表层面的证据,而不只贴一个全量表可靠性数字?
- 适用于谁?研究人群与当前年龄、语言及用途是否接近?
信息齐全时,细分结果可以帮助整理自我观察;信息不足时,不妨把它当作交流线索,暂缓给自己排出精确的长处短板。尤其不要因为某一维最低,就推断自己缺少共情或不适合某种关系。值得信任的报告不一定分得最多,而是能解释每个分数从哪里来、可以说到哪一步。