
学校心理测评报告中出现“探索型”“低资源型”等名称时,名称很容易比分析本身更引人注意。心理中心审核这类报告,应先追问这些名称对应哪些指标组合、模型如何得到,以及一个学生被归入某组时还保留多少不确定性。
潜在剖面分析常用于连续心理指标的组合研究。它尝试从同一批人的多项反应中识别不同模式,让研究者观察单个总分难以呈现的组合差异。
组合的意义来自测量内容
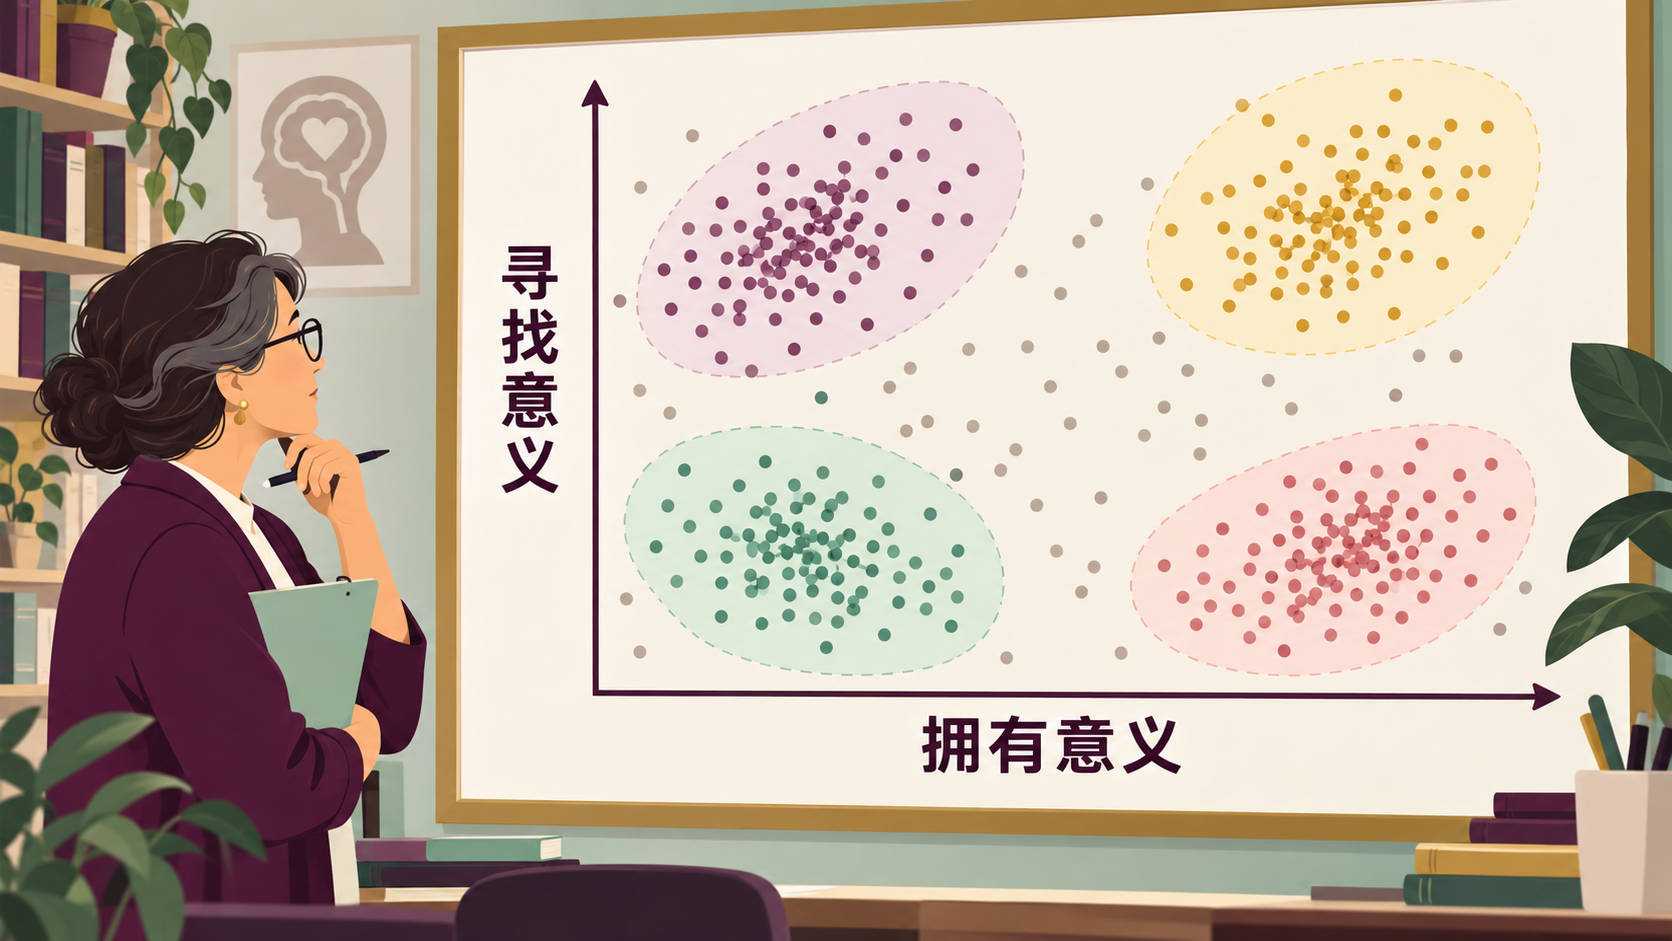
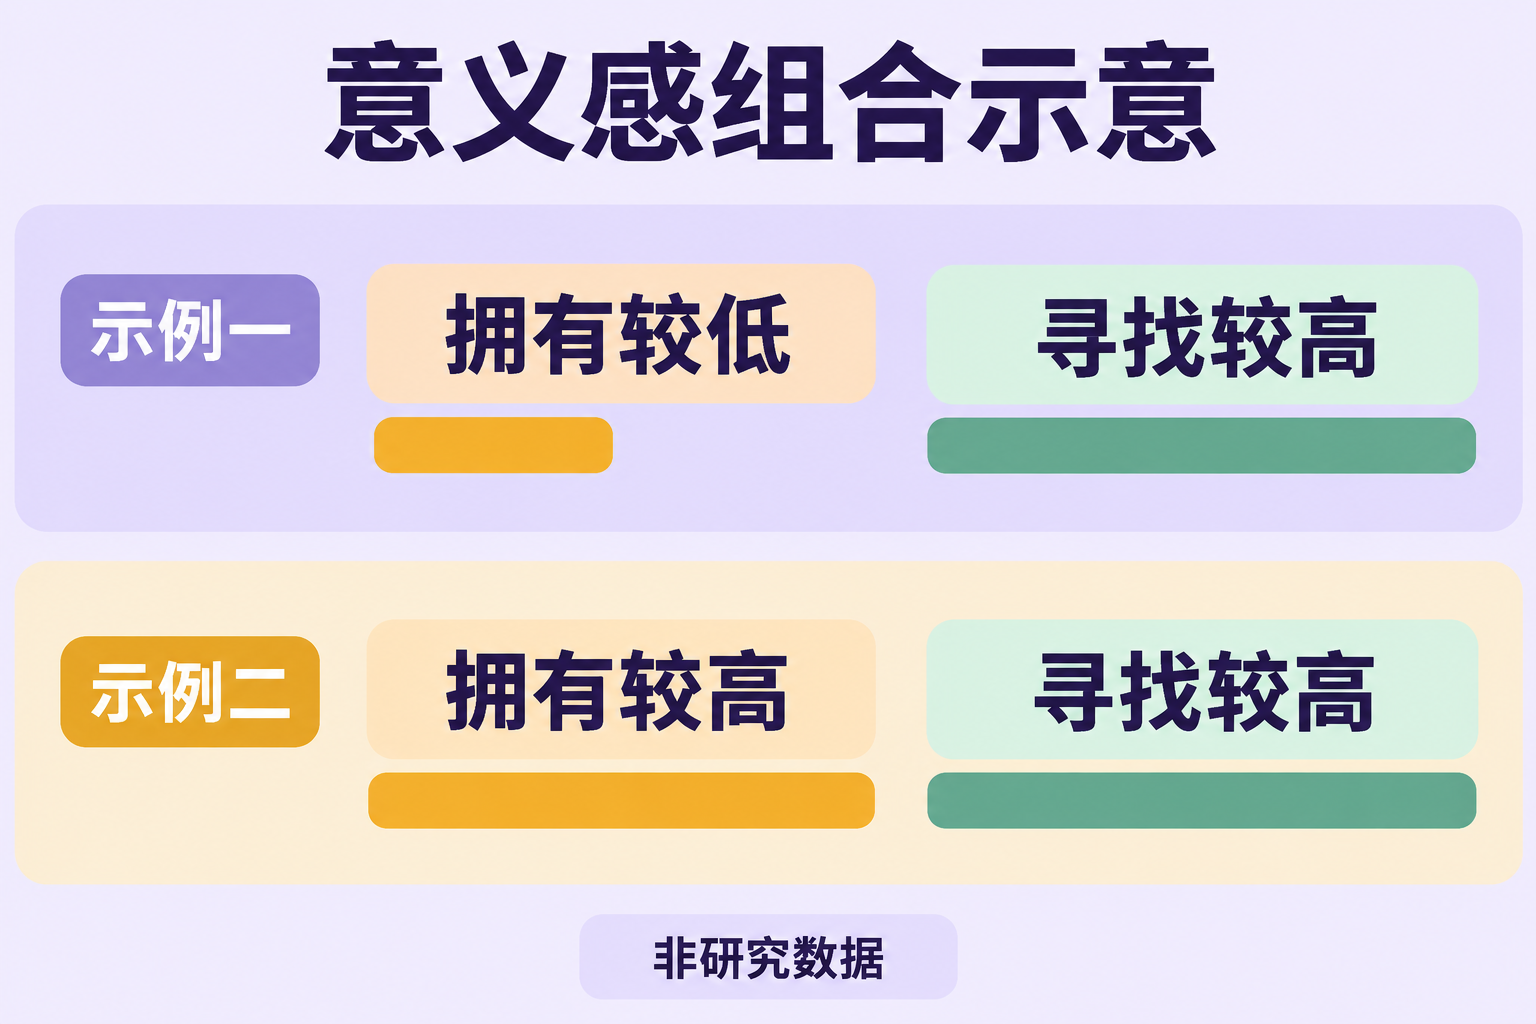
以生命意义感为例,拥有意义的体验与寻找意义的倾向可以形成不同组合。国内一项对 997 名高一至高三学生的研究,运用潜在剖面分析识别了四种生命意义感模式,并考察它们与孤独感的关系。这展示了以人为中心的分析如何补充单一指标间的相关研究。国内原始研究
这些模式是在特定指标、样本和模型下得到的。引用论文中的类别名称时,应同时介绍其指标含义;论文的类别比例只描述该研究样本。换一所学校、换一组指标,是否仍出现相同模式,需要重新检验。
对学校报告来说,先把每一类的实际测评分布画清楚,比先选一个鲜明标签更重要。若两类主要差在整体高低,报告应如实描述;若各指标一高一低形成不同组合,则应解释这个心理差异。名称服务于理解,不能代替指标本身。
归入一类仍然有不确定性
模型会为个体估计属于各类别的后验概率。按最大概率将学生归到一类,方便统计汇总,也压缩了原来的信息。
例如,以下是假设数值:一名学生属于甲、乙两类的概率分别为 .52 和 .48,另一名学生分别为 .95 和 .05。两人都可能被归入甲类,分类确定程度明显不同。把他们统一写成“甲型学生”,阅读者便看不出差别。
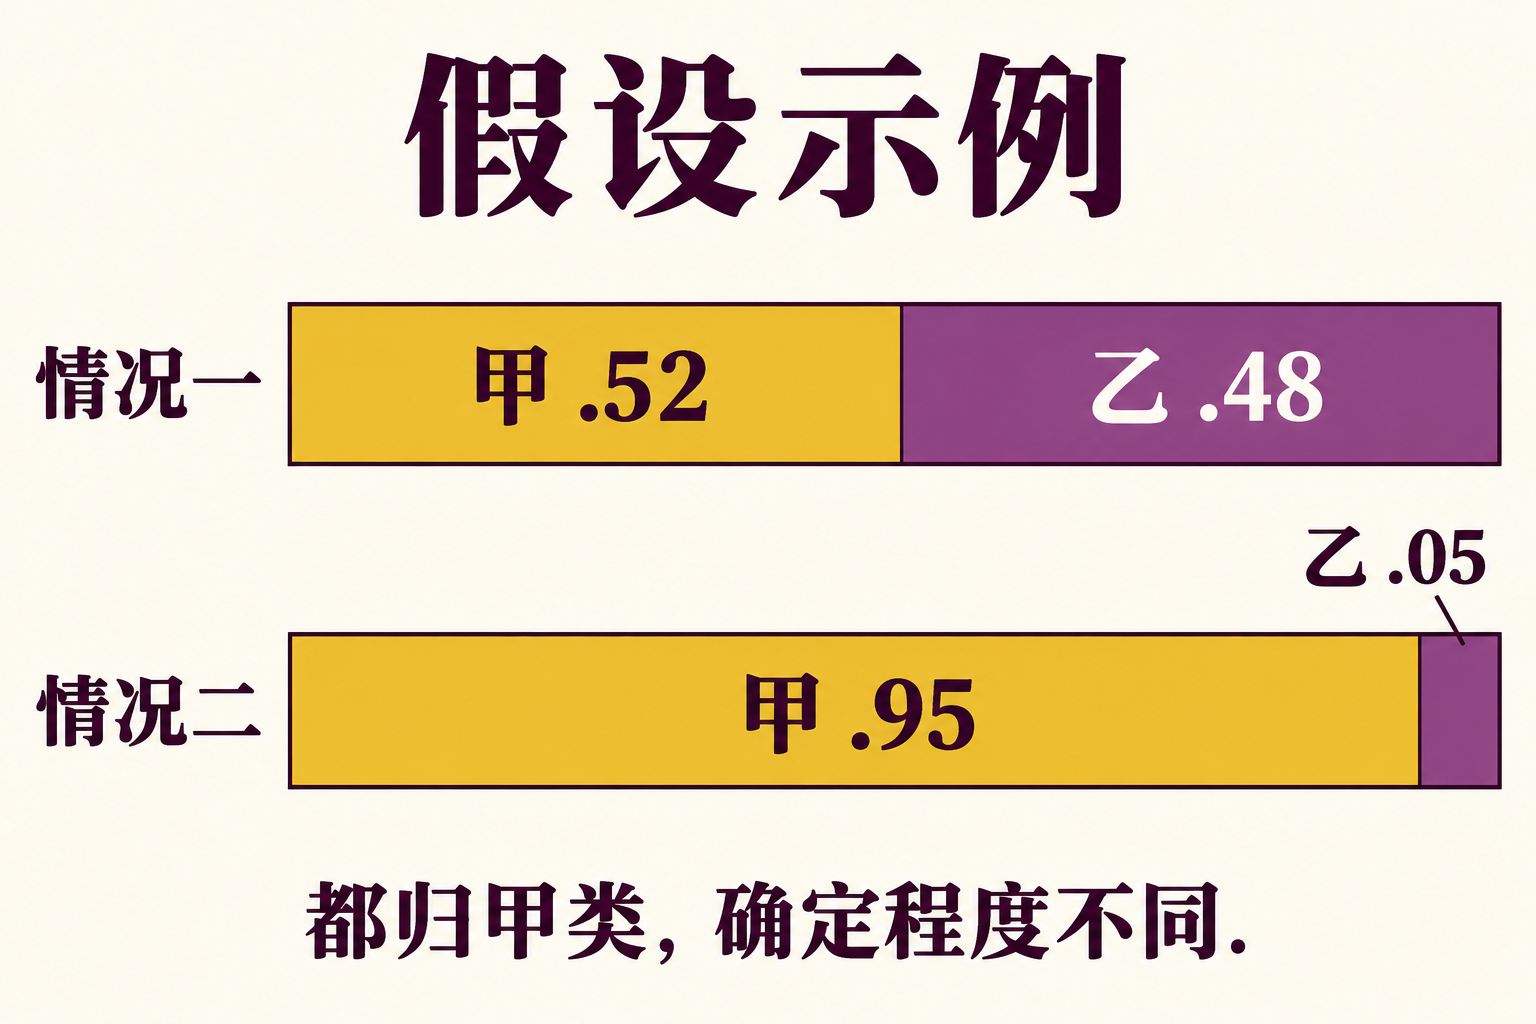
后验概率是给定模型与当前资料下的归属估计,不能理解成学生有多大概率“拥有一种人格”。个体评估仍需回到他的原始维度得分、当前经历和访谈资料。
类数、分离程度和稳定性分别审核
确定类别数量时,研究人员需要综合模型比较、类别大小、解释意义和估计情况。类数更多可能让图形更丰富,也可能把样本中的细碎差异解释过度。
Entropy(熵)常用来描述分类清晰程度。国内一项模拟研究专门考察了它在潜在剖面分析中的表现,提示其结果受类别、指标和样本等条件影响。因此,一个较高的熵值不能独自完成类数选择,也不证明这些类别能在另一届学生中重现。方法研究
学校心理中心接收分析报告时,可以要求说明为何保留当前类数、分类概率的整体情况,以及换样本或其他合理分析条件后结果是否稳定。这些信息能帮助决定报告适合承担群体研究描述,还是已有依据进入更具体的应用。
完成统计分组之后,个体是否需要某种服务仍需单独评估;班级名单也不宜直接变成固定类型名单。