

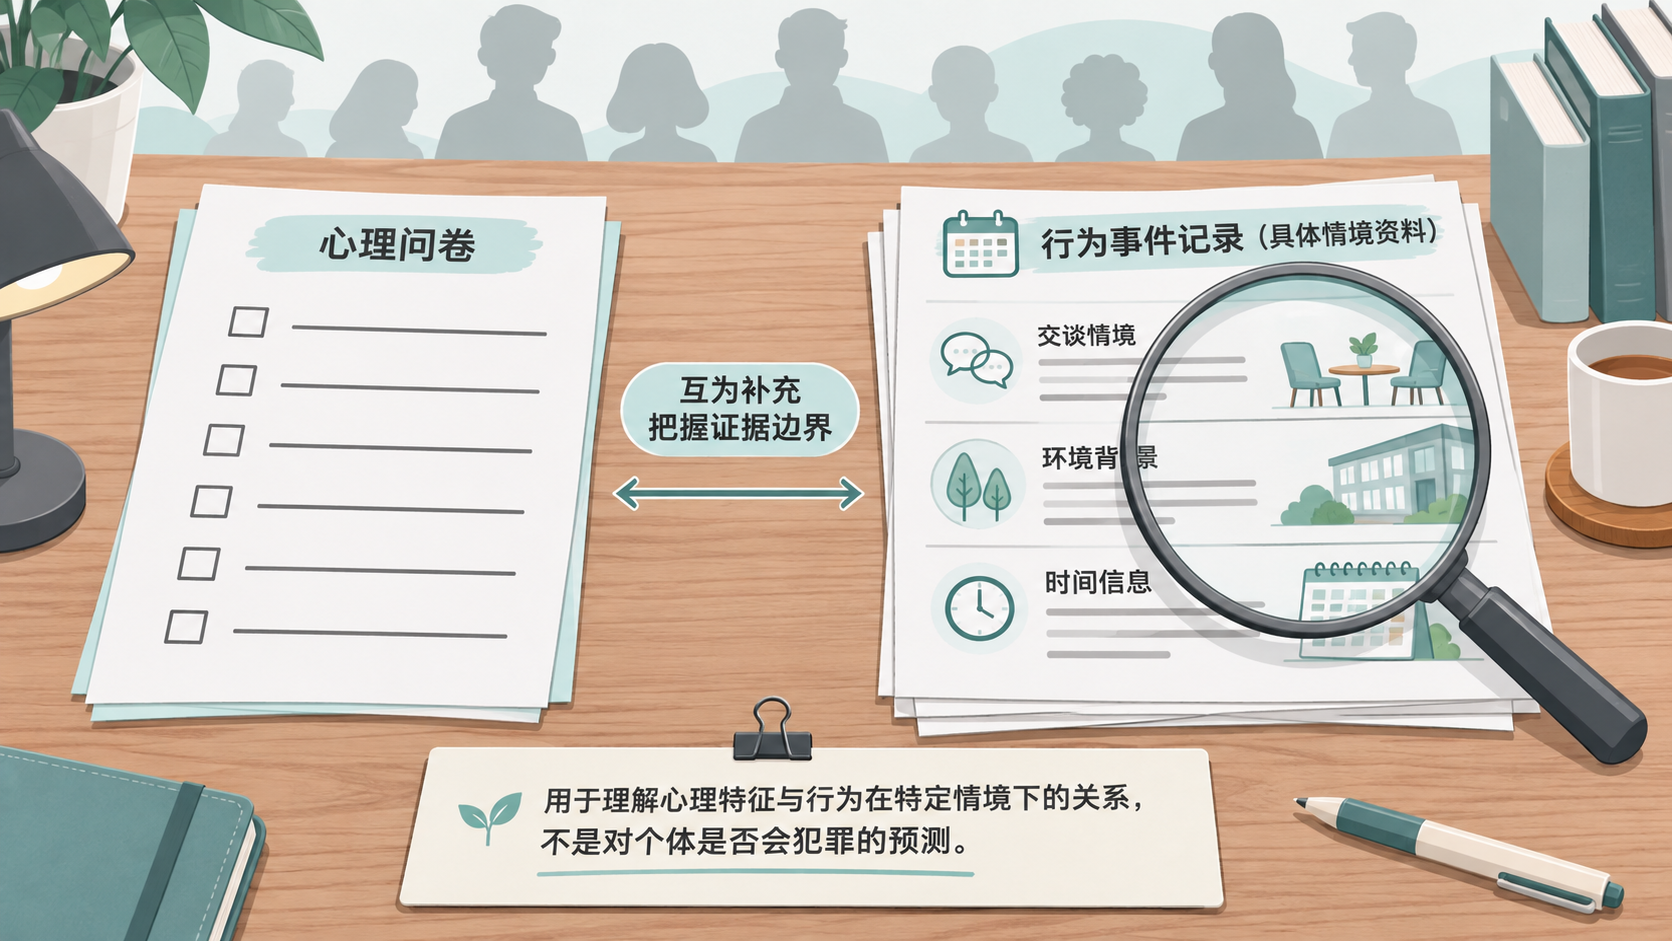
反社会人格测试高分,不能据此判断某个人将来会不会犯罪。人格特质、临床诊断和危险行为预测回答的是不同问题。即使某种专业工具在研究中与后续违法行为有关,也要核对预测什么行为、多久之内、在哪类人群中验证,不能把群体关联直接当成一个人的未来。
先问报告到底在评估什么
网上叫“反社会人格测试”的问卷,可能只是了解某些特质,也可能使用了与临床工具相似的名称。量表标题不能证明它具备诊断能力,更不能证明它经过犯罪预测验证。精神病态相关特质与反社会人格障碍有重叠,但并非同一个概念;两者也都不等于一份完整的行为风险评估。
例如,精神病态评估工具 PCL-R 的开发者对使用者的专业训练、经验与验证人群有明确要求,并提醒误用可能造成严重后果。把专业名称放到一个在线问卷上,不能自动继承原工具的研究结果。旁人根据几次冲突替一个人填答,也不能作为可靠的专业评估。
“预测有效”还需要说明四个条件
- 结果是什么。预测暴力、任何违法行为与某一类犯罪并不相同;预测关系中的冷漠或不负责任,更不是预测犯罪。
- 时间有多长。住院期间短期行为风险与几年后的再次违法,是不同的任务。一项研究支持前者,不等于支持后者。
- 研究对象是谁。司法或临床样本中的发现,不能未经验证就搬到普通同事、伴侣或网络用户身上。
- 结果原本有多常见。基础发生率会影响被判为高风险者中真正出现目标行为的比例。忽略这个比例,“高风险”的日常理解很容易被夸大。
最后一点并不需要记公式。在其他测试性能相近的条件下,目标行为越少见,被筛出的人里就越可能包含没有出现该行为的人。因此,“能够一定程度区分两组人”和“能准确预言眼前这个人”不是同一个结论。报告若只强调准确率,却不交代上述条件,证据仍不完整。
Fazel 等人在 2012 年发表于 BMJ 的系统综述比较了多种风险工具,发现预测表现随用途而变化,不支持仅凭工具作出拘禁、量刑或释放决定。这是有关专业场景和既往研究的结论,不能拿其中的平均结果计算某位读者或熟人的犯罪概率,也不是对全部后来工具的最终评价。
专业评估还要了解正在发生的事
风险并不只藏在一个稳定的人格总分里。英国皇家精神科医学院的评估资料要求了解既往行为、近期变化、具体威胁、环境和保护因素,并综合可靠来源。NICE 的暴力与攻击管理指南也强调评估情境与定期复核,在特定住院场景可使用经过验证的结构化工具。
结构化的价值,在于提醒专业人员系统地核对信息、说明依据,并把评估用于安全管理。它仍有不确定性,也不把风险变成终身身份。相同的特质描述,遇到不同处境、支持和行为变化,不能一概得出同一种当前结论。
如果已经发生威胁、跟踪、伤害或其他让人无法安全离开的行为,求助不需要先证明对方患有哪种人格障碍。应根据实际行为寻求可信赖者和相应专业机构的支持;存在紧迫人身危险时,优先到安全处并联系当地警方或紧急服务。也不要因对方问卷分数低,就忽略已经发生的伤害。
参考资料:PCL-R 开发者的使用边界说明;Fazel 等关于风险预测工具的系统综述;英国皇家精神科医学院风险评估资料;NICE NG10 建议。