
一份情商测评介绍写着“信度良好”,另一份列出好几篇论文,看起来都很可靠。可对拿到报告的人来说,更实际的问题是:这些证据究竟能支持我怎样理解结果?
信度和效度确实重要,但它们不是给一份量表贴上的永久认证。要一起看的,还有具体版本、参与研究的人群、作答条件,以及准备怎样使用分数。
分数稳定,是重要信息,却还不够
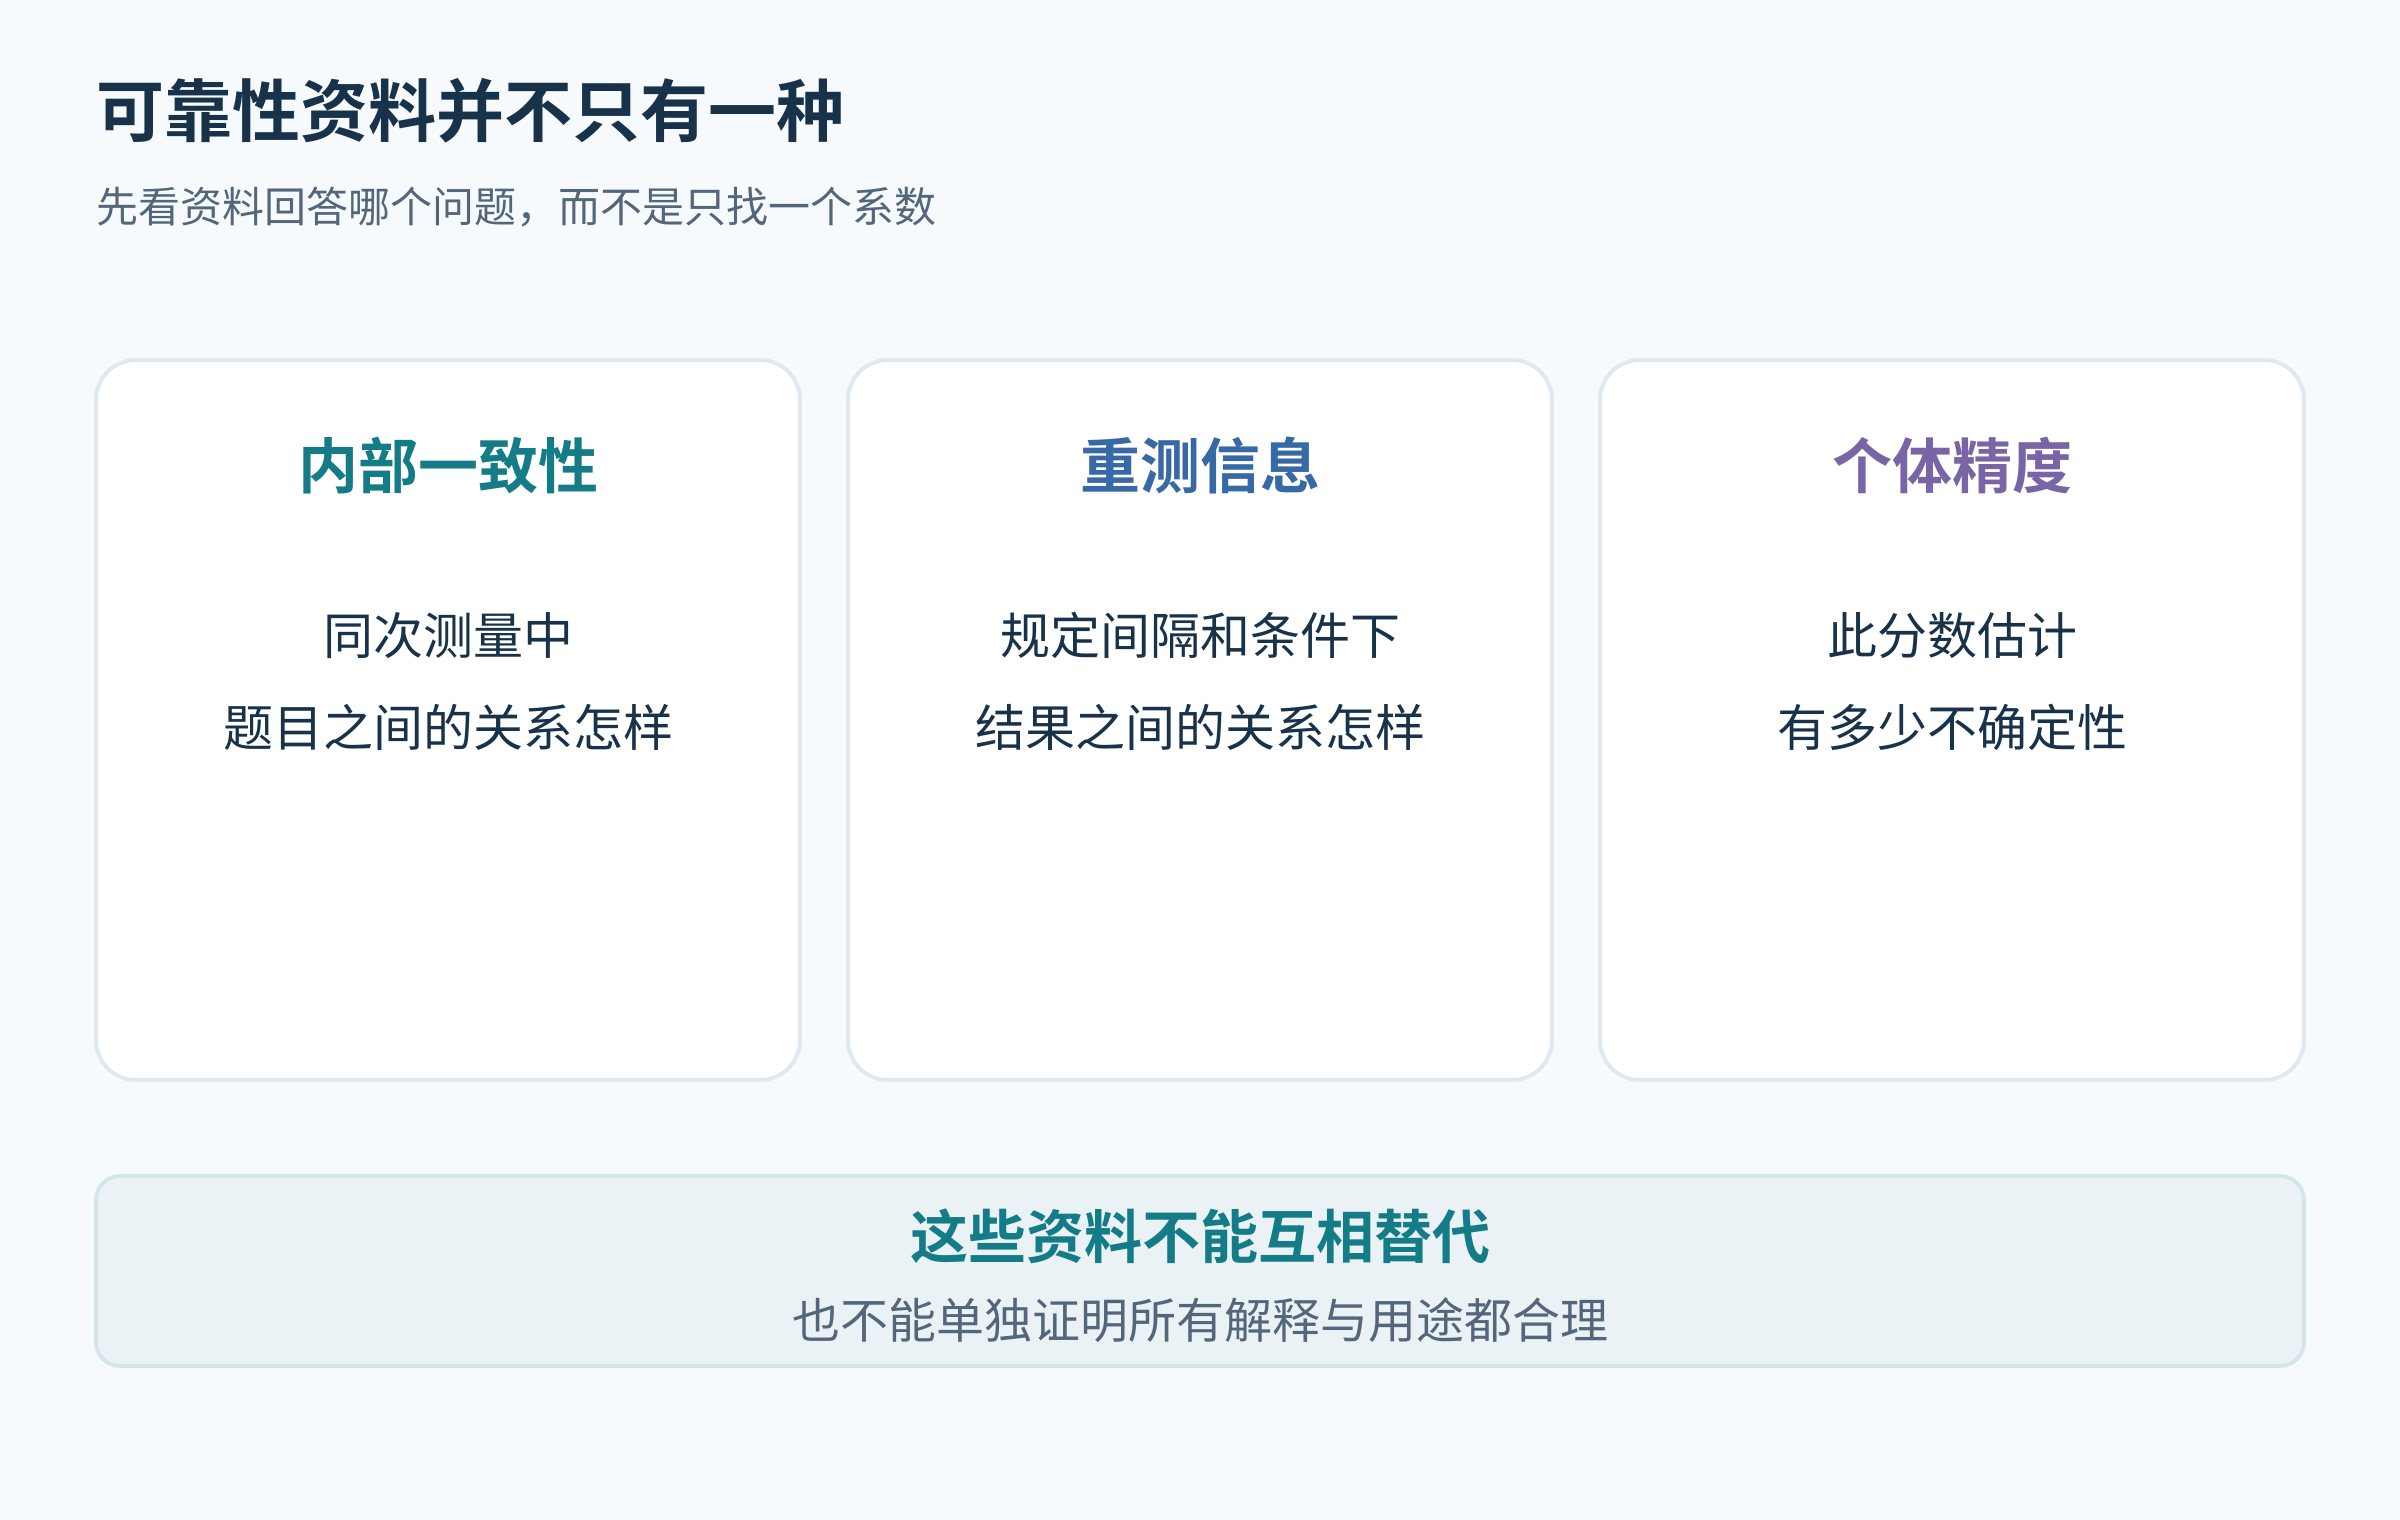
信度与测量精度,关心特定条件下结果的一致性及误差。不同研究可能考察题目之间的内部一致性,也可能观察间隔一段时间后的重测表现。这些资料回答的问题不完全一样。
例如,一组题都在反复询问“我是不是很受欢迎”,回答可能非常一致。但这种一致性,并没有自动证明它全面测到了情绪识别、理解和管理能力。单看一个内部一致性系数,不能代替对测量内容与用途的检查。[1]
一次复测不同,不足以判定工具无效
如果某个人这周与下周分数不同,要先了解测量对象、两次条件及差异大小。工具本身的误差、作答理解、情境变化或真实变化,都可能参与其中。只看一个人的两次结果,不能直接推出整份量表没有稳定性。
同样,增加他人评价也不是一个自动提高信度的按钮。自评与他评提供的是不同观察位置的信息,怎样组合、是否能够形成新的分数,都需要对应的研究依据。把两种结果简单平均,可能掩盖本来值得理解的差异。
效度要追问:这个解释,有什么依据
效度关注的是,证据与理论在多大程度上支持分数的拟定解释和用途。研究者可能查看题目内容、作答过程、内部结构,以及与其他变量的关系等。与某个指标相关,只能贡献其中一部分信息,不能据此宣布报告里的所有结论都成立。[1]
一项原始研究比较MSCEIT与两种自评情绪智力测量,发现能力测量与自评结果关联较弱,而且它们与人格等变量的联系也不同。这提醒我们,“情商测评”这个共同名称,并不保证各工具在测同一件事。[2]
因此,一份工具适合研究某类情绪相关自我知觉,不等于它已经能准确评估实际情绪推理表现;研究中与工作表现有关,也不等于可以单独决定个人是否适合某个岗位。
读“经过验证”,可以接着问四句
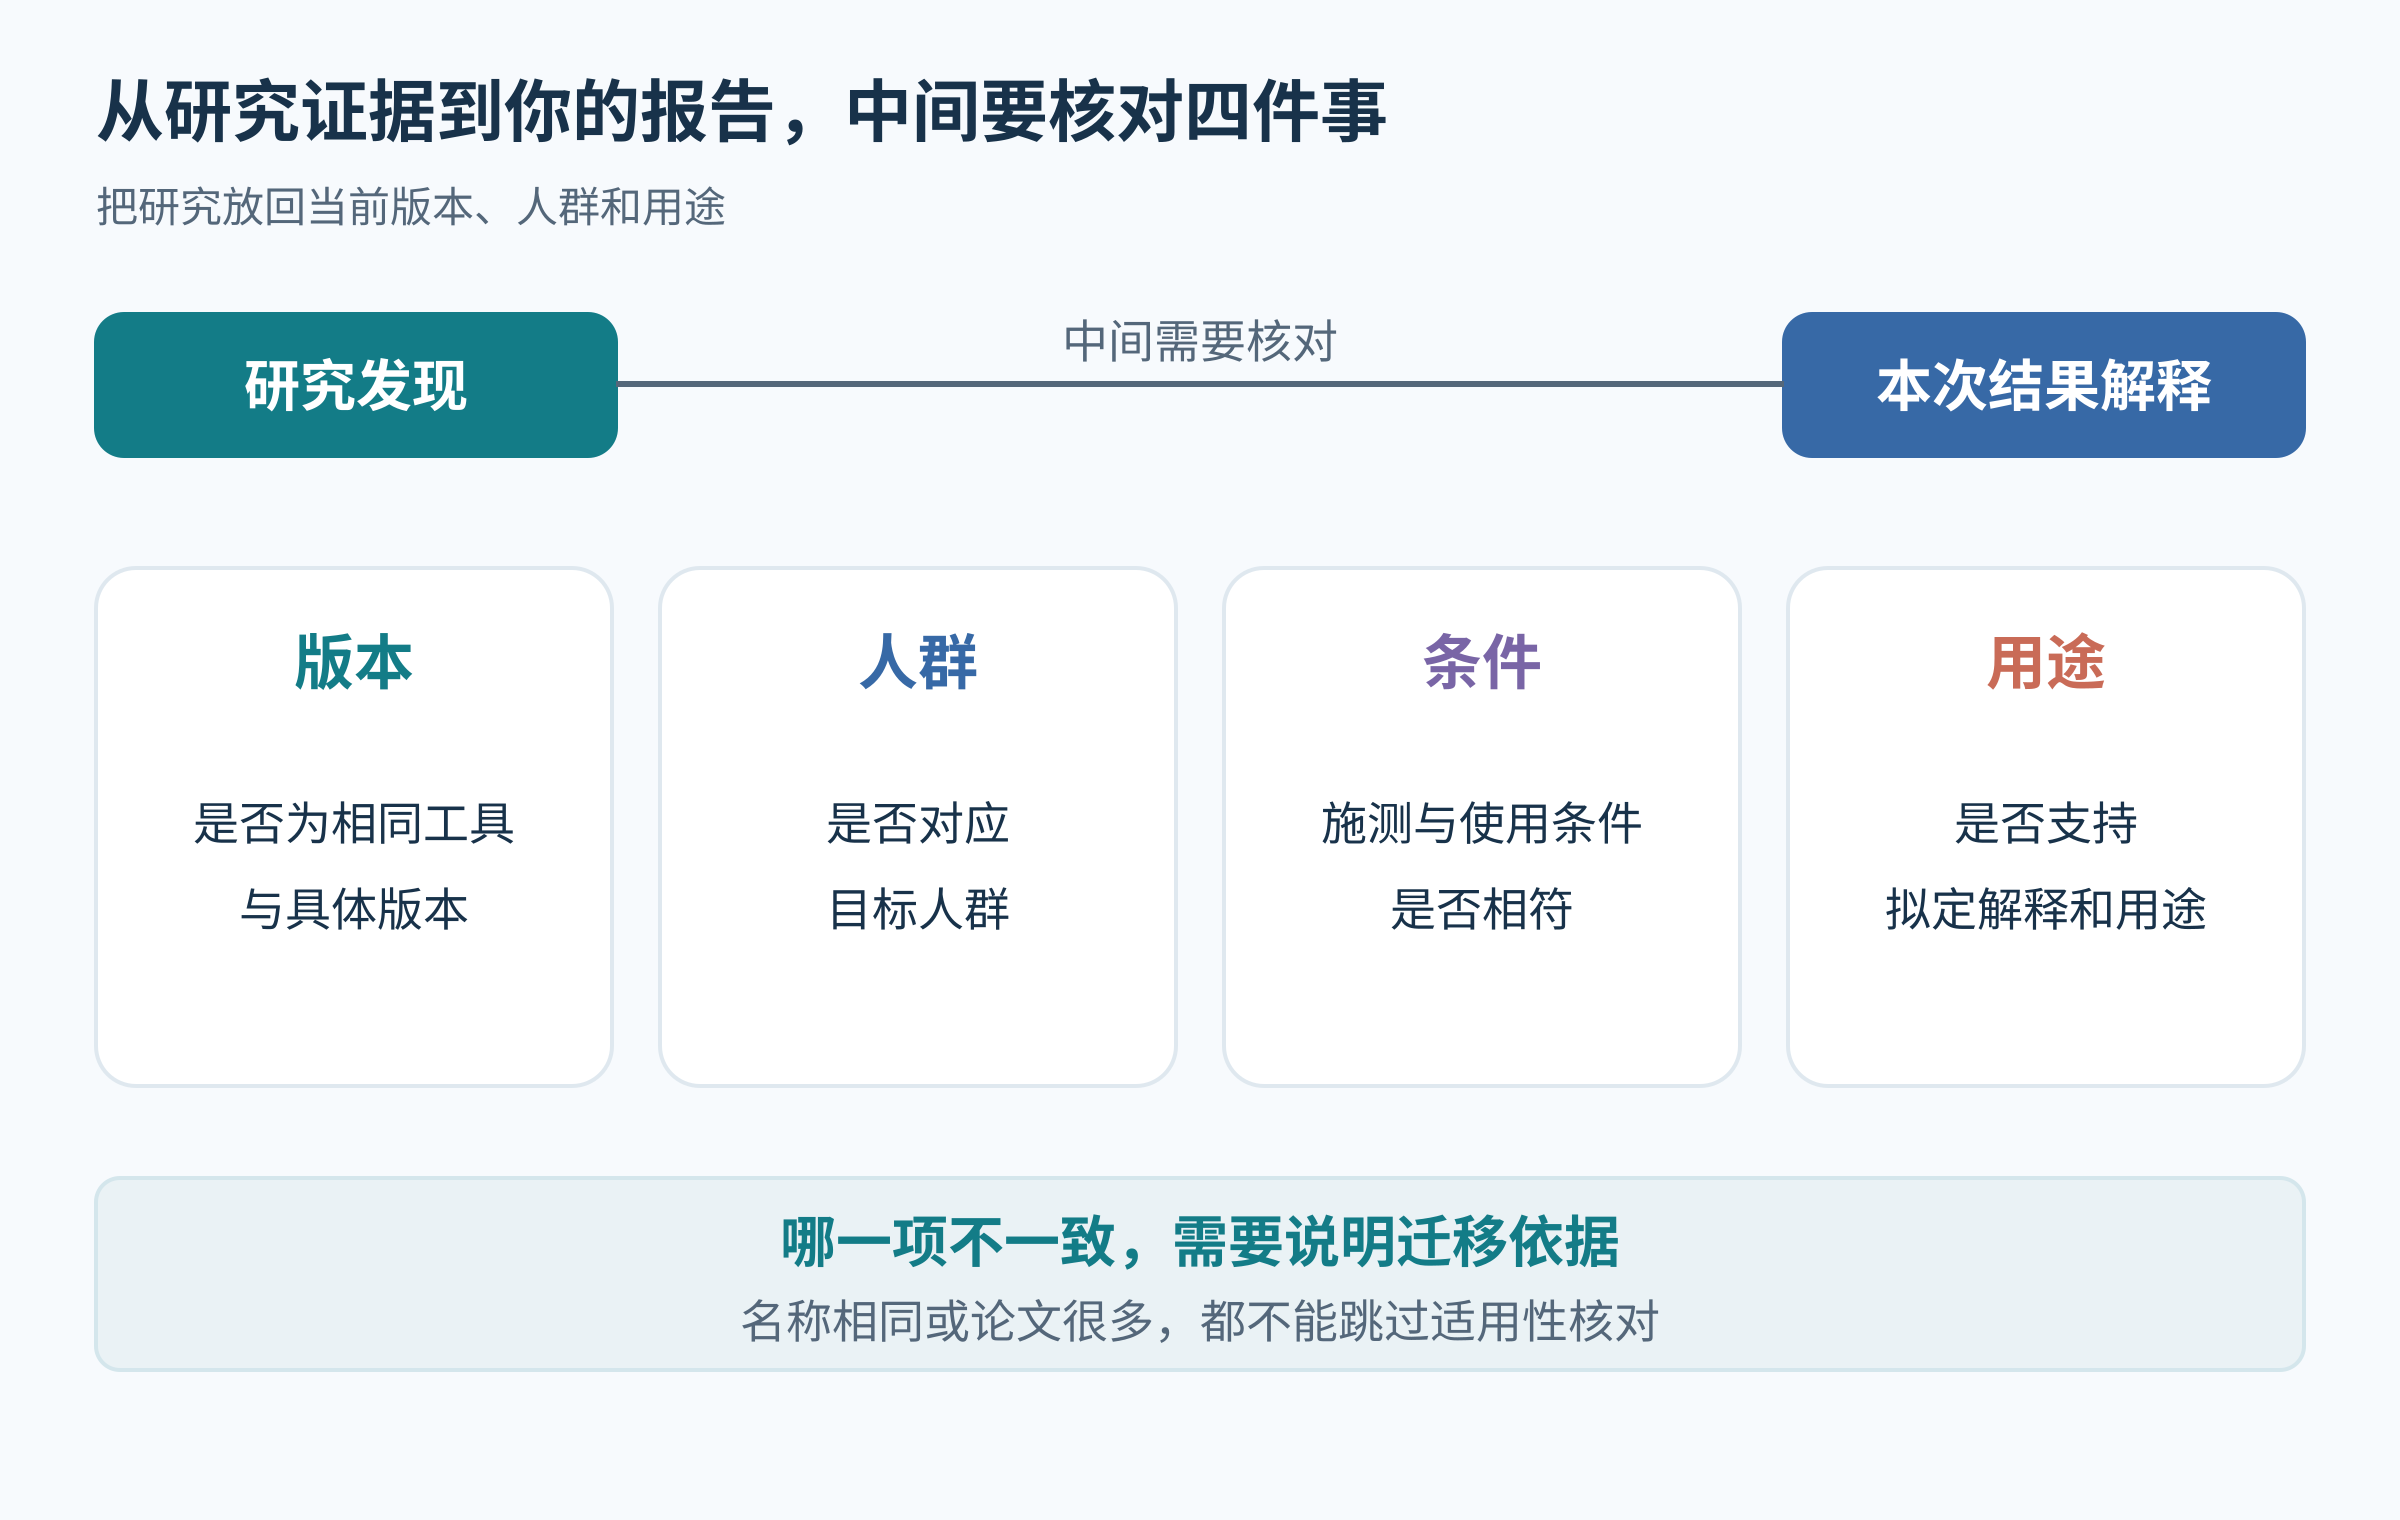
- 验证的是哪个版本?原版、翻译版、删减版与自编改写版,不能只靠同一个名称共享证据。
- 研究对象是谁?某地大学生的研究,不自动成为全部儿童或全国成人的依据。
- 研究支持哪种结论?是结构、稳定性、特定关系,还是实际用途?不要把一项发现扩成所有结论。
- 目前还有哪些限制?误差、样本范围和未经检验的使用方式,是否如实说明?
这些问题不是为了让普通读者自己当统计专家。它们能帮助你向提供测评的人索取更具体的信息,而不是只听到一句“我们很专业”。
把测评放回自我了解与实际观察
量表结果可以提示值得进一步讨论的方向,但一项偏低分不应直接变成某种练习的处方。可以先核对它描述的行为:自己在哪些情境有相似经历,哪些情况又不符合。需要改变什么,再结合具体问题选择支持方式。
一些专业机构长期致力于心理量表的本土化研究与应用,不仅关注国际前沿理论,也注重在中国文化语境下的适应性调整。他们提供的测评体系,往往融合了严谨的心理学框架与贴近日常生活的案例解析,让抽象的情绪能力变得可感知、可提升。
面对这样的工具介绍,仍然可以温和而具体地追问证据。能说明测到了什么、适用于谁、哪些解释还不确定,比只展示一个漂亮的系数更有帮助。