

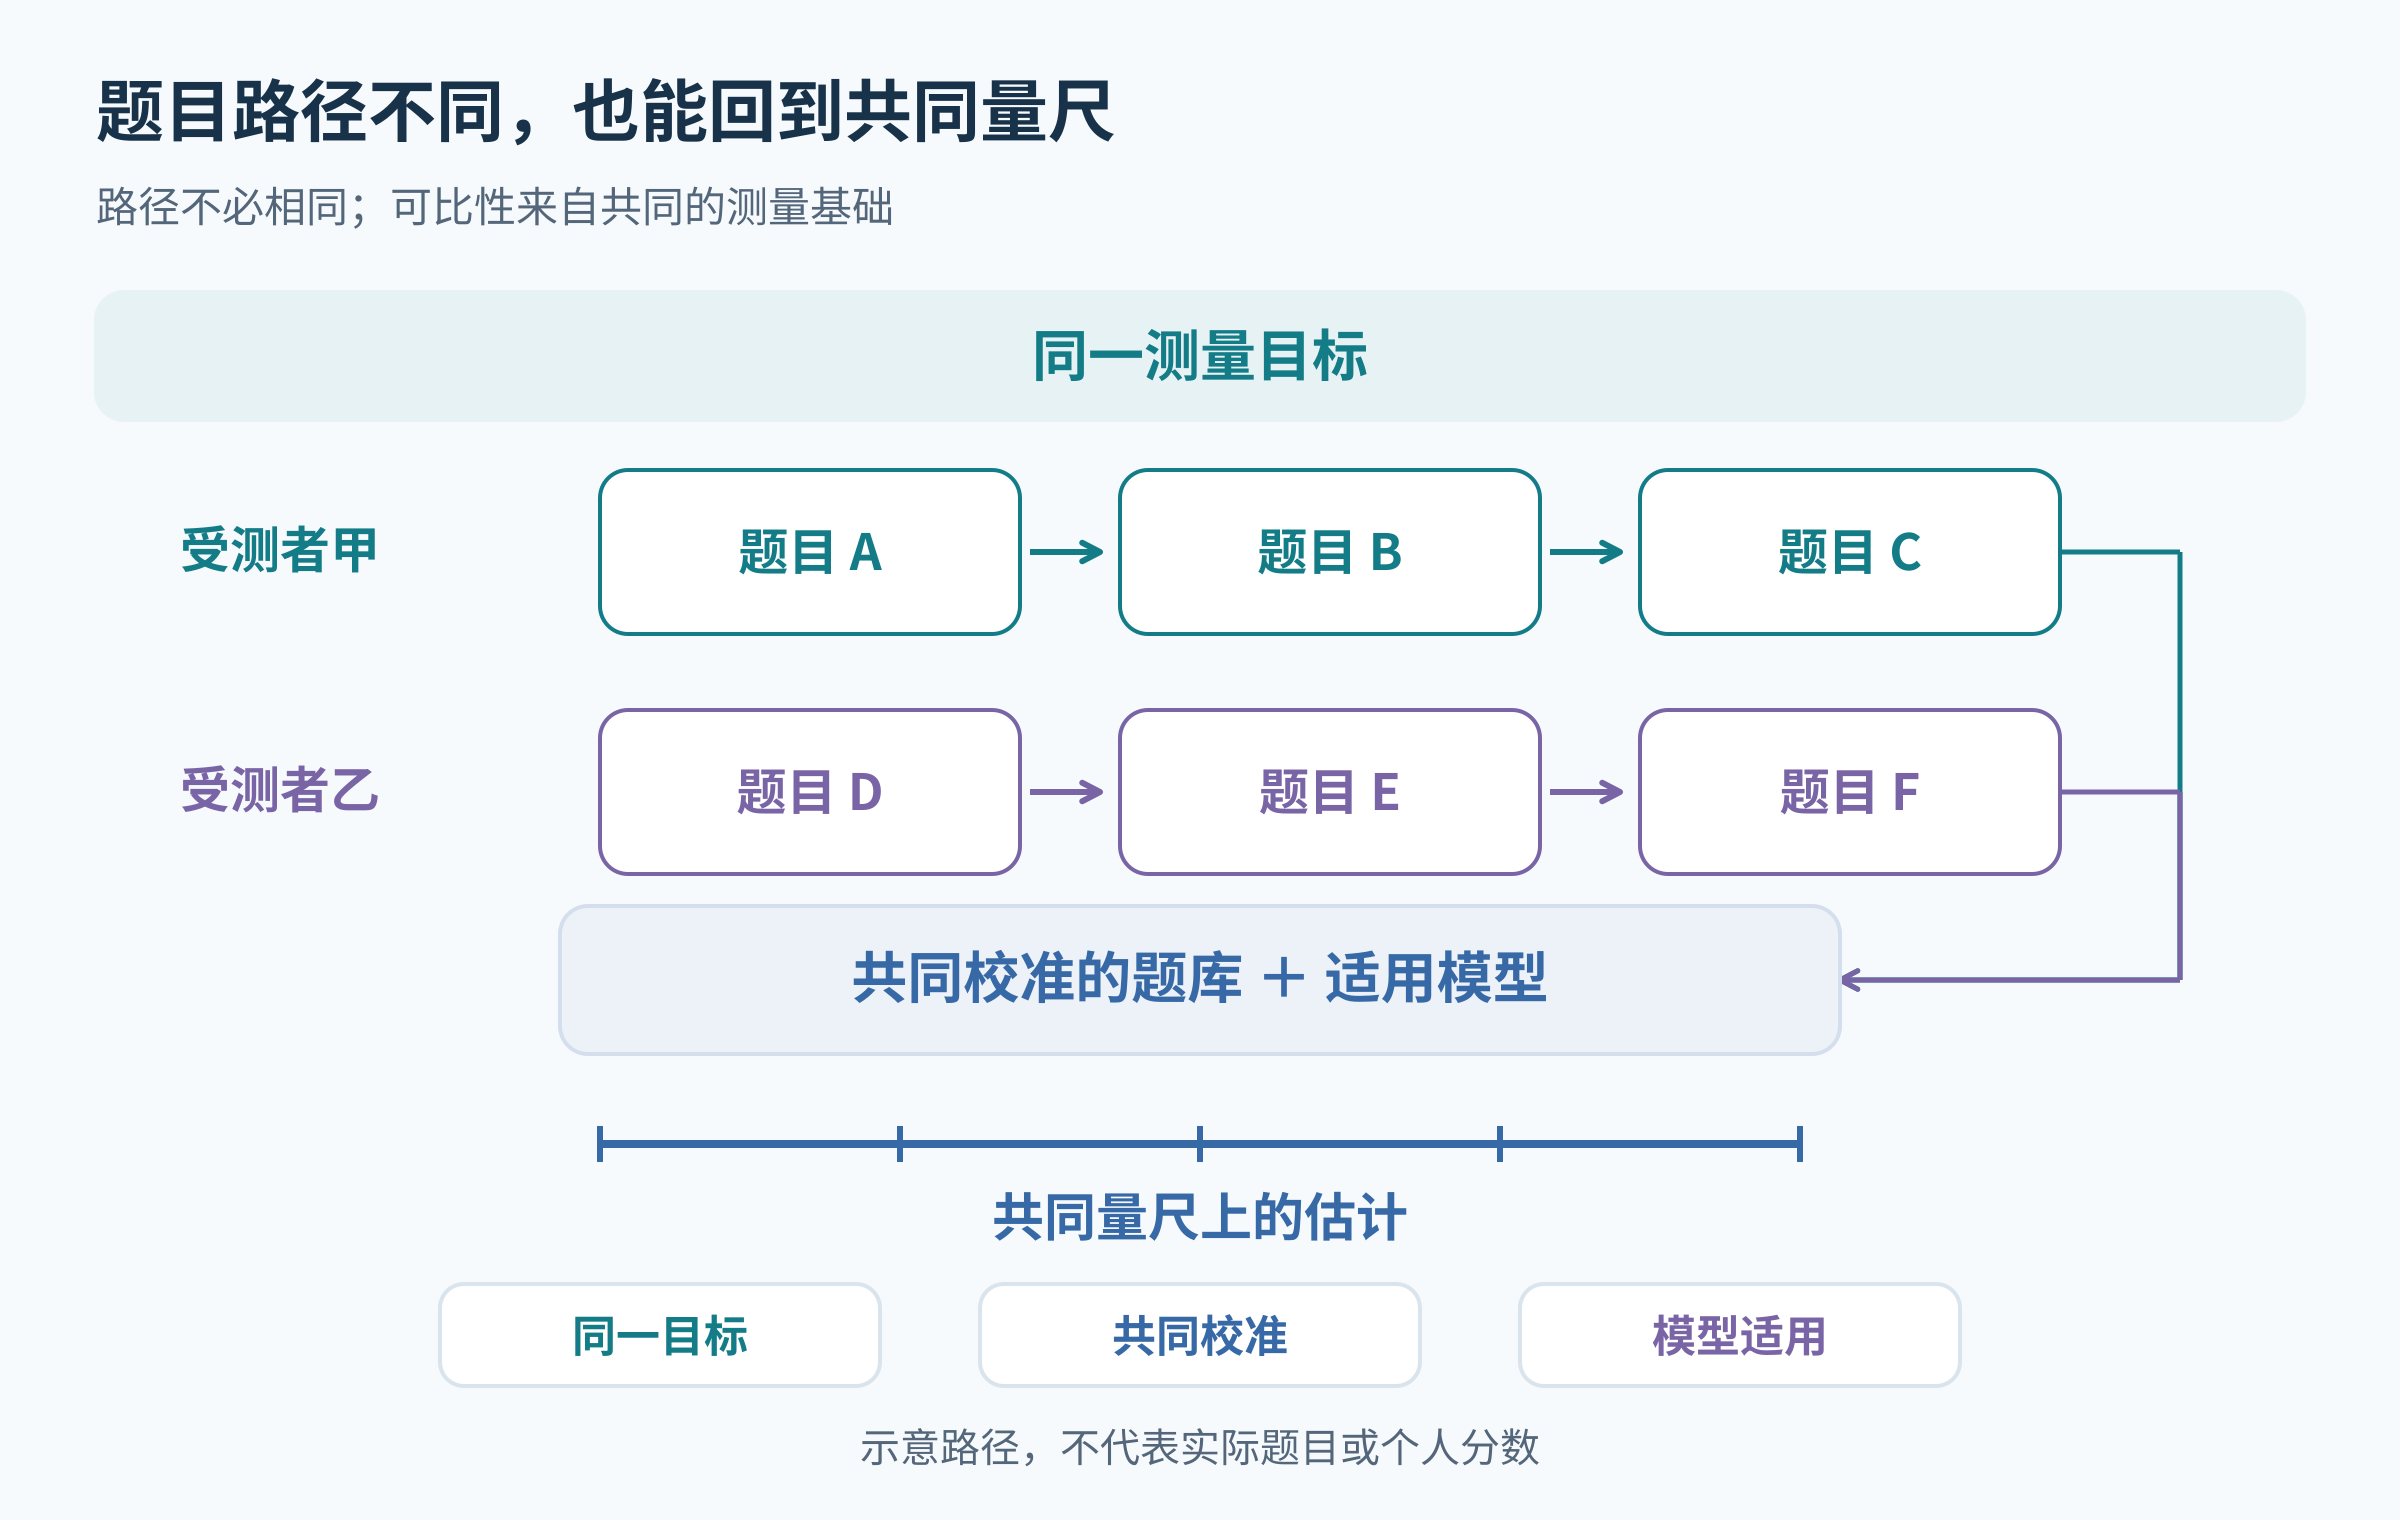
两个人做同一种自适应智力测验,看到的题目可能不同,题数也可能不同。分数还能不能比较,关键在于这些题是否经过共同校准、是否在估计同一个测量目标,以及计分模型是否适用。仅仅做到“根据回答换下一题”,还不足以保证可比。
比较的是共同量尺上的估计,不只是答对几题
计算机自适应测验(CAT)通常借助项目反应理论(IRT),利用题目特征与作答情况来估计受测者的位置。以认知测验为例,系统不仅看答对多少,还会考虑答的是哪些题、这些题在测量上有什么特征。因此,两人没有回答完全相同的题,仍可能被放在同一量尺上解释。
这依赖前期工作:题目需要在合适样本中校准,题目之间要有共同的测量基础,模型也要能合理描述作答数据。不能把两组未经校准的题交给算法,就自动得到可以比较的IQ。
CAT也可用于症状或心理特质测量。这类问卷未必有对错答案,估计的是相应症状或特质水平。不同目标仍需分开:焦虑与自尊不能因为都用了自适应技术,就混成一条“心理能力”分数。
下一题要提供信息,不只是更符合你的话题
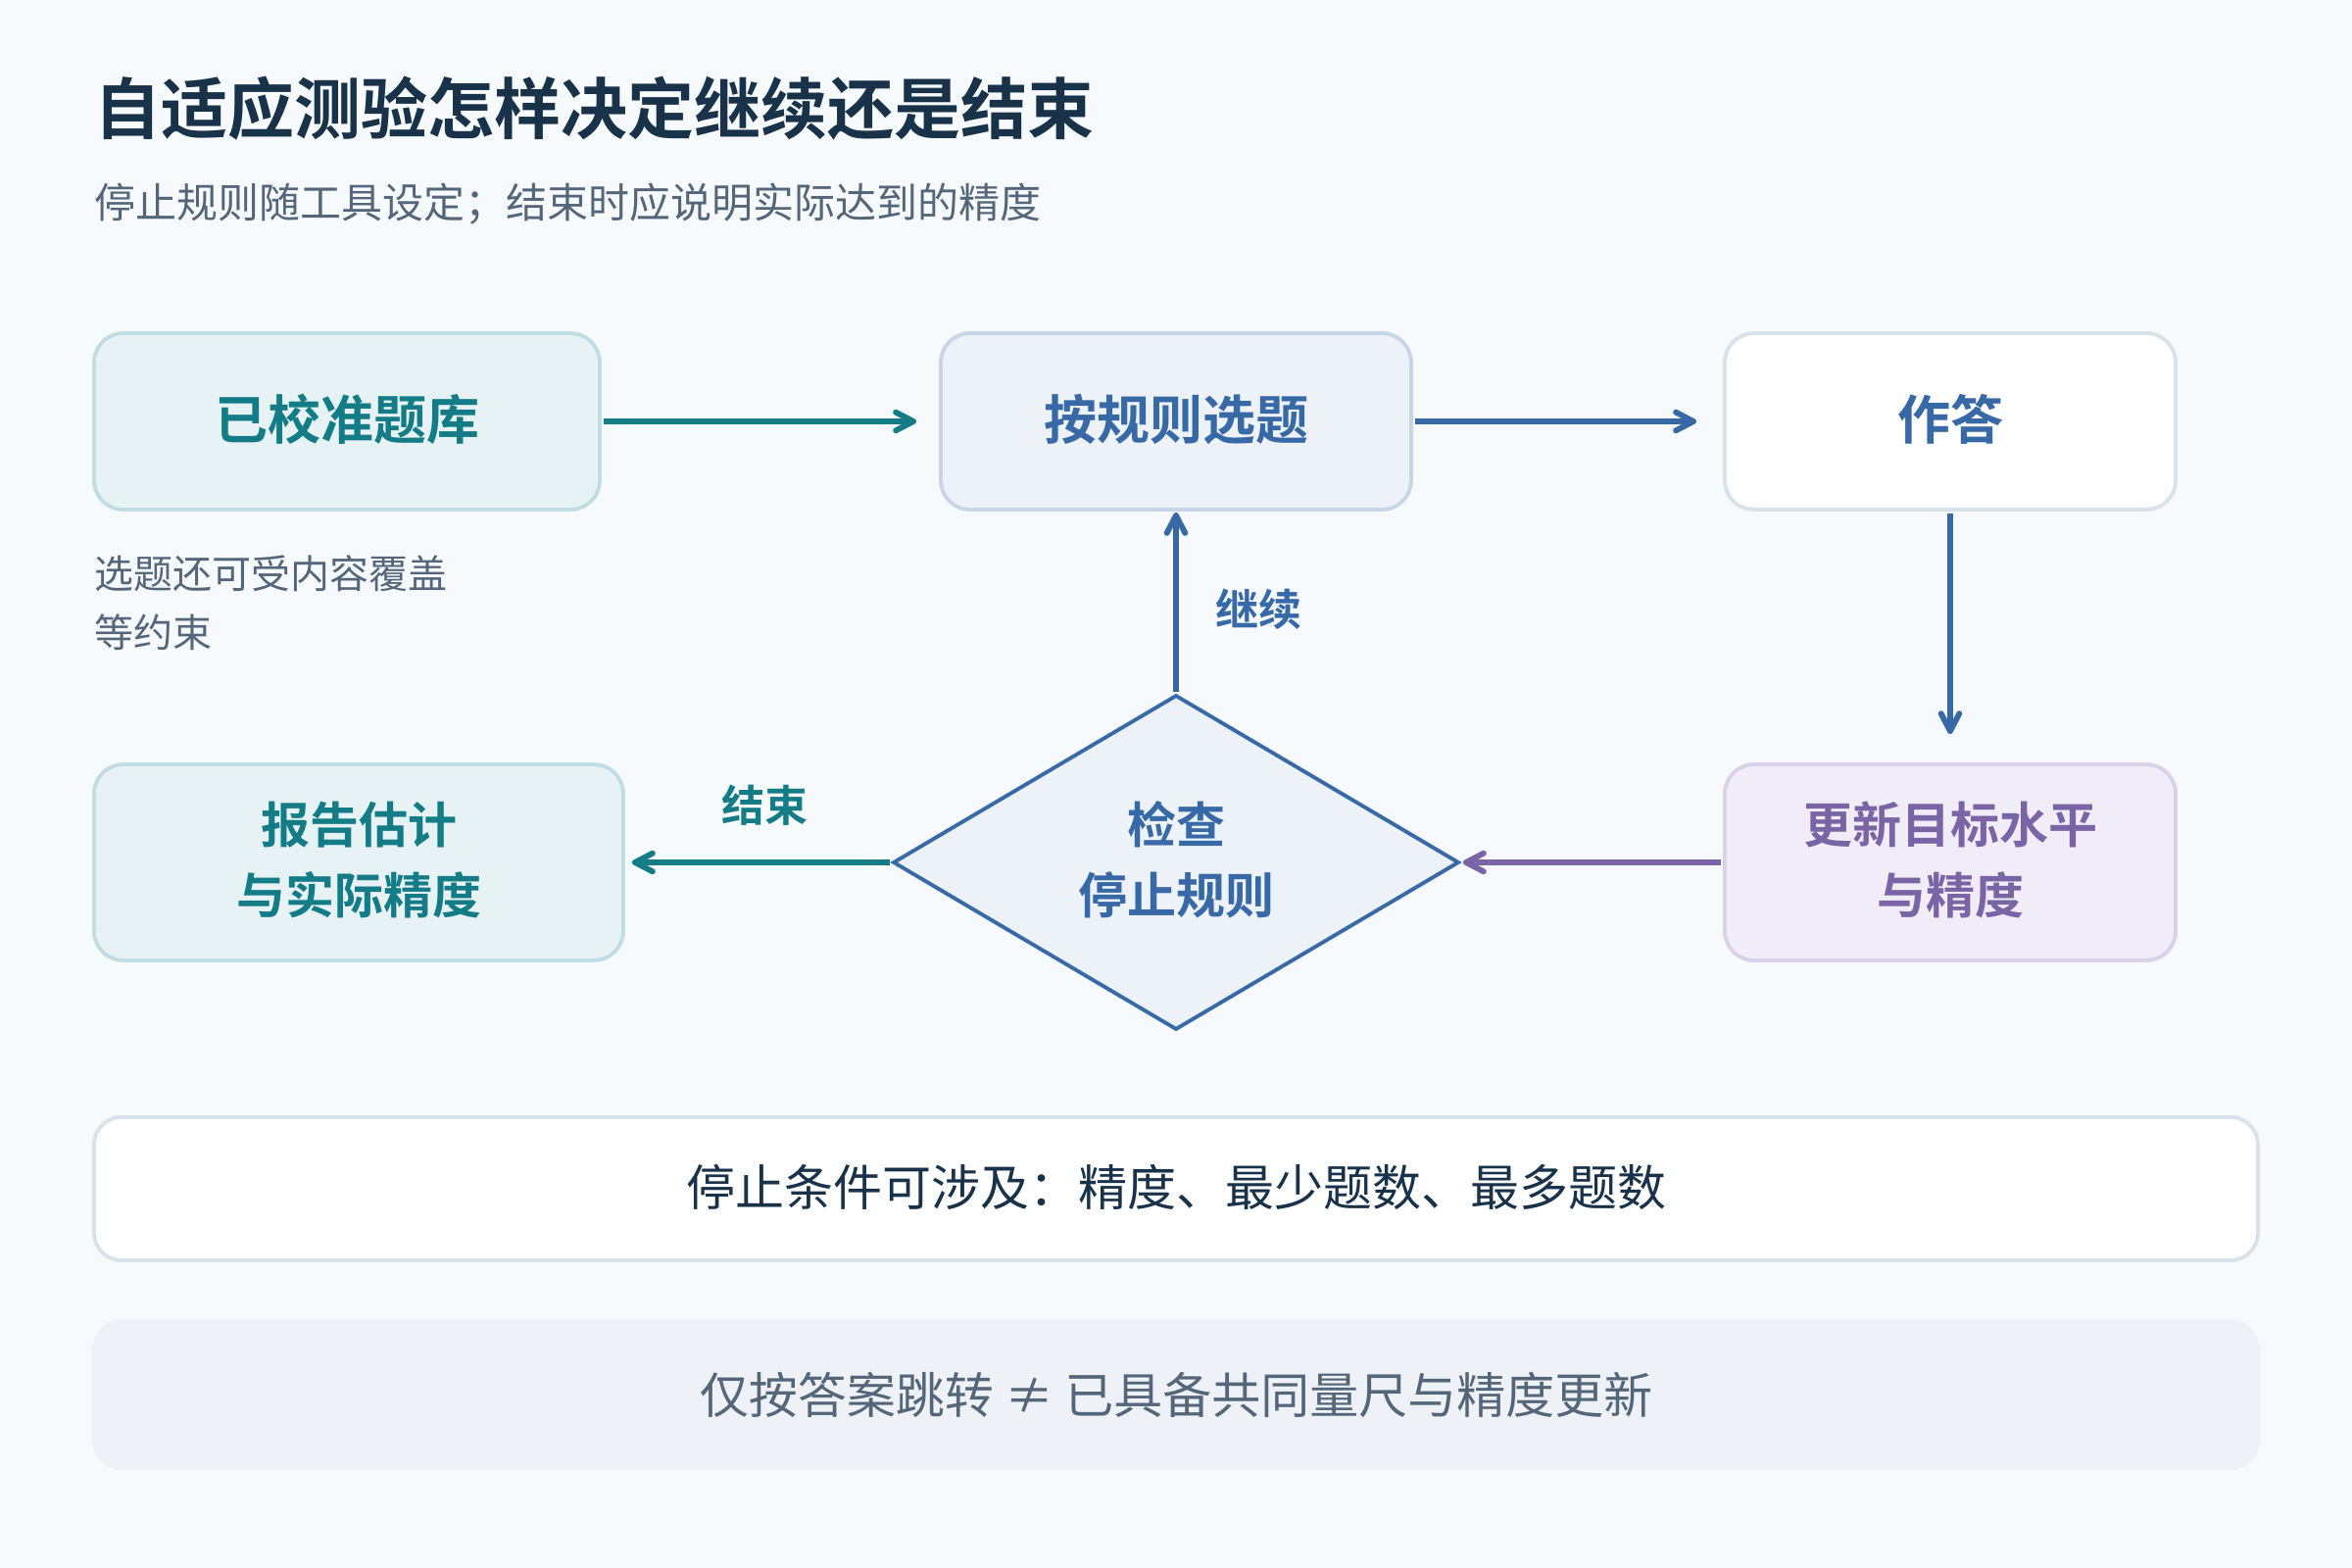
每完成一题,系统可以更新对目标水平及其精度的估计,再选择下一题。测量中的“信息量”与估计精度有关:在某一水平附近,一道题是否能帮助更有效地区分和估计位置。它不是题目被预先贴上的一个“与你匹配程度”标签。
对于认知任务,太容易或太难的题,可能不能为当前估计增加太多信息。但选题也不一定是答对就机械加难、答错就立即降级,还可能受到内容覆盖和题目使用等规则约束。
“你选了内向,所以接下来问熟人交往”则可能只是问卷分支。分支能避免不相关问题、改善填写体验,却不一定包含校准题库、共同量尺和精度更新。要判断是否采用CAT,应看实际选题与计分方法,而不只看题目是否变化。
题量减少多少,要看题库和停止规则
自适应测验有机会用更少的题获得满足用途的精度,但没有适用于所有工具的“15题抵50题”比例。题库在哪些水平提供足够信息、目标人群是谁、希望达到什么精度,都会影响最终题数。
停止可以依据精度要求,也可以结合最少、最多题数等条件。HealthMeasures对PROMIS不同CAT版本就分别说明了选题和停止规则。达到最多题数而结束,不一定等于已经达到最初希望的精度;解释报告仍要看实际误差。
固定题量的量表也可以科学、有效。比较两种形式,应该看它们是否适合同一用途、得到的分数和精度是否有验证,而非只看哪个更短、哪个名字里带“自适应”。
实际使用时,核对具体版本和解释范围
自适应技术也可用于某些心理特质或症状测量,具体价值取决于题库校准、目标人群和精度验证。不同困扰是否需要不同问题,也可能由普通问卷分支实现,应与CAT区分。
像橙星云这样的平台,在服务超900万用户的过程中,就将这类技术应用在情绪管理、两性关系、青少年心理等多个场景,让4500多万份报告更贴近真实状态。
对于眼前这一份测评,可以进一步核对四件事:测量目标与确切版本、题库的适用人群、选题和停止规则,以及结果如何说明精度与用途。平台层面的介绍不能替代具体测验版本的技术资料。看到“几分钟了解自己”时,也不必直接认定不可信;先看这些信息能否支持它给出的结论。
更短、更顺畅是值得争取的体验,但心理测评最终要回答的是:这份结果,对你的具体问题有多大解释力。