

先做了瑞文,后来又做韦氏,两个结果一高一低,很容易让人想再测一次,找出一个“真正的智商”。但在比较数字之前,需要确认两次结果是否在描述同一范围的能力、使用同一类参照。
两个报告都出现商数或标准分,并不意味着它们可以直接取平均。较高的一个也不会因为更令人满意,就自动成为更准确的答案。
图形推理与综合认知测验,取样范围不同
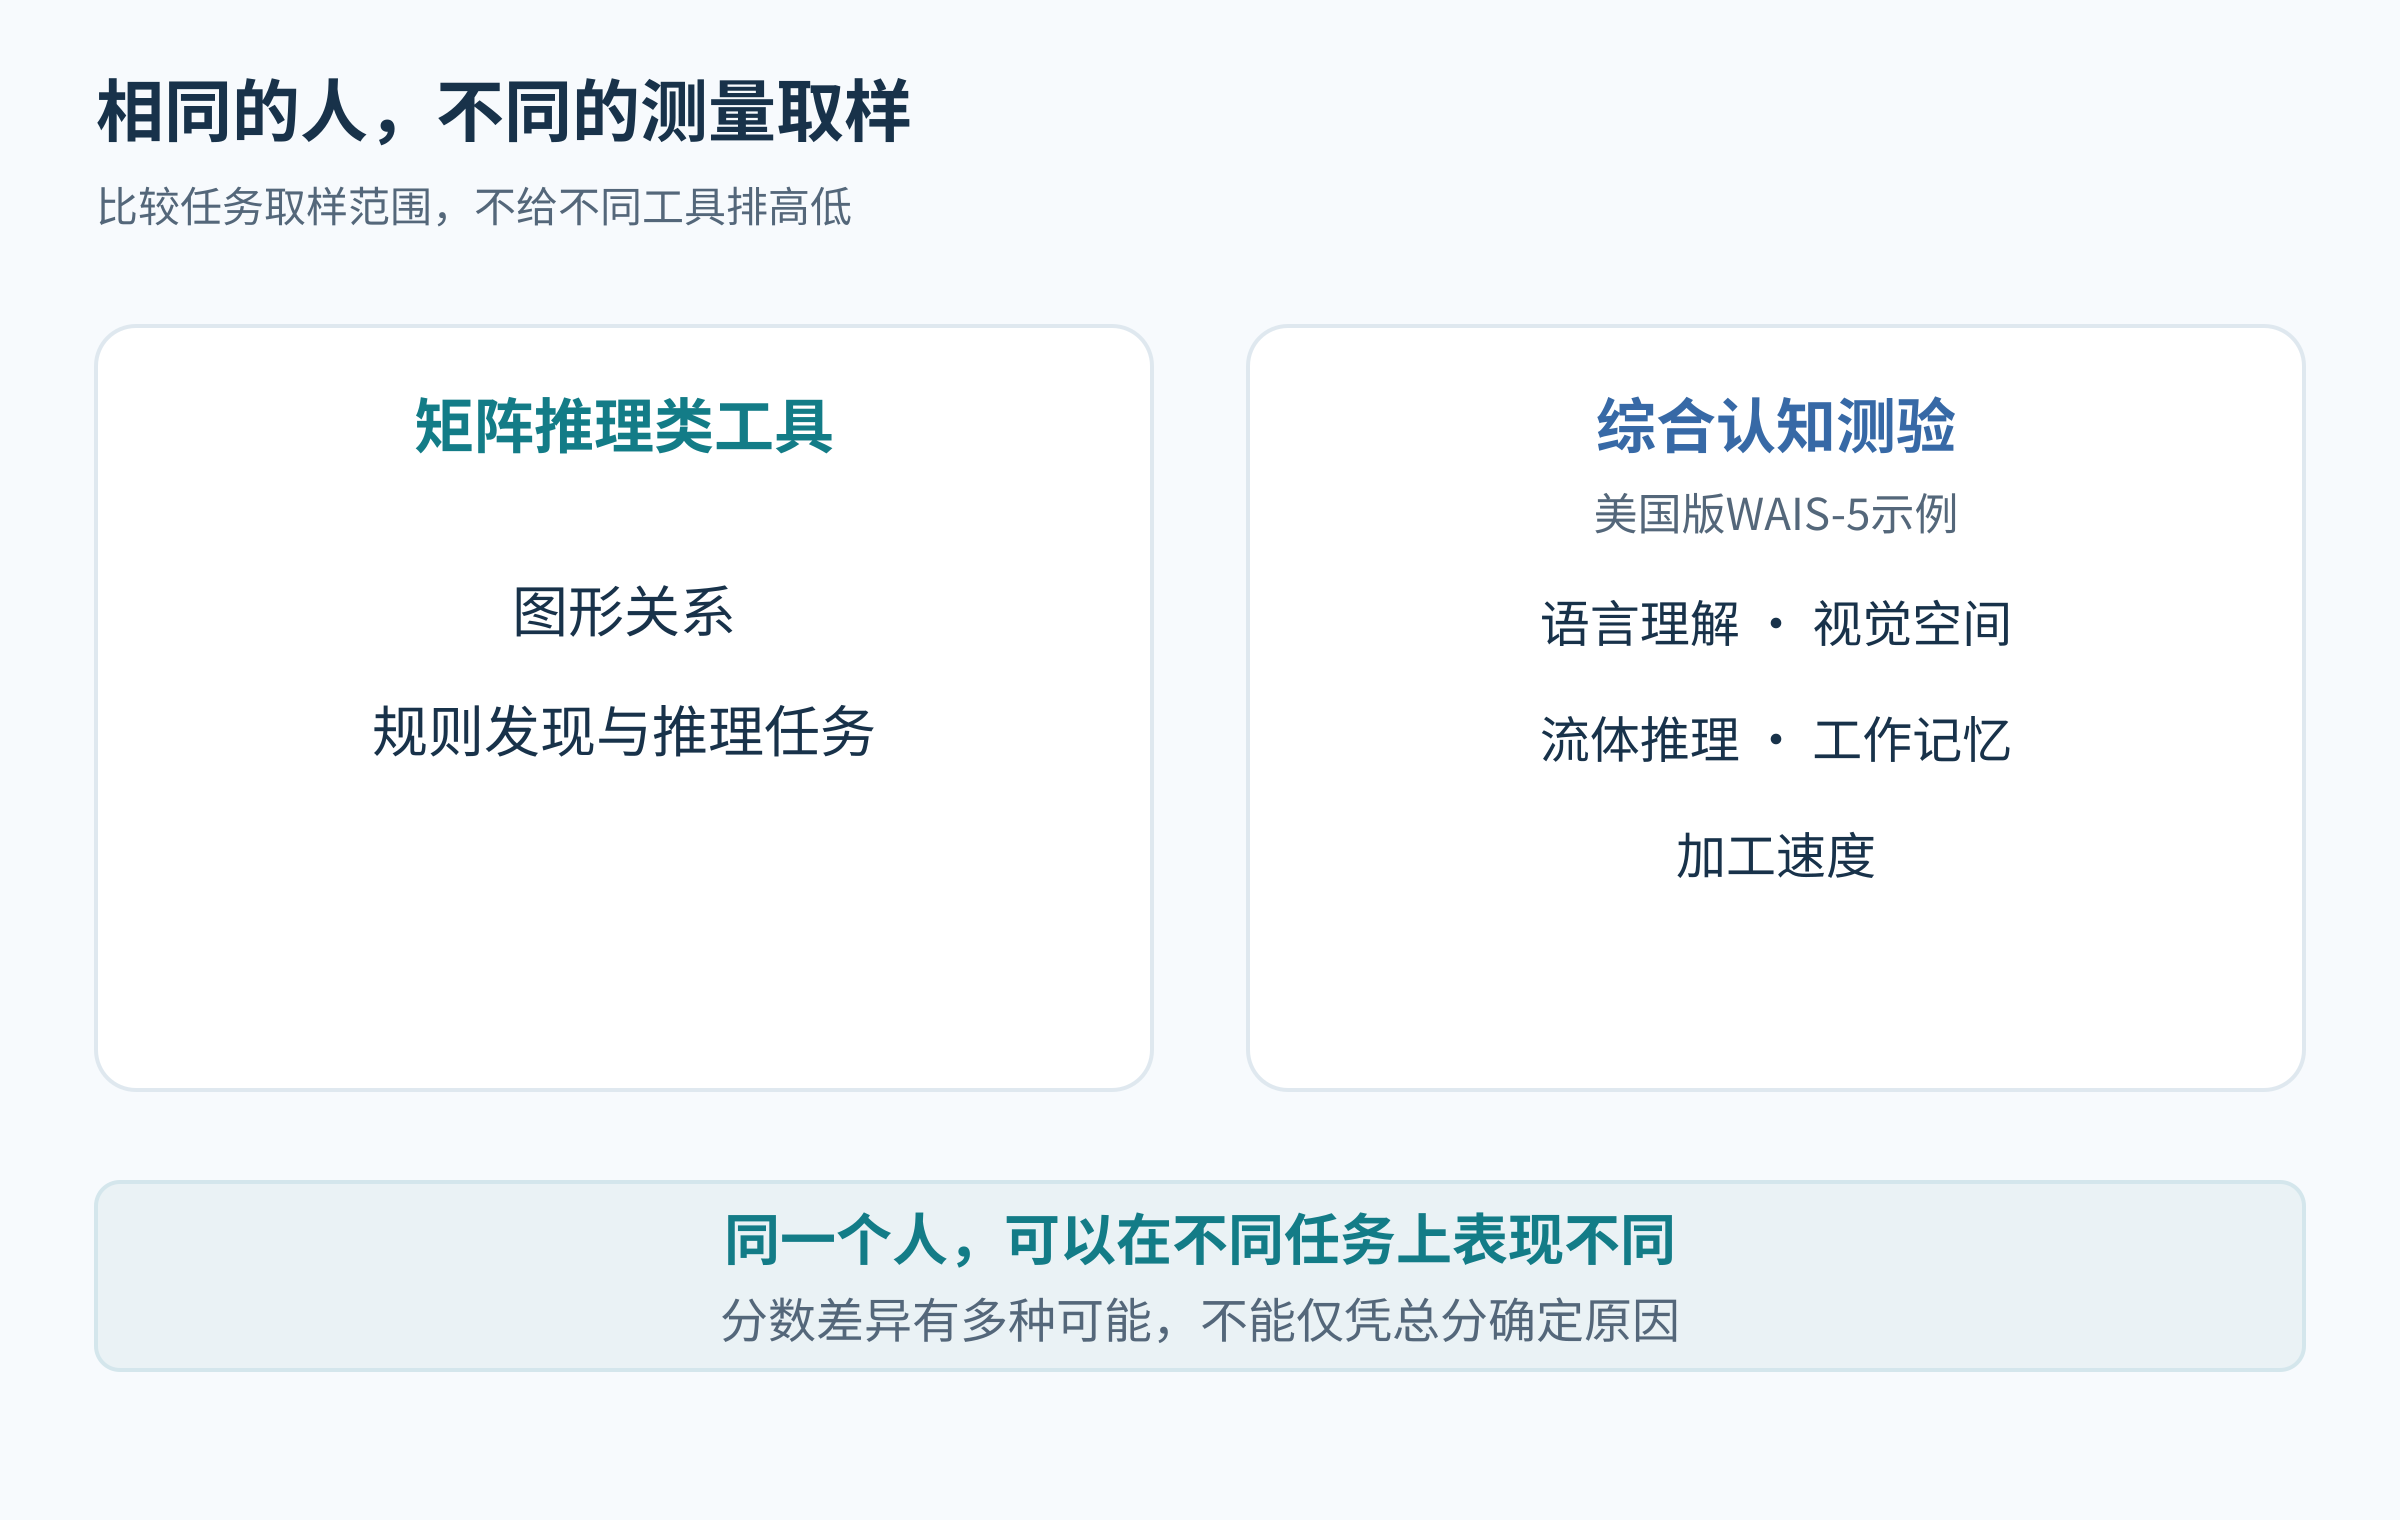
瑞文类矩阵推理测验,主要通过图形关系考察相应的推理表现。具体版本之间也有区别,不能把标准型、高级型、彩色型和Raven’s 2当成可以随意替换的名称。以Raven’s 2官方介绍为例,其特点包括降低语言要求及文化差异影响。[2]
韦氏类综合认知测验则通常采集多个认知领域的信息。例如美国版WAIS-5区分语言理解、视觉空间、流体推理、工作记忆和加工速度。这个例子只说明覆盖范围,不意味着中国正在使用的所有版本都与它相同。[1]
因此,一个人对图形关系很敏锐,其他类型任务相对普通,综合结果与矩阵推理结果不同,并不难理解。不过,这只是需要核对的一种可能。单凭两份总分,还不能确认差异一定来自某个能力领域。
看起来一样的刻度,可能指向不同参照
除了测量内容,两次报告还可能用了不同年龄组、地区、语言或年代的常模。即使都把平均分设为100,参照人群与转换规则也未必一致。把两种结果改写成同样的数字范围,只改变了外观,没有证明它们可以互换。
《教育与心理测验标准》对分数链接和等值解释要求有相应证据。这个原则可以帮助普通读者少走一步弯路:不要从网上找一张没有来源的“瑞文转韦氏公式”,把本来需要分别解释的信息硬压成一个分数。[3]
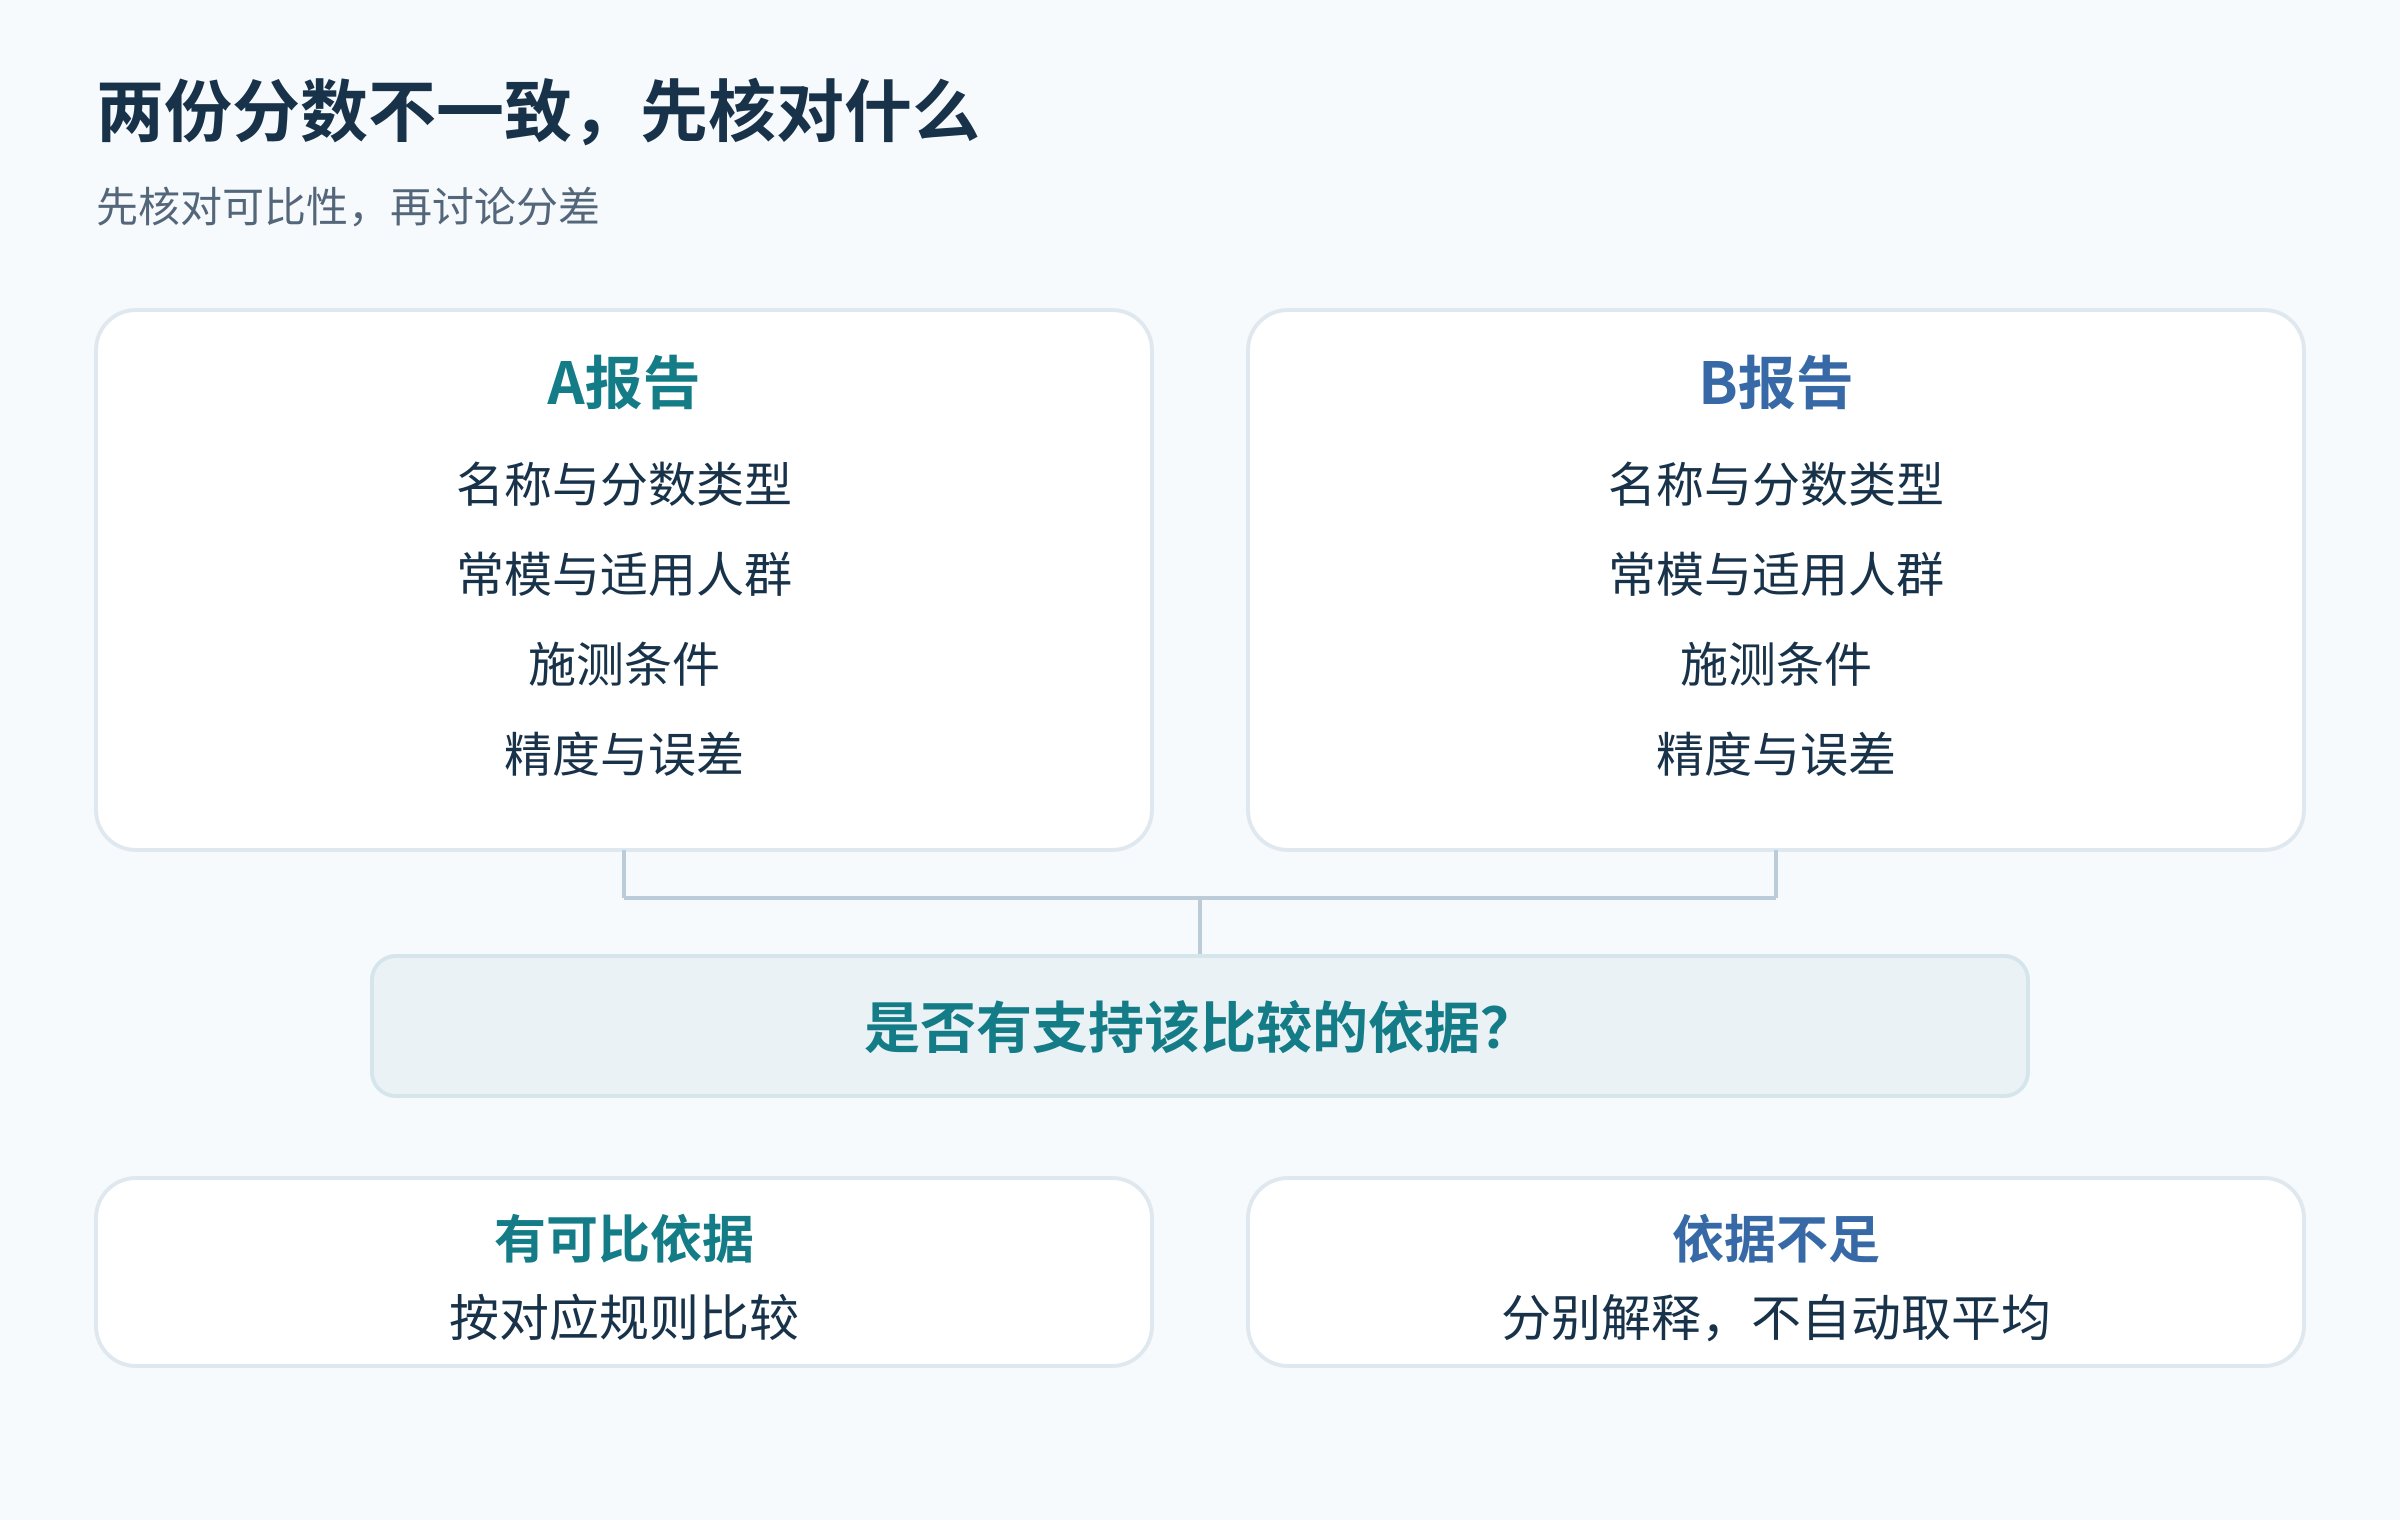
把两份报告并排,按这个顺序核对
| 核对项 | 需要找到的信息 |
|---|---|
| 工具与结果名称 | 全名、具体版本;给的是总分、某项指数、原始分还是百分位。 |
| 测量范围 | 覆盖哪些能力;两份报告是否在解释同一个问题。 |
| 参照人群 | 采用什么常模,是否适合本人及本次用途。 |
| 施测情况 | 日期、环境、中断或协助、同类题接触情况与行为记录。 |
| 不确定性 | 有没有误差或区间,跨工具比较是否有支持依据。 |
这张表的作用,是把“到底信谁”变成可以询问的具体问题。若其中一份只有网页截图,没有工具和常模信息,先承认它的解释依据不足,不需要让另一份正式报告迁就这个数字。
“以哪个为准”,要回到当初为什么测
如果要了解的恰好是图形推理,相关工具的结果可能更直接;如果需要观察多个认知领域,应关注适合该目的的综合评估。真正的选择依据是评估问题和测量证据,不是哪个名字更有名,也不是哪个分数更高。
可以把两份原报告交给负责解释的专业人员,请对方说明哪些信息能够相互补充,哪些不能直接比较。如果两次工具、目的和条件差别很大,合理的结果可能就是保留两份不同的信息,而非一定找出一个唯一数字。
先不要为了消除差异反复刷同类题。保留完整资料、说明之前参加过什么测试,比重新累计更多难以比较的分数,更有助于下一次评估。