
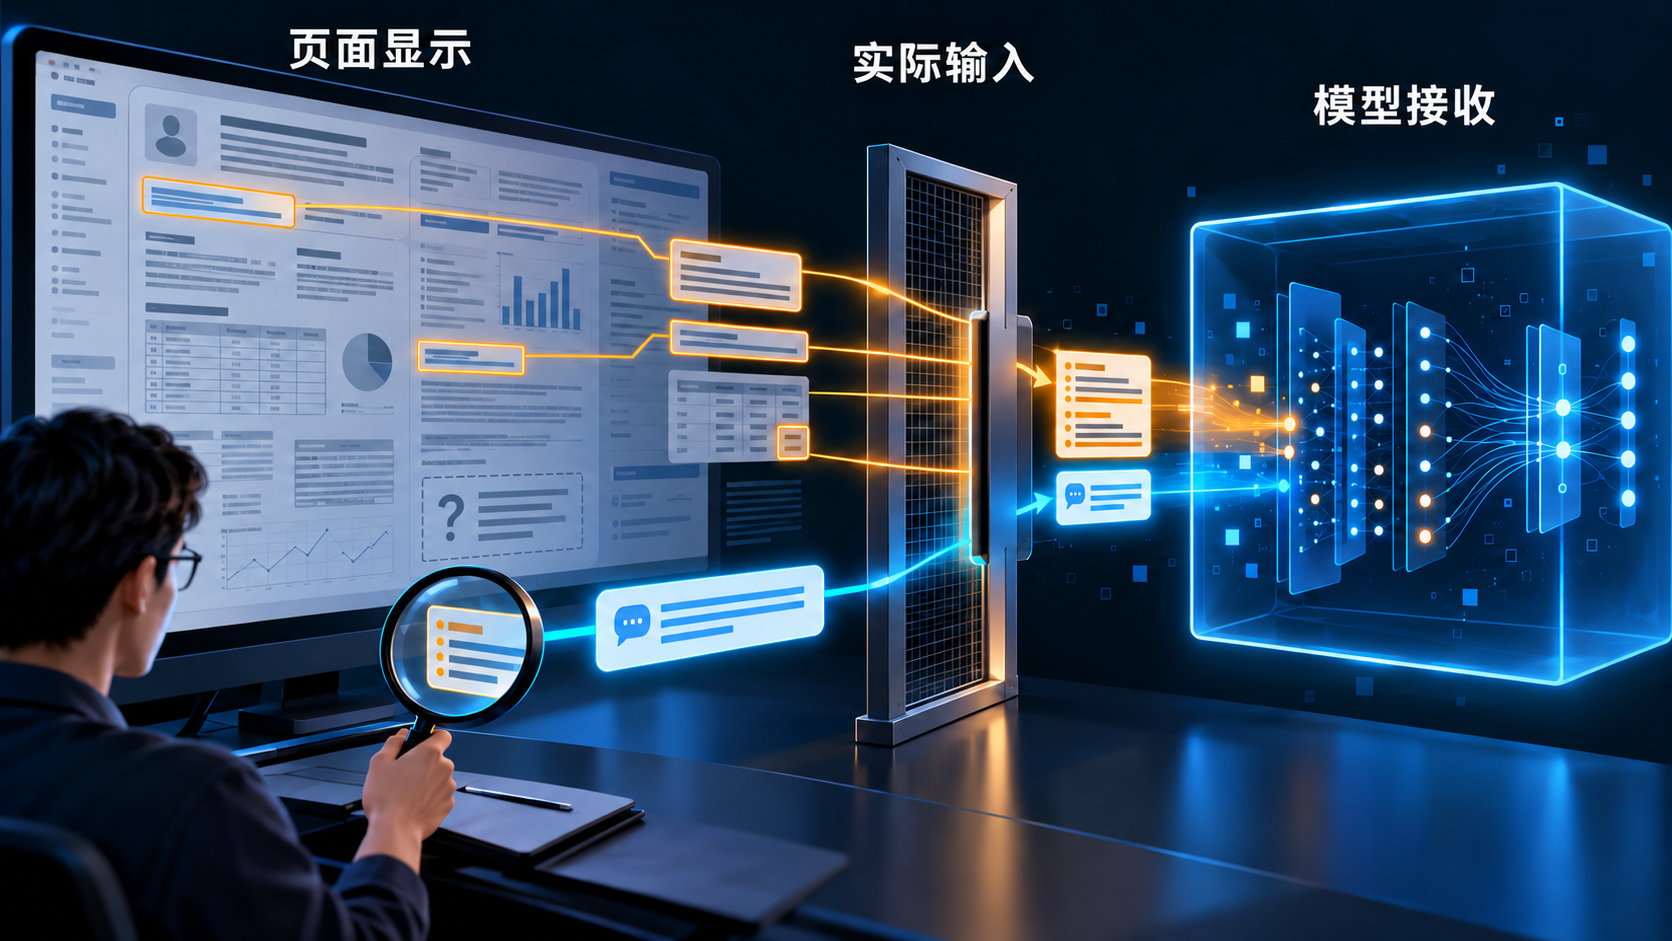
心理测评报告里的信息,可能随着一次提问进入模型处理流程。机构准备使用AI报告分析时,除了看回答是否有帮助,也需要知道本次功能会使用哪些材料,由谁处理,之后怎样保存。
橙星云的AI报告分析支持围绕当前报告继续提问,辅助工作人员阅读和整理思路。这个功能定位,不能代替对具体部署方案数据流的说明。先把当前报告、追加提问和模型接收范围核对清楚,再决定哪些工作适合使用。
不只看报告里有没有姓名
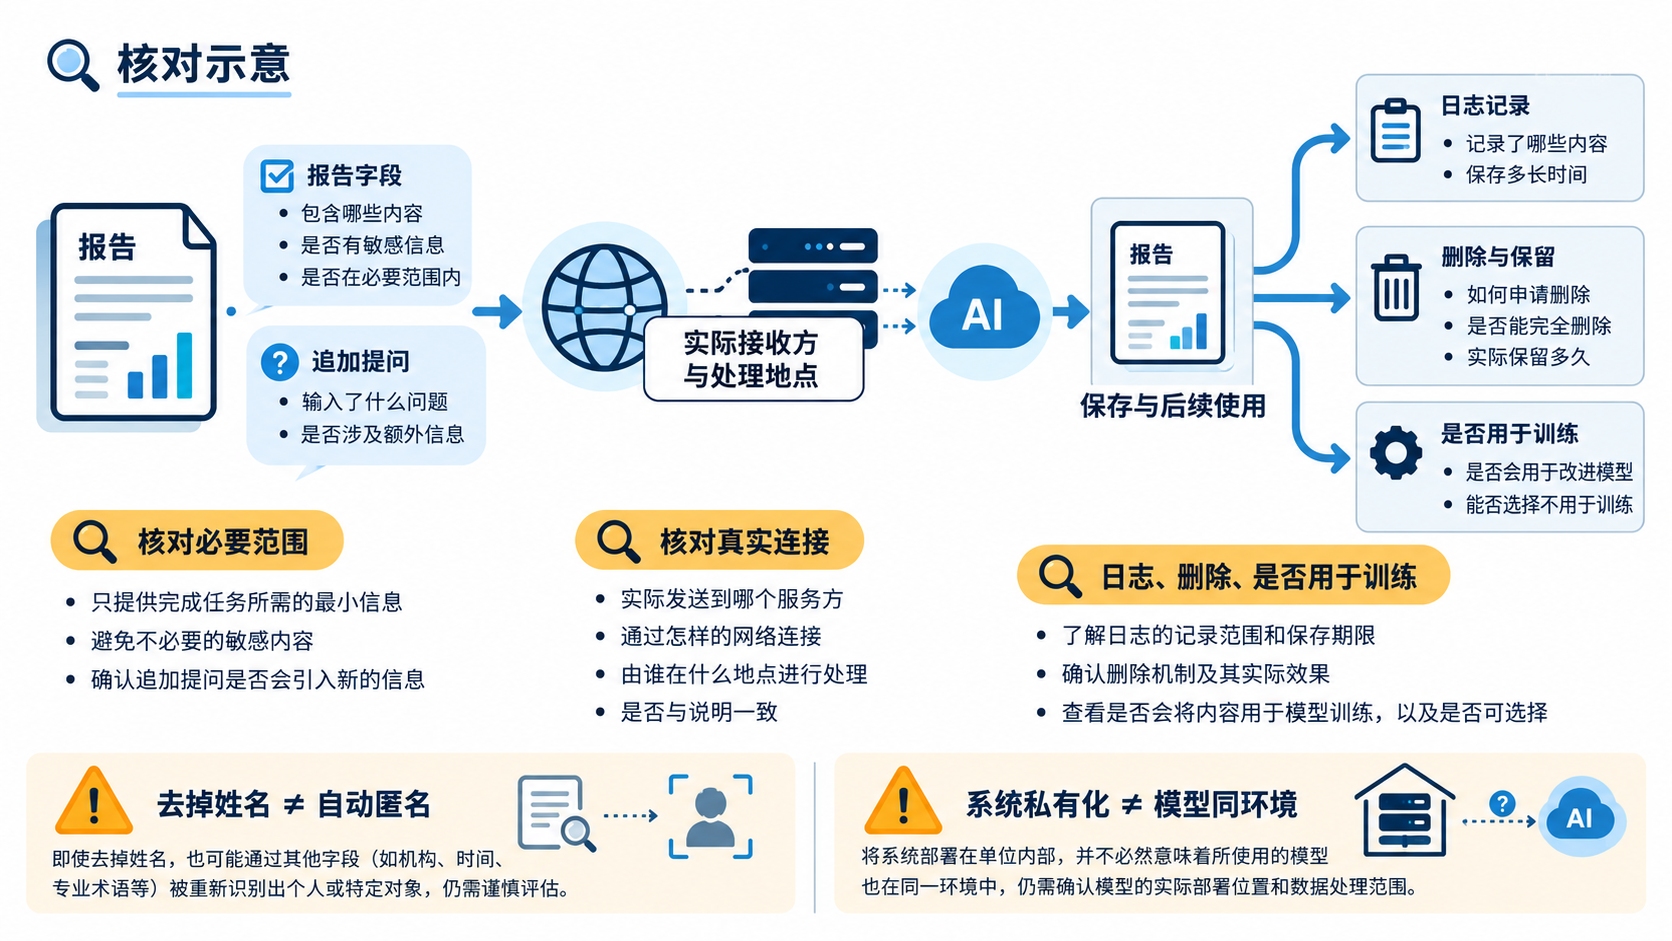
请服务方说明实际参与处理的信息范围:报告哪些字段、有关受测者的哪些上下文、工作人员输入的提问,以及可能附带的其他内容。还要确认哪些信息只是显示在系统页面上,哪些会用于模型请求,两者不能凭界面相邻就视为相同。
删去姓名后,分数、机构、岗位、日期与一段具体经历仍可能帮助识别个人。结构化分数并不天然等于匿名数据。工作人员追加的问题也可能重新带入身份信息,因此使用规则需要覆盖提问内容,而不只是报告模板。
可以用不含真实个人资料的测试材料,请服务方解释一次典型流程所需的信息。对阅读当前报告没有必要的背景,不应为了让回答“更全面”就一并输入。
问清谁接收,而不是只问在哪里部署
说明材料应能回答:应用系统与模型分别由谁提供,处理发生在哪里,是否还有其他服务方参与,哪些记录会保存,以及相应的保存和删除安排。
私有化部署测评系统,不自动说明模型也在同一环境运行;专属实例也需要确认实际连接与运维安排。反过来,信息提供给机构之外的境内服务方,也不应直接称为数据出境。是否向境外提供信息,要根据实际接收和处理安排判断。
个人信息保护法分别规定了委托处理、向其他处理者提供以及向境外提供个人信息的要求。机构应按实际关系与数据流核对适用安排,不能用一个笼统的“不出域”承诺代替这些说明。
使用条件要能落到日常操作
确认服务方是否为提供本次功能之外的目的使用输入与输出,例如模型训练;确认日志、提问记录、分析结果分别如何保存。重要约定应进入相应服务说明或协议,并与实际配置一致。核查记录可以保留字段范围和处理过程说明,不必为了留证另存一套完整敏感请求内容。
工作人员还需要知道哪些问题可以输入,遇到不必要的个人背景怎样删减,发现异常接收范围或不当回答找谁处理。模型或服务方案变化时,再核对一次原有说明是否仍然适用。
AI生成的文字继续由具备相应能力的人员结合原报告与服务情境判断。它可以帮助理解和追问,不替代专业判断,也不能作为医疗诊断依据。把输入、接收和使用责任说清楚,机构才更容易把这项辅助功能稳定地用起来。