
有些心理测验会根据前面的回答调整后续题目,这叫计算机自适应测验(CAT)。它通常借助项目反应理论(IRT)估计要测量的特质,并挑选更有信息量的题目。不过,报告让人感觉“很准”,并不能证明它用了CAT,也不能代替对测验质量的检验。
固定问卷让每个人回答同一组题,便于标准化施测和比较。自适应测验则从经过校准的题库中选题,争取在较少题量下达到预定精度。IRT不是固定的三个参数,而是一组模型:能力题可能用答对、答错建模,有些模型包含猜测参数;焦虑、人格等自陈题通常没有标准答案,可能采用分级反应等适合多级选项的模型。
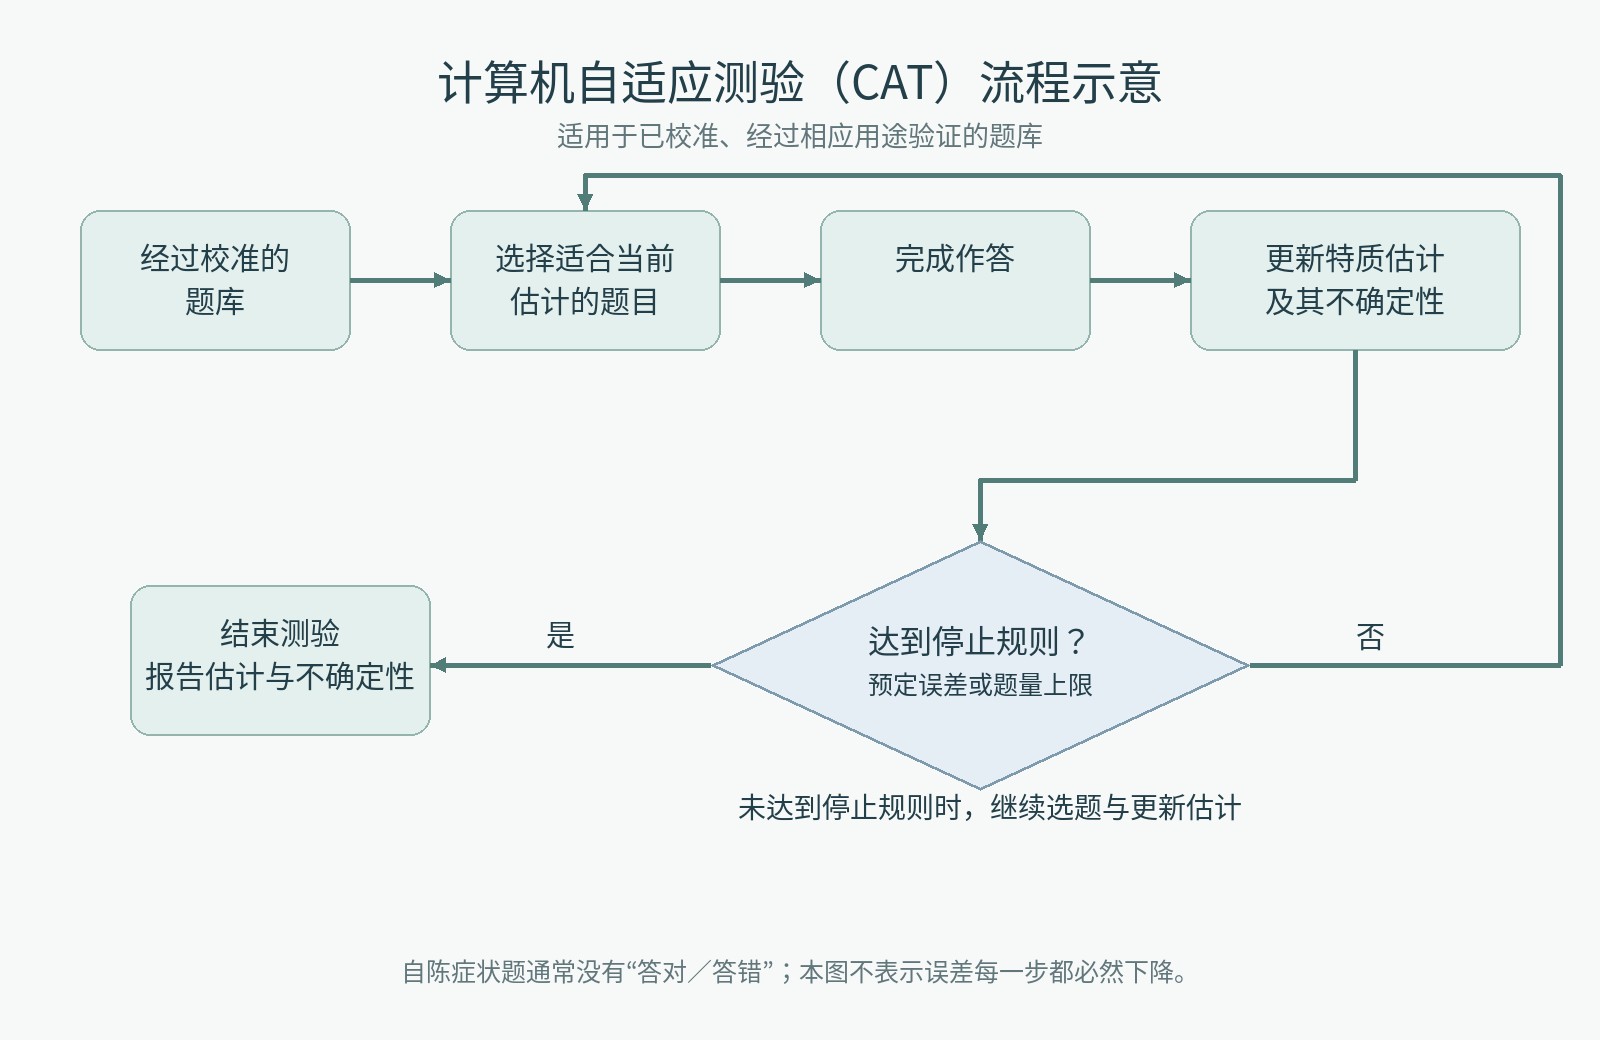
以症状问卷为例,系统会根据已答题目更新特质水平及其不确定性,再选择适合当前估计、能提供更多信息的题目。这里不是“答对就升级”,而是继续减少测量的不确定性。达到预定误差或题量上限后,测验才结束。题库校准、模型拟合、不同人群的公平性以及实际应用验证,都是使用这套方法的前提。
自适应测验能否用于学校筛查或职场评估,要看具体题库是否在相应人群和用途上经过验证。较少的题目不自动意味着更准确,健康筛查结果也不应直接当作用人依据。像橙星云这样的平台,在多年实践中已累计生成超过4500万份心理测评报告,服务近千万用户。其测评体系覆盖职业发展、两性关系、亲子互动、情绪管理等多个维度,正是依托于这类科学建模方法,才能在保证专业性的同时,让普通用户也能轻松理解自己的心理画像。
阅读报告时,可以把反馈和近期生活对照:哪些描述符合实际,哪些需要进一步询问?如果困扰持续影响睡眠、工作或关系,测评可以帮助整理就诊或咨询时想讨论的问题,但不能独自定位病因或给出诊断。
选择测验前,不妨先看它说明了什么:测量目标、适用人群、版本、误差以及验证资料。这些信息,比题目是否显得“懂你”更能帮助判断结果是否值得参考。