
GERT-S让人看带声音的视频,利用脸部、声音和身体动作来识别情绪。相比只看静态脸图,它提供了更多种线索;但最终分数仍是这个规定任务中的表现,不能直接解释成“现实中总能看透别人”,更不能当作完整情商分数。
它多给了哪些信息
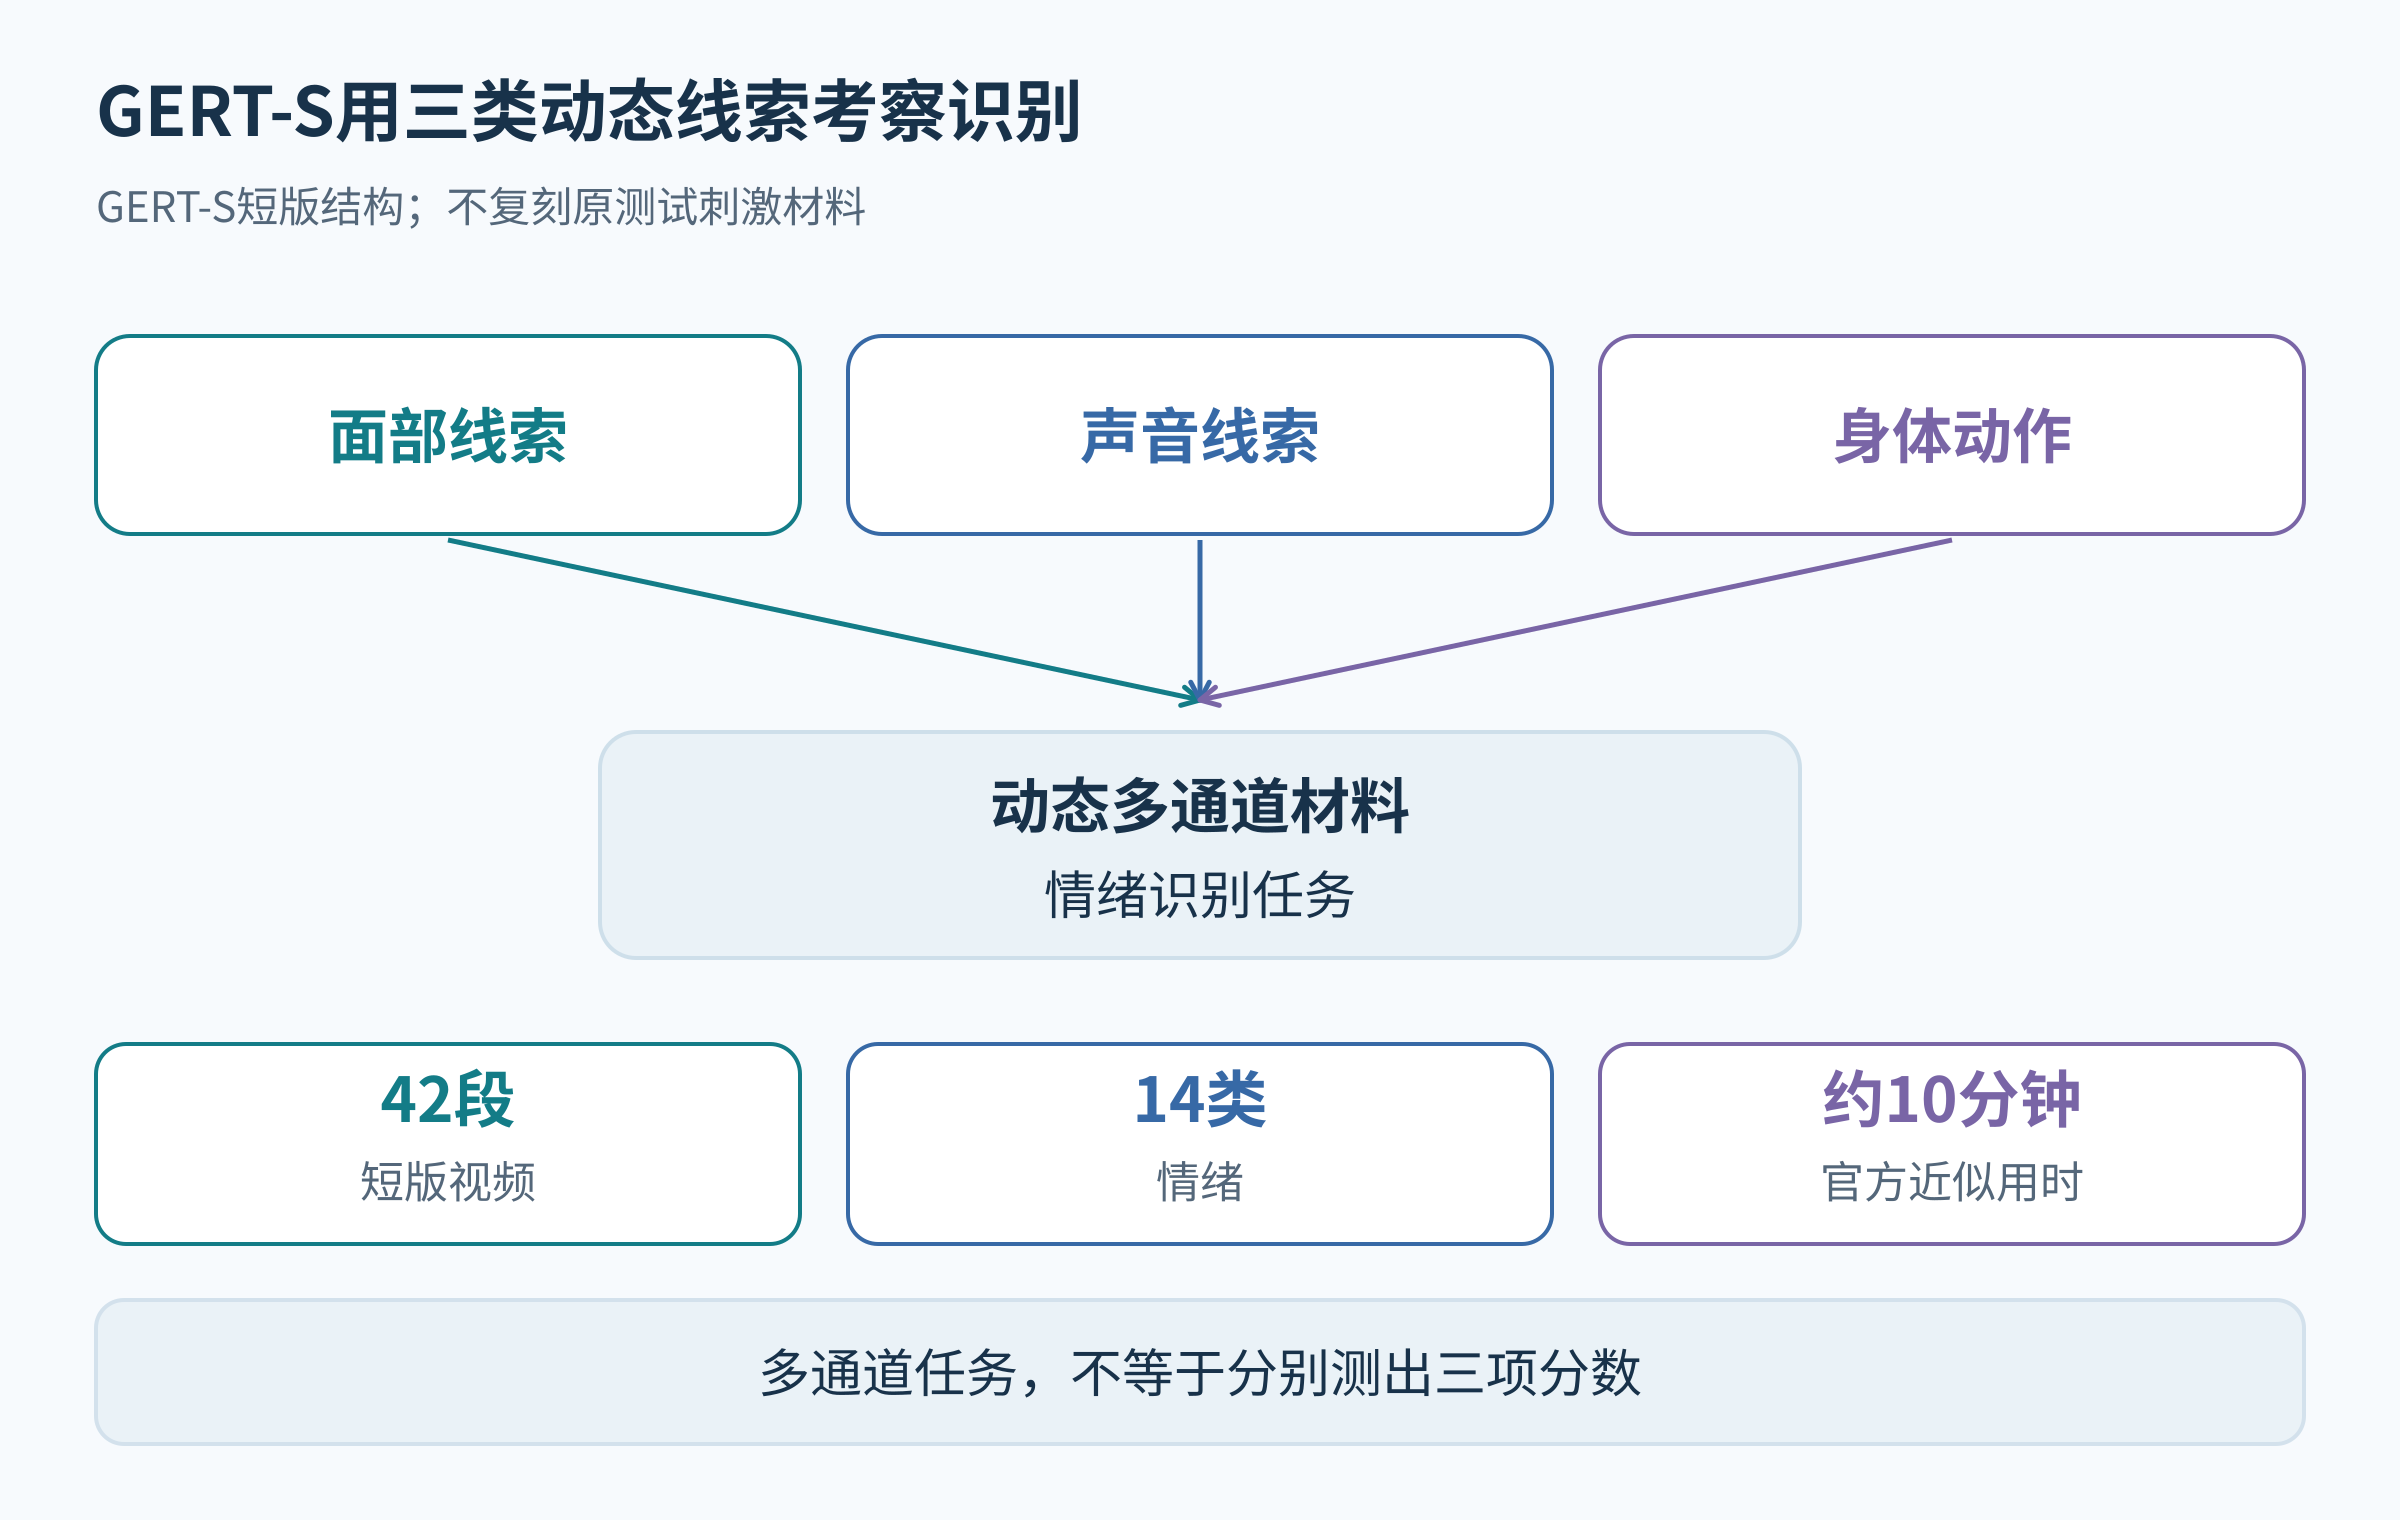
日内瓦情绪识别测验的短版GERT-S含42段短视频,涉及14类情绪,官方近似用时约10分钟。全版GERT则有83段,两者不要混写。材料由演员表达情绪,观看者依据片段作出识别判断。
动态面部变化、声音和身体姿态可能提供互相补充的线索。这种设计扩展了刺激内容的覆盖,不再只围绕少数基本情绪的静态照片。它测的是在这些线索下识别他人情绪的表现,不是询问“你觉得自己多会察言观色”。
有测量证据,不等于覆盖了全部情商
2016年介绍GERT-S的两项研究共涉及425人,检验了内部一致性、因素结构及与其他测量的关系。结果支持将它作为简短的情绪识别表现测验;它与其他识别测验、情绪理解管理任务及认知能力存在正相关。
相关不表示这些工具可以互相替代。能够较好地判断演员在表达什么情绪,不等于已经测过一个人如何安慰朋友、在冲突中调整反应,或愿不愿意关心他人。
同样,多通道材料不自动提供“看脸能力”“听声音能力”“看动作能力”三个独立分数。若所有线索一起出现,一次正确判断无法单独说明究竟依赖了哪一种线索。要比较各通道,还需专门设计和验证。
演员表达与真实生活并不相同
标准化材料让不同参与者面对较一致的刺激,便于研究比较;现实互动却有关系历史、当前处境、语言内容和对方的反馈,情绪也可能混合或表达得不明显。
因此,片段判断与生活理解之间的关联需要实际证据,不能只因“有声音、有动作”就认为已经完整模拟生活。也不能把答对比例直接叫作“情商百分位”,或凭一次低分推断某种临床问题。

读分数前,先确认材料和版本
如果视频声音没有正常播放、画面不清楚,或受测者没有理解情绪标签,所完成的就可能不是原设计的任务。施测和解释应按具体版本要求进行,不能临时关掉声音后仍直接套用同一解释。
开发机构提供多种语言资源,包括中文。语言资源可获得,与在某个中文人群中已有充分常模和用途验证,仍是两件事。应用时应核对确切版本、样本与目的,不把“有翻译”写成“适用于所有人”。
对普通读者,较有价值的理解是:这项成绩提供了一个有关多线索情绪识别的观察角度。放回生活中时,保留询问和核实,比把测试高分当作永远不会看错人的保证更可靠。