

一张团队测评表很容易让人产生直觉:把每个人的情商分数相加、除以人数,就能知道这个团队好不好合作。如果两个部门平均分相同,沟通表现应该也差不多。可团队的工作不是一场人人独立作答的考试:谁接收消息、谁能提出异议、谁负责交接,都可能改变协作的样子。
员工平均分可以描述一组人的某种测评特征,但从这一步走到“预测团队协作”,还需要回答几个具体问题。它不是算术错了,而是我们可能把平均数没有包含的东西,也一起读进去了。
同样的平均分,可能是不同的团队
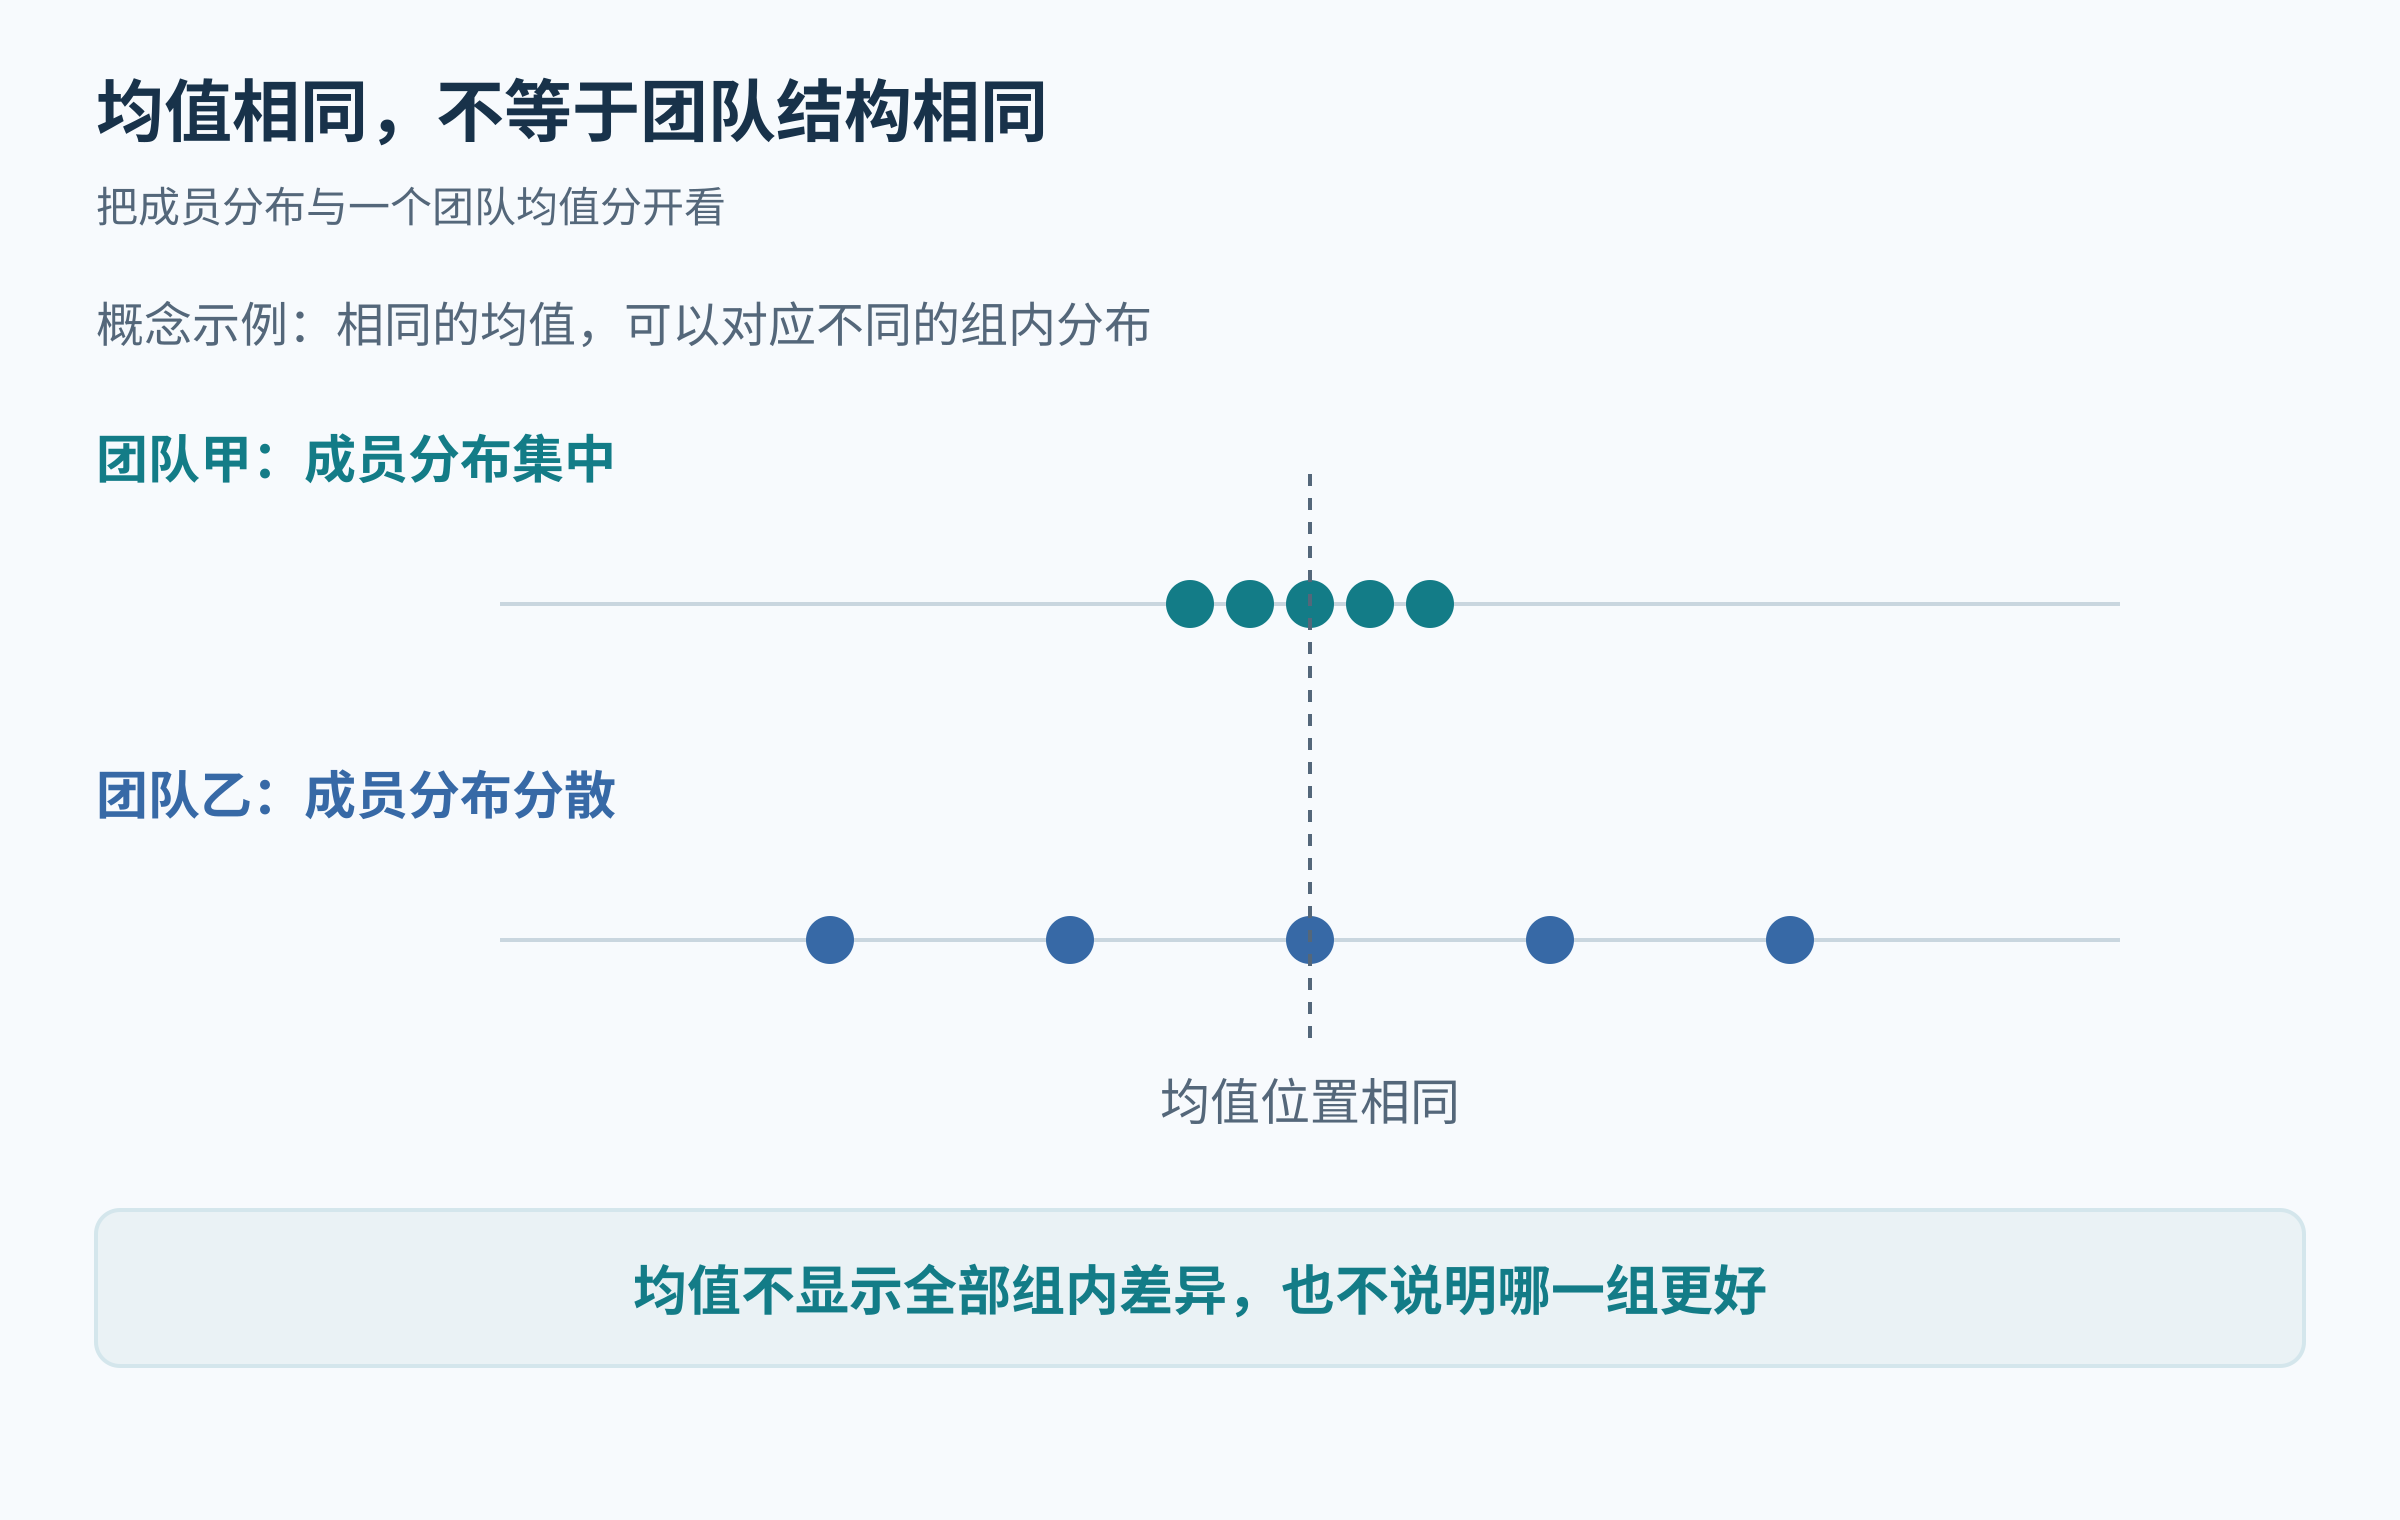
设想两组人:一组成员的测评分数相近,另一组差异很大,两组均值却一样。这个均值不会告诉我们,某项技能是否集中在一个人身上,也不会告诉我们,那个人在关键交接时有没有机会参与。成员负责的任务不同,同一种能力实际被调用的机会也不同。
还要留意测评测的是什么。自评问卷更接近成员对自己日常特点的报告,能力测验则要求完成情绪相关任务。把几份自评相加,不会自动变成团队共同处理冲突的能力测试。测评前后如果换了工具,两个均值也未必可以直接比较。
一项护理团队研究,为什么不只看均值
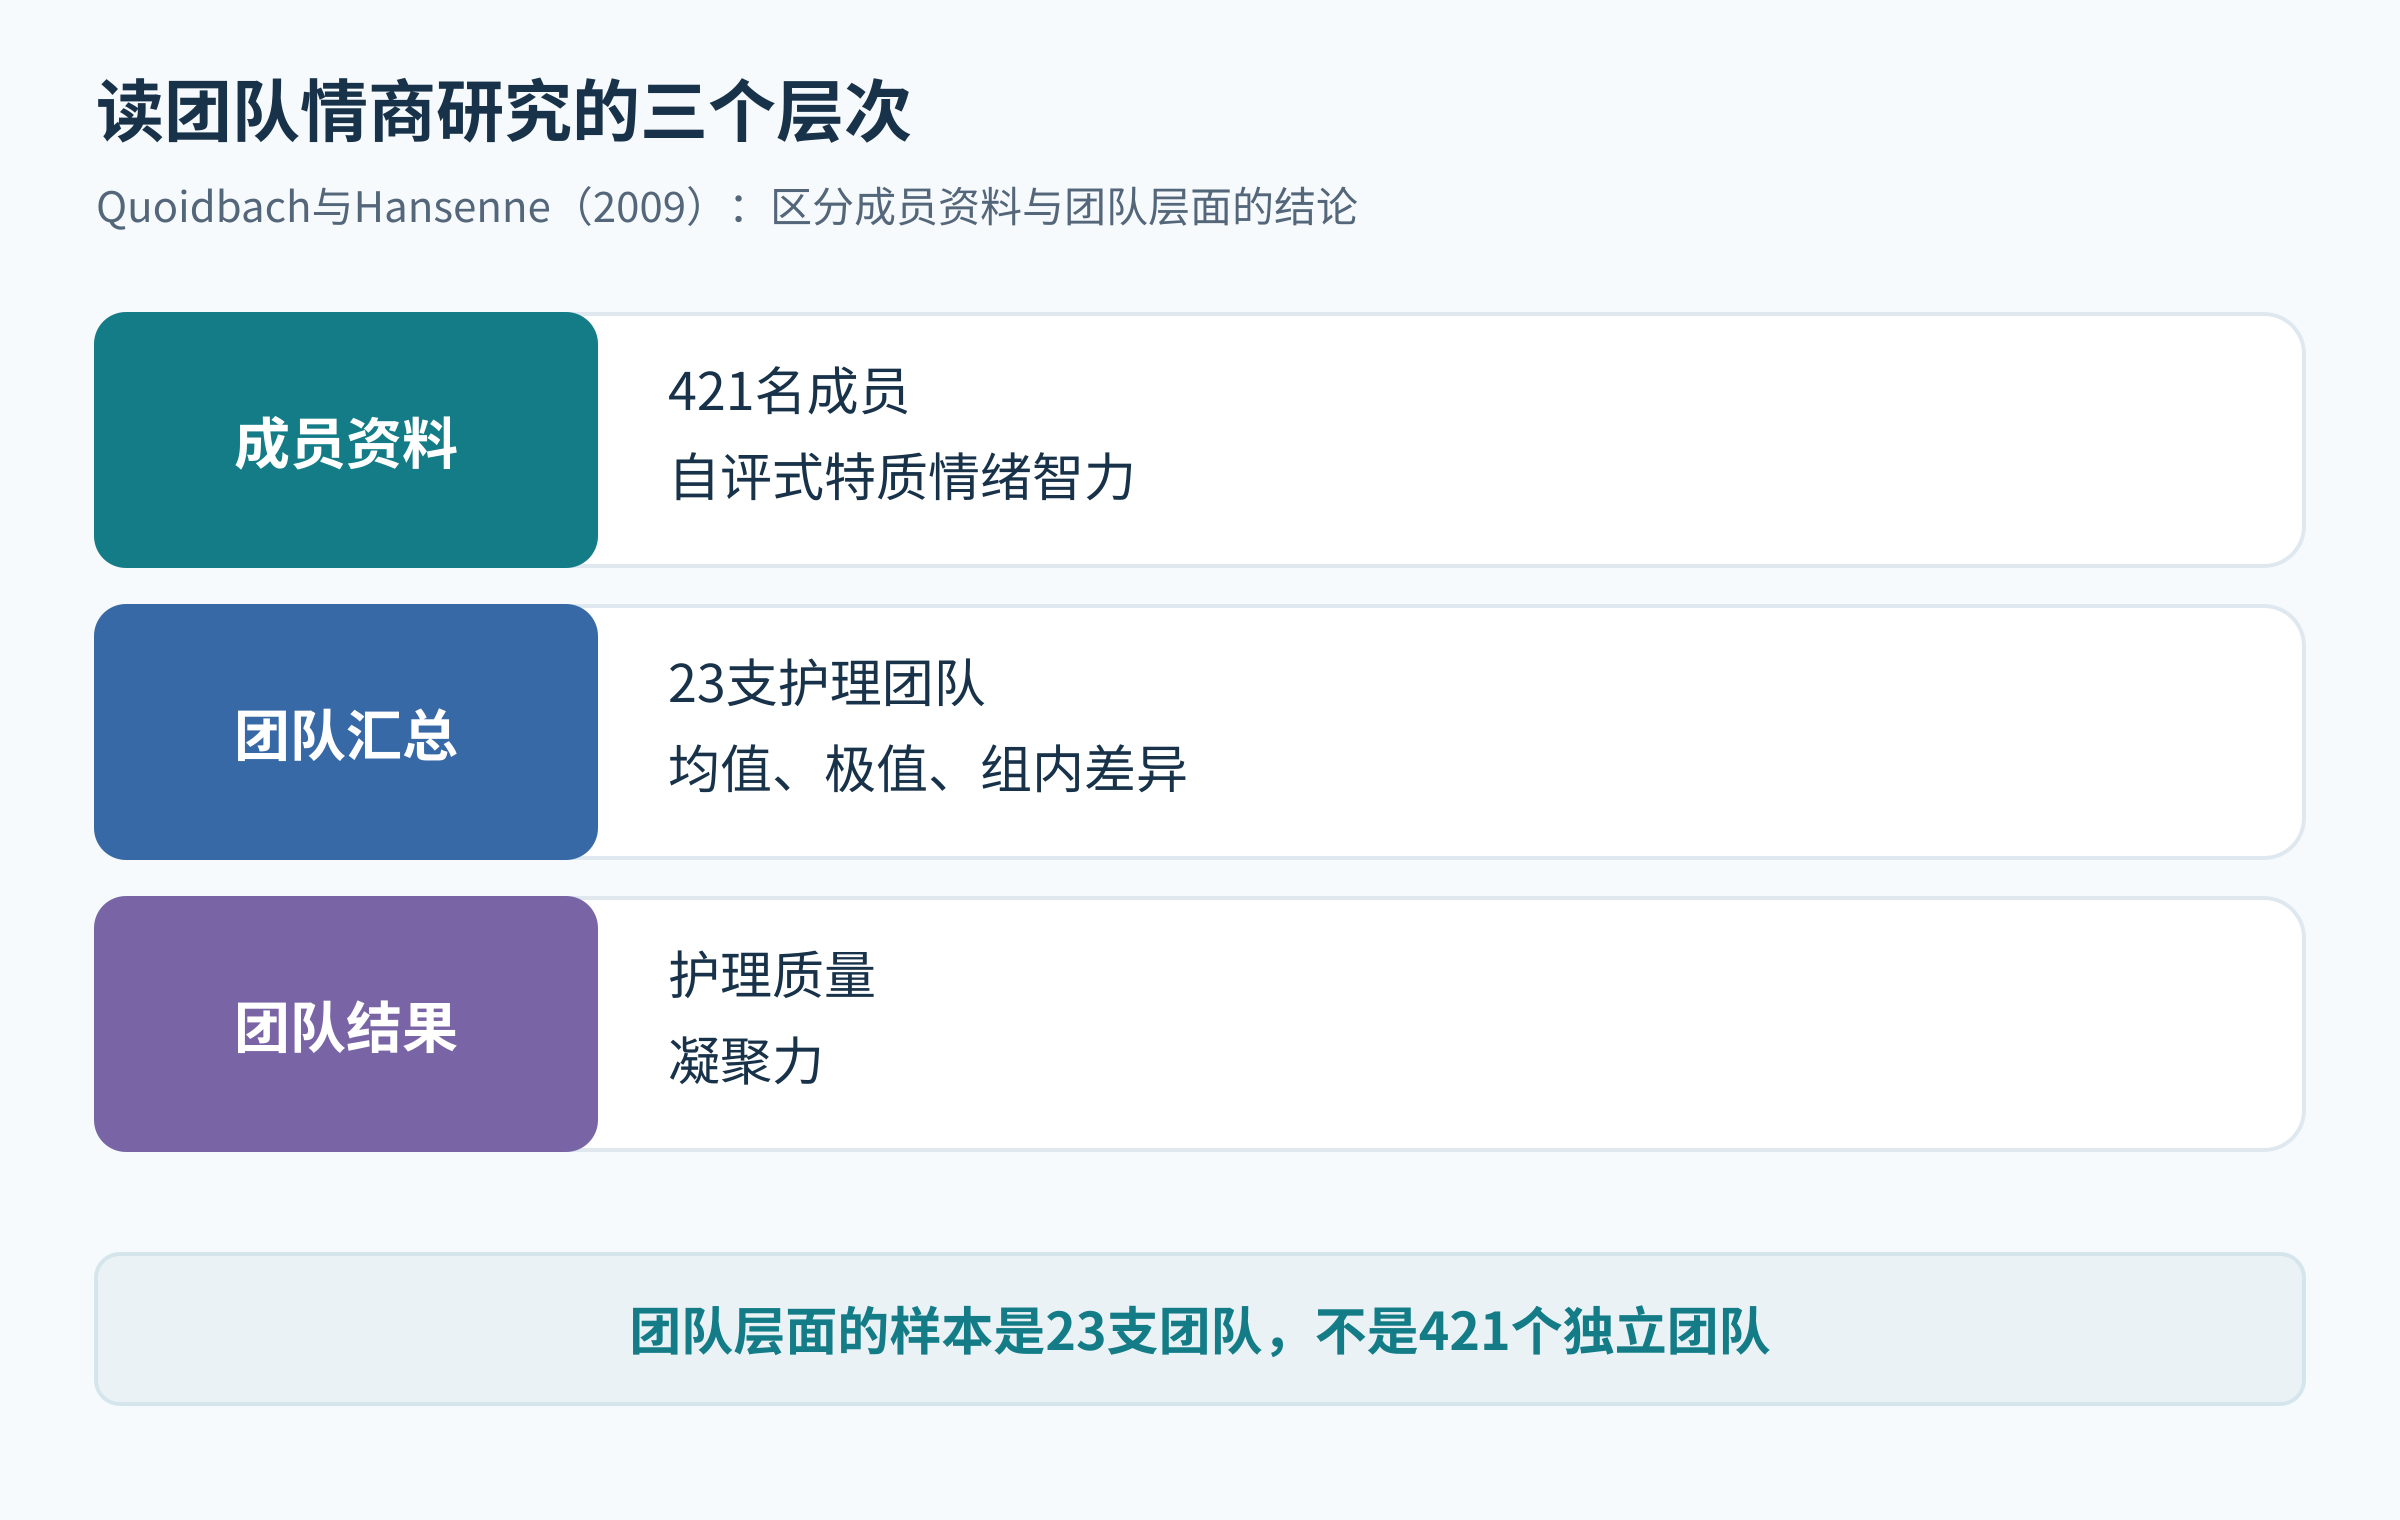
Quoidbach与Hansenne研究了比利时一家医院的二十三支护理团队,共四百二十一名成员。他们用自评式特质情绪智力量表收集资料,考察了团队的均值、最低值、最高值和组内差异,并把这些指标与护理质量、团队凝聚力相联系。[1]
结果也不是一个整齐的“情商越高越好”:在这个样本里,情绪调节与护理质量、凝聚力呈正相关,情绪评价维度与护理质量的关系却呈负向。这个结果提醒我们,维度、任务和结果指标不能混成一个口号;它并不能证明识别情绪有害,更不能据此找出团队里的“拖后腿者”。
这里还有一个容易漏看的细节:四百二十一人提供了成员资料,但研究团队之间差异时,团队数量是二十三,而不是四百二十一。单家医院的小规模团队研究,可以提出值得继续检验的问题,距离普遍适用的人员组合公式仍然很远。
想改善协作,先把“协作好”写具体
有的团队需要减少交接遗漏,有的需要让异议及时出现,有的则需要在客户投诉后尽快完成内部协调。它们不是同一个结果。比起追求一个高均分,可以先选择一次真实流程,写出谁向谁传递什么、何时确认、出现分歧时由谁作决定。
例如,项目组总在截止前争吵,可以先查看需求变更有没有留下记录,最后拍板的人是否明确,执行人员能否及时反馈工期。若这些条件没有改善,只要求大家重新做一次情商测评,很可能仍然回答不了为什么反复卡住。此处是工作复盘建议,不是那项护理研究验证过的干预方案。
让分数成为讨论线索,而不是排位表
如果团队已经做了测评,可以请负责解释的人说明:为何选均值,是否也看成员差异,所用工具适不适合这个人群,有没有与同一团队的实际行为对应。讨论时尽量用汇总信息,不公开逐人排名,也不要求最低分者解释所有矛盾。
一个更有用的会议问题是:“我们最容易在哪一步误解彼此,下次如何确认?”谁能把问题说清、谁愿意接住信息、流程是否允许修正,都需要在合作中观察。平均分可以放在桌上,但不必坐到会议主持人的位置。