

查看心理量表测量精度,不能只找一个总信度系数。还要看工具在你关心的特征水平上能提供多少信息、分数估计有多大不确定性。中等水平测得清楚,不保证高低端也一样;反过来,为较高症状水平设计的工具,也可能在高端比低端更精确。
假设一个研究项目要描述一般人群的压力差异,另一个项目要区分压力较高者之间的程度差别。即使两份量表的总体信度相近,适合这两个项目的工具也未必相同。问题是测量范围是否覆盖研究真正需要分辨的位置。
总体信度无法告诉你每个位置的误差
常见的内部一致性系数概括特定样本中的分数一致性,不能直接翻译为“每个人的结果都很准”。信度还受到样本差异范围等因素影响,因此不同研究中的一个系数,未必可以脱离样本和用途直接排名。ETS信度基础说明
条件测量标准误(conditional standard error of measurement,CSEM)进一步问:在某个分数或特征水平附近,测量波动有多大。不同位置可以对应不同的标准误。College Board的技术说明就将整体信度与特定分数位置的条件标准误分开报告,体现的正是这一区别。开发机构的解释
这里的标准误也不是样本均值的标准误。扩大调查人数,有助于群体参数估计,但不能因此宣称每位参与者那份短问卷的分数都同样精确。
信息曲线要先看坐标,再看目标范围
在项目反应理论(Item Response Theory,IRT)框架中,测验信息曲线呈现工具在不同潜在特质水平上的测量信息。横轴通常是特质水平,并不必然等于原始总分;纵轴越高,表示在相应模型与计量尺度下,该位置提供的信息越多。
在常用IRT条件近似下,信息量越多,分数估计的标准误越小。HealthMeasures的PROMIS结果解释资料把标准误与标准分一起使用,帮助呈现分数估计的不确定性。实际解释应按具体工具和估计方法提供的标准误进行,不把一条近似关系当作所有算法的统一计算规则。PROMIS结果解释资料
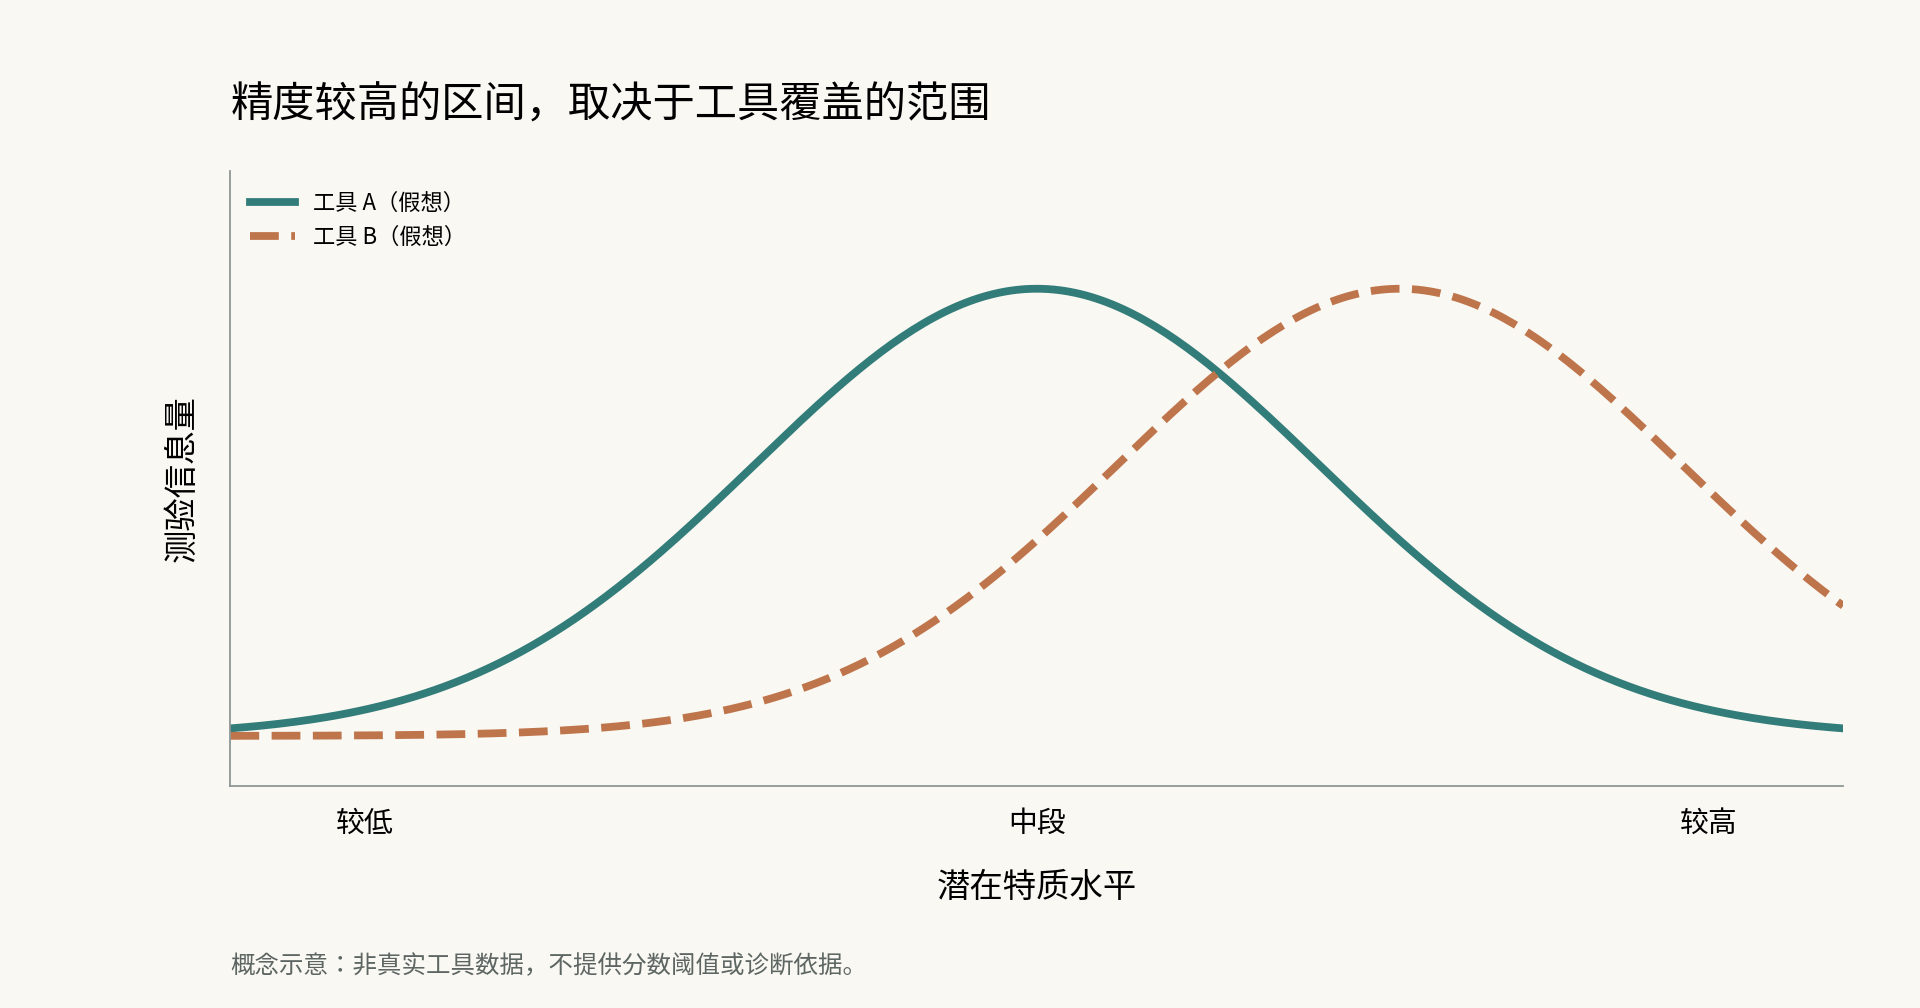
图中的曲线为概念示意,不来自真实工具或研究数据。工具A的信息更多集中在中段,工具B的信息较多集中在偏高水平。曲线的高低只帮助比较相应位置的测量精度,不代表疾病概率,也不代表任何分数可以直接作诊断。
因此,不能只看最高峰有多高。若项目需要覆盖较宽的特征范围,还要看曲线在哪些位置明显下降;若主要关心高水平内部的差异,就要核对这一段是否有足够信息。不同量表的横轴若没有经过可比较的标定或链接,也不能把两条曲线直接叠起来宣布谁更好。
真实工具确实可能具有不对称的覆盖范围。PROMIS情绪困扰题库的原始开发研究比较了不同水平的信息,发现其题库在约低于平均水平一个标准差至高于平均水平三个标准差的范围内,相比研究中选用的传统工具提供了更多信息。这是特定题库、样本与比较条件下的结果,不是所有心理量表“越靠中间越准”的规则。原始开发研究
选工具时,把需要的证据问具体
与其只问“信度有没有达到要求”,不如向工具提供方核对以下材料:
- 信息曲线或条件标准误对应哪一个版本、维度和计分方式,是完整题库、固定短表,还是自适应测验?
- 验证样本的年龄、语言和特征范围是否接近本项目,目标区间是否有足够样本支持,而非主要依靠模型外推?
- 曲线是否建立在可接受的模型拟合和相关假设之上,是否核对了群体间题项表现差异?
- 项目需要比较群体、解释个体还是追踪变化,相应用途有没有独立证据?
完整题库的信息曲线不能直接代表删减后的短表。自适应测验则需要进一步核对实际选题、停止规则和最终分数标准误,而不只是宣传材料里的一张题库图。若手册只提供总体信度,就应把“目标分数区间的精度尚不清楚”保留为待核实事项,不能自行补出曲线。
测得精确还不等于用得正确。筛查用途需要另行核对与适当参照标准比较的识别表现;纵向变化需要确认跨时间的可比性及变化解释;结果可能影响个人时,还需要合适的专业解释与其他资料。信息曲线回答的是某段测量有多清楚,不能替代这些证据。
一份有用的选型结论可以写成:“本项目主要关注某一特征范围,当前版本在该范围的精度证据较充分;更低或更高水平的个体结果需要保留较大的不确定性。”把适用范围写明,比给工具贴上一个笼统的“高精度”标签更便于后续使用。