

伴侣的情商测评不错,你却仍觉得自己经常没被理解。这并不自动说明测评无效,也不说明你的感受“不客观”。研究亲密关系时,需要同时问三个问题:测的是谁的情商,记录的是谁的体验,以及“关系好”具体指什么。
自己的感受与伴侣的感受,需要分开分析
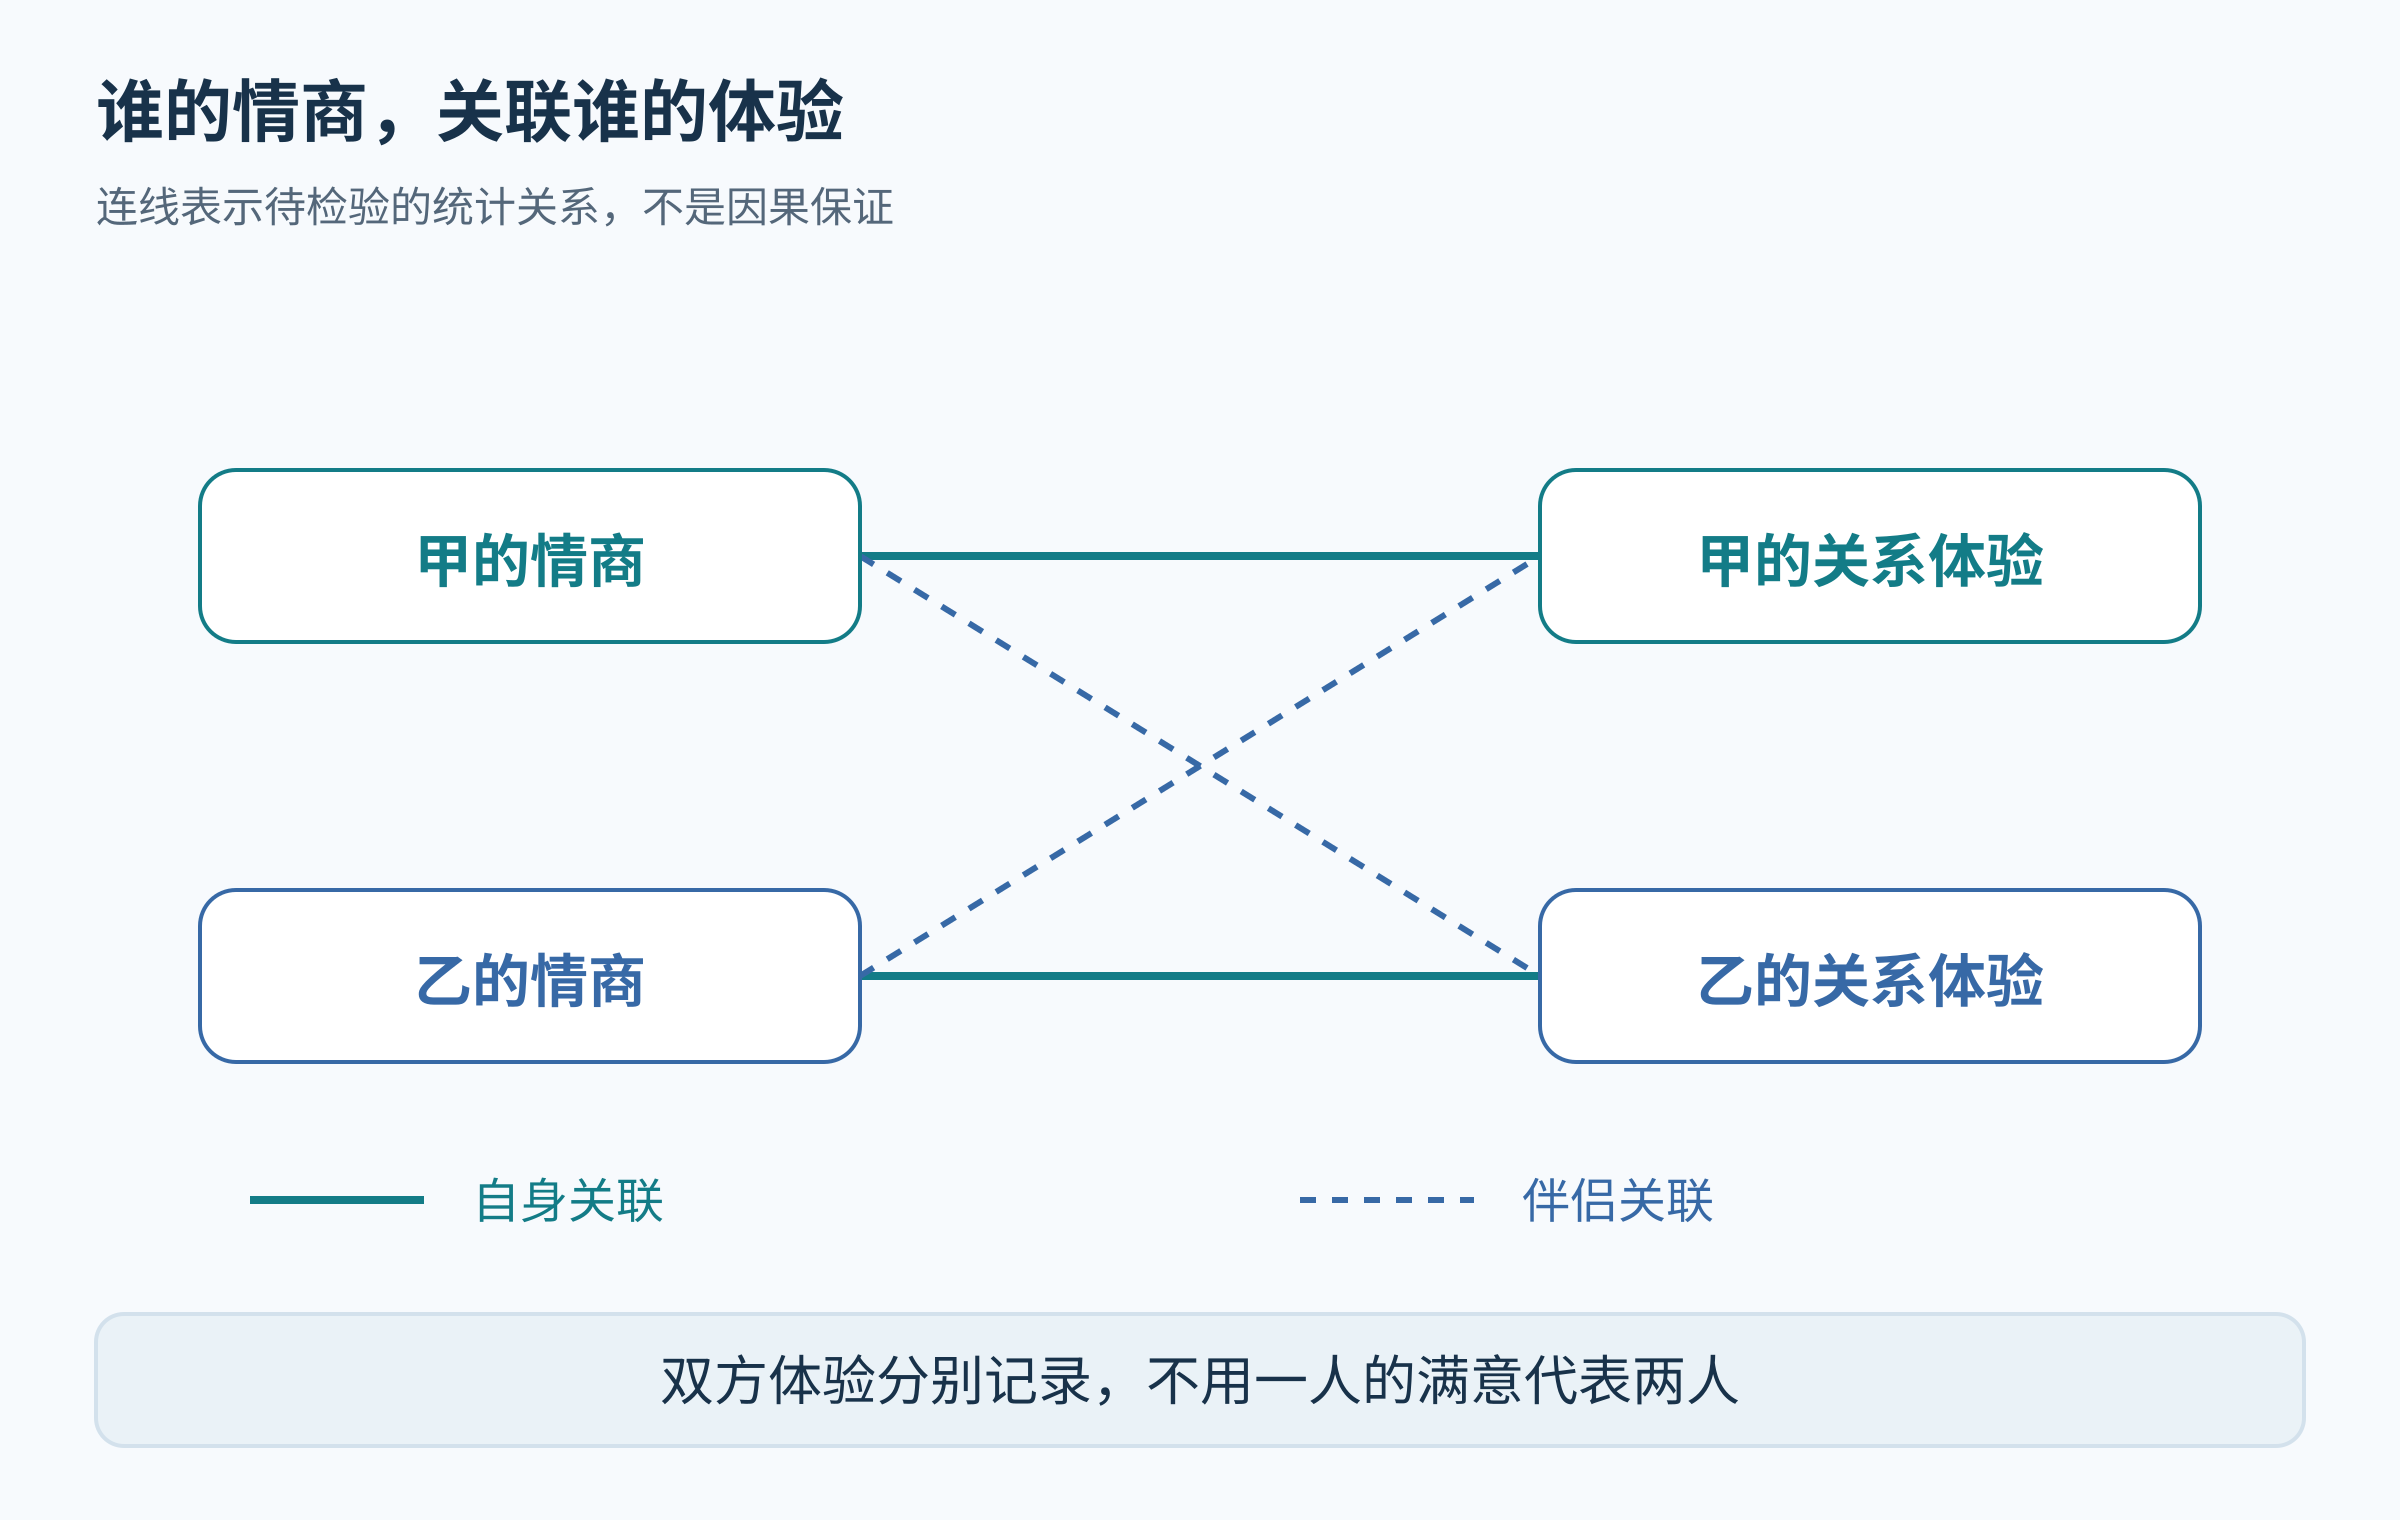
配对研究里,自身效应指一个人的情商与自己报告的关系体验之间的关系;伴侣效应则指这个人的情商与另一半的体验之间的关系。名称里虽然有“效应”,在相关研究中也不等于已经证明了因果。
例如,甲比较满意这段关系,乙却不一定同样满意。只问甲,再把答案写成“这对伴侣很幸福”,就遗漏了乙的信息。双方的报告也不是彼此独立的陌生人数据,因此研究需要相应的配对分析,而不是把每个人都当作互不相关的样本。
已有研究不是一条一致的配对公式
2005年,Brackett等人对86对异性大学生情侣的研究,将能力型情绪智力与关系质量联系起来,提示双方的组合值得考虑。[1]但大学生样本和相关结果,不能直接变成所有人适用的择偶分数线。
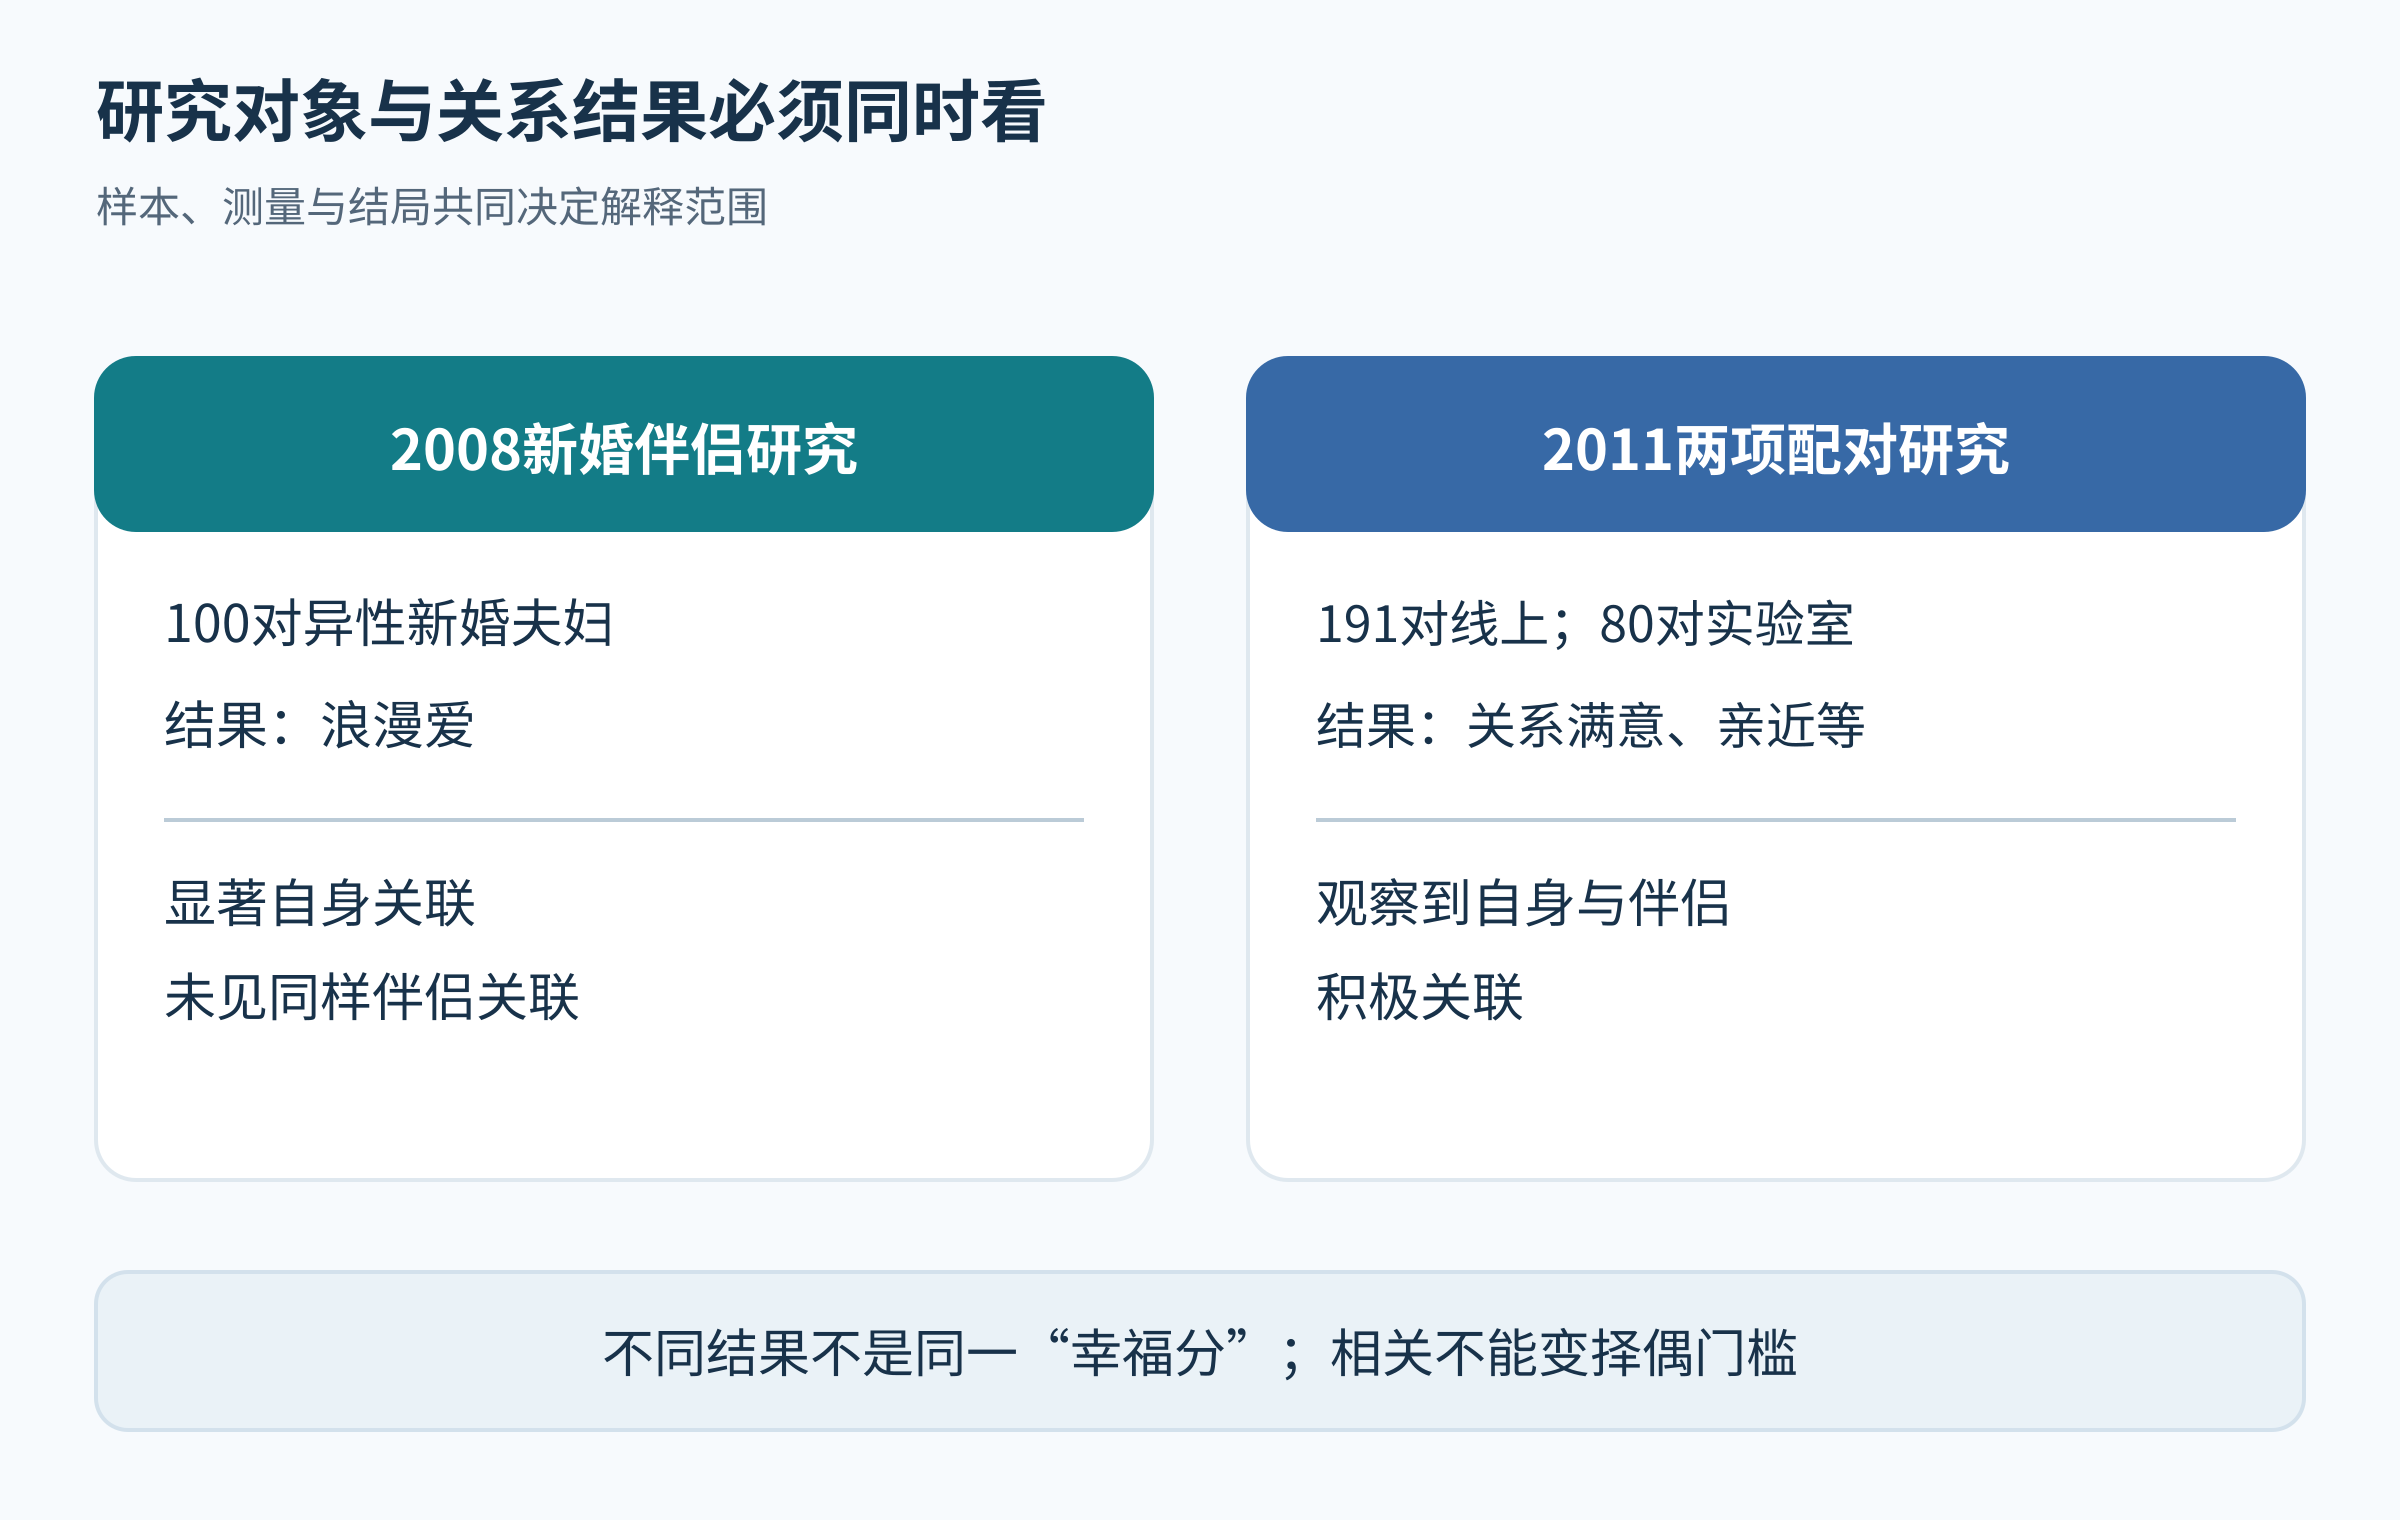
2008年一项包含100对异性新婚夫妇的研究,分别考察能力型、自评型情绪智力与浪漫爱,报告了显著自身效应,却没有同样的伴侣效应。[2]注意,浪漫爱不等于关系满意度,不能把不同结果统统写成“幸福”。
另一方面,2011年的两项配对研究,在191对线上样本和80对实验室样本中,发现了情绪智力与自身、伴侣关系体验的积极关联,其中还观察了冲突讨论中的观点采择。[3]这提醒我们,不能根据前一研究就说情商只对自己有用、对伴侣没用。
为什么有关系,仍不等于一定满意
研究中的平均关联,不保证每一对伴侣都符合。情绪理解、调节或自我评价,只覆盖关系生活的一部分;双方当前遇到什么问题、期待什么回应,也需要具体了解。测验高分不是关系质量的替身,更不是要求对方满意的理由。
能力型测验与自评问卷也提供不同信息。前者考察一定规则下的情绪问题表现,后者往往涉及一个人怎样看待自己的情绪特点。即使都叫情商,解释时仍应保留工具和用途,而不是把不同分数放在一起比较谁更适合恋爱。
把分数带回一次双方都能说清的互动
比起争论“到底谁情商低”,可以分别描述一件具体的事:当时发生了什么,我以为对方需要什么,对方实际上希望我怎样回应。双方答案的不同,是继续理解的入口,不必立刻转成输赢或归责。
例如,一方以为及时提解决办法是在关心,另一方当时只是想先被听见。这类差异值得核对,但也不能用一个温柔说法掩盖长期不尊重。是否愿意听取反馈、承担约定与尊重边界,需要看真实行为,不能由测评代替。
一张报告可以成为谈话素材,不该成为配对算法。高情商不保证伴侣一定满意;伴侣不满意,也不能单凭这一点推断谁的情商低。让双方的体验都被记录,比让某个分数裁决这段关系更有用。