

报告上写着IQ110,旁边还有一个区间。读到这里,有人会担心:连分数都不能确定,这次是不是白测了?其实,把不确定性写出来,恰恰能帮助我们避免对一个整数作出过重的判断。
理解这个区间,需要先分清两件事:报告在估计谁的什么,以及区间采用了哪一种计算方法。不能看到“95%置信区间”,就把所有测验都套进同一条公式。
点估计和区间,各有作用
点估计是本次测量给出的一个数值;区间则表达特定测量模型与条件下的估计不确定性。以常见的频率学派解释来说,若在相应假设下反复取样或测量,并用同一方法构造区间,约95%的区间会覆盖所估计的目标值。
这并不是让你反复做测验,直到收集到100个结果;也不是说“下一次有95%的概率落在这个范围”,更不是把区间内每个数当成同样可能的能力值。个体报告中的目标和方法,需要按该工具的说明理解。
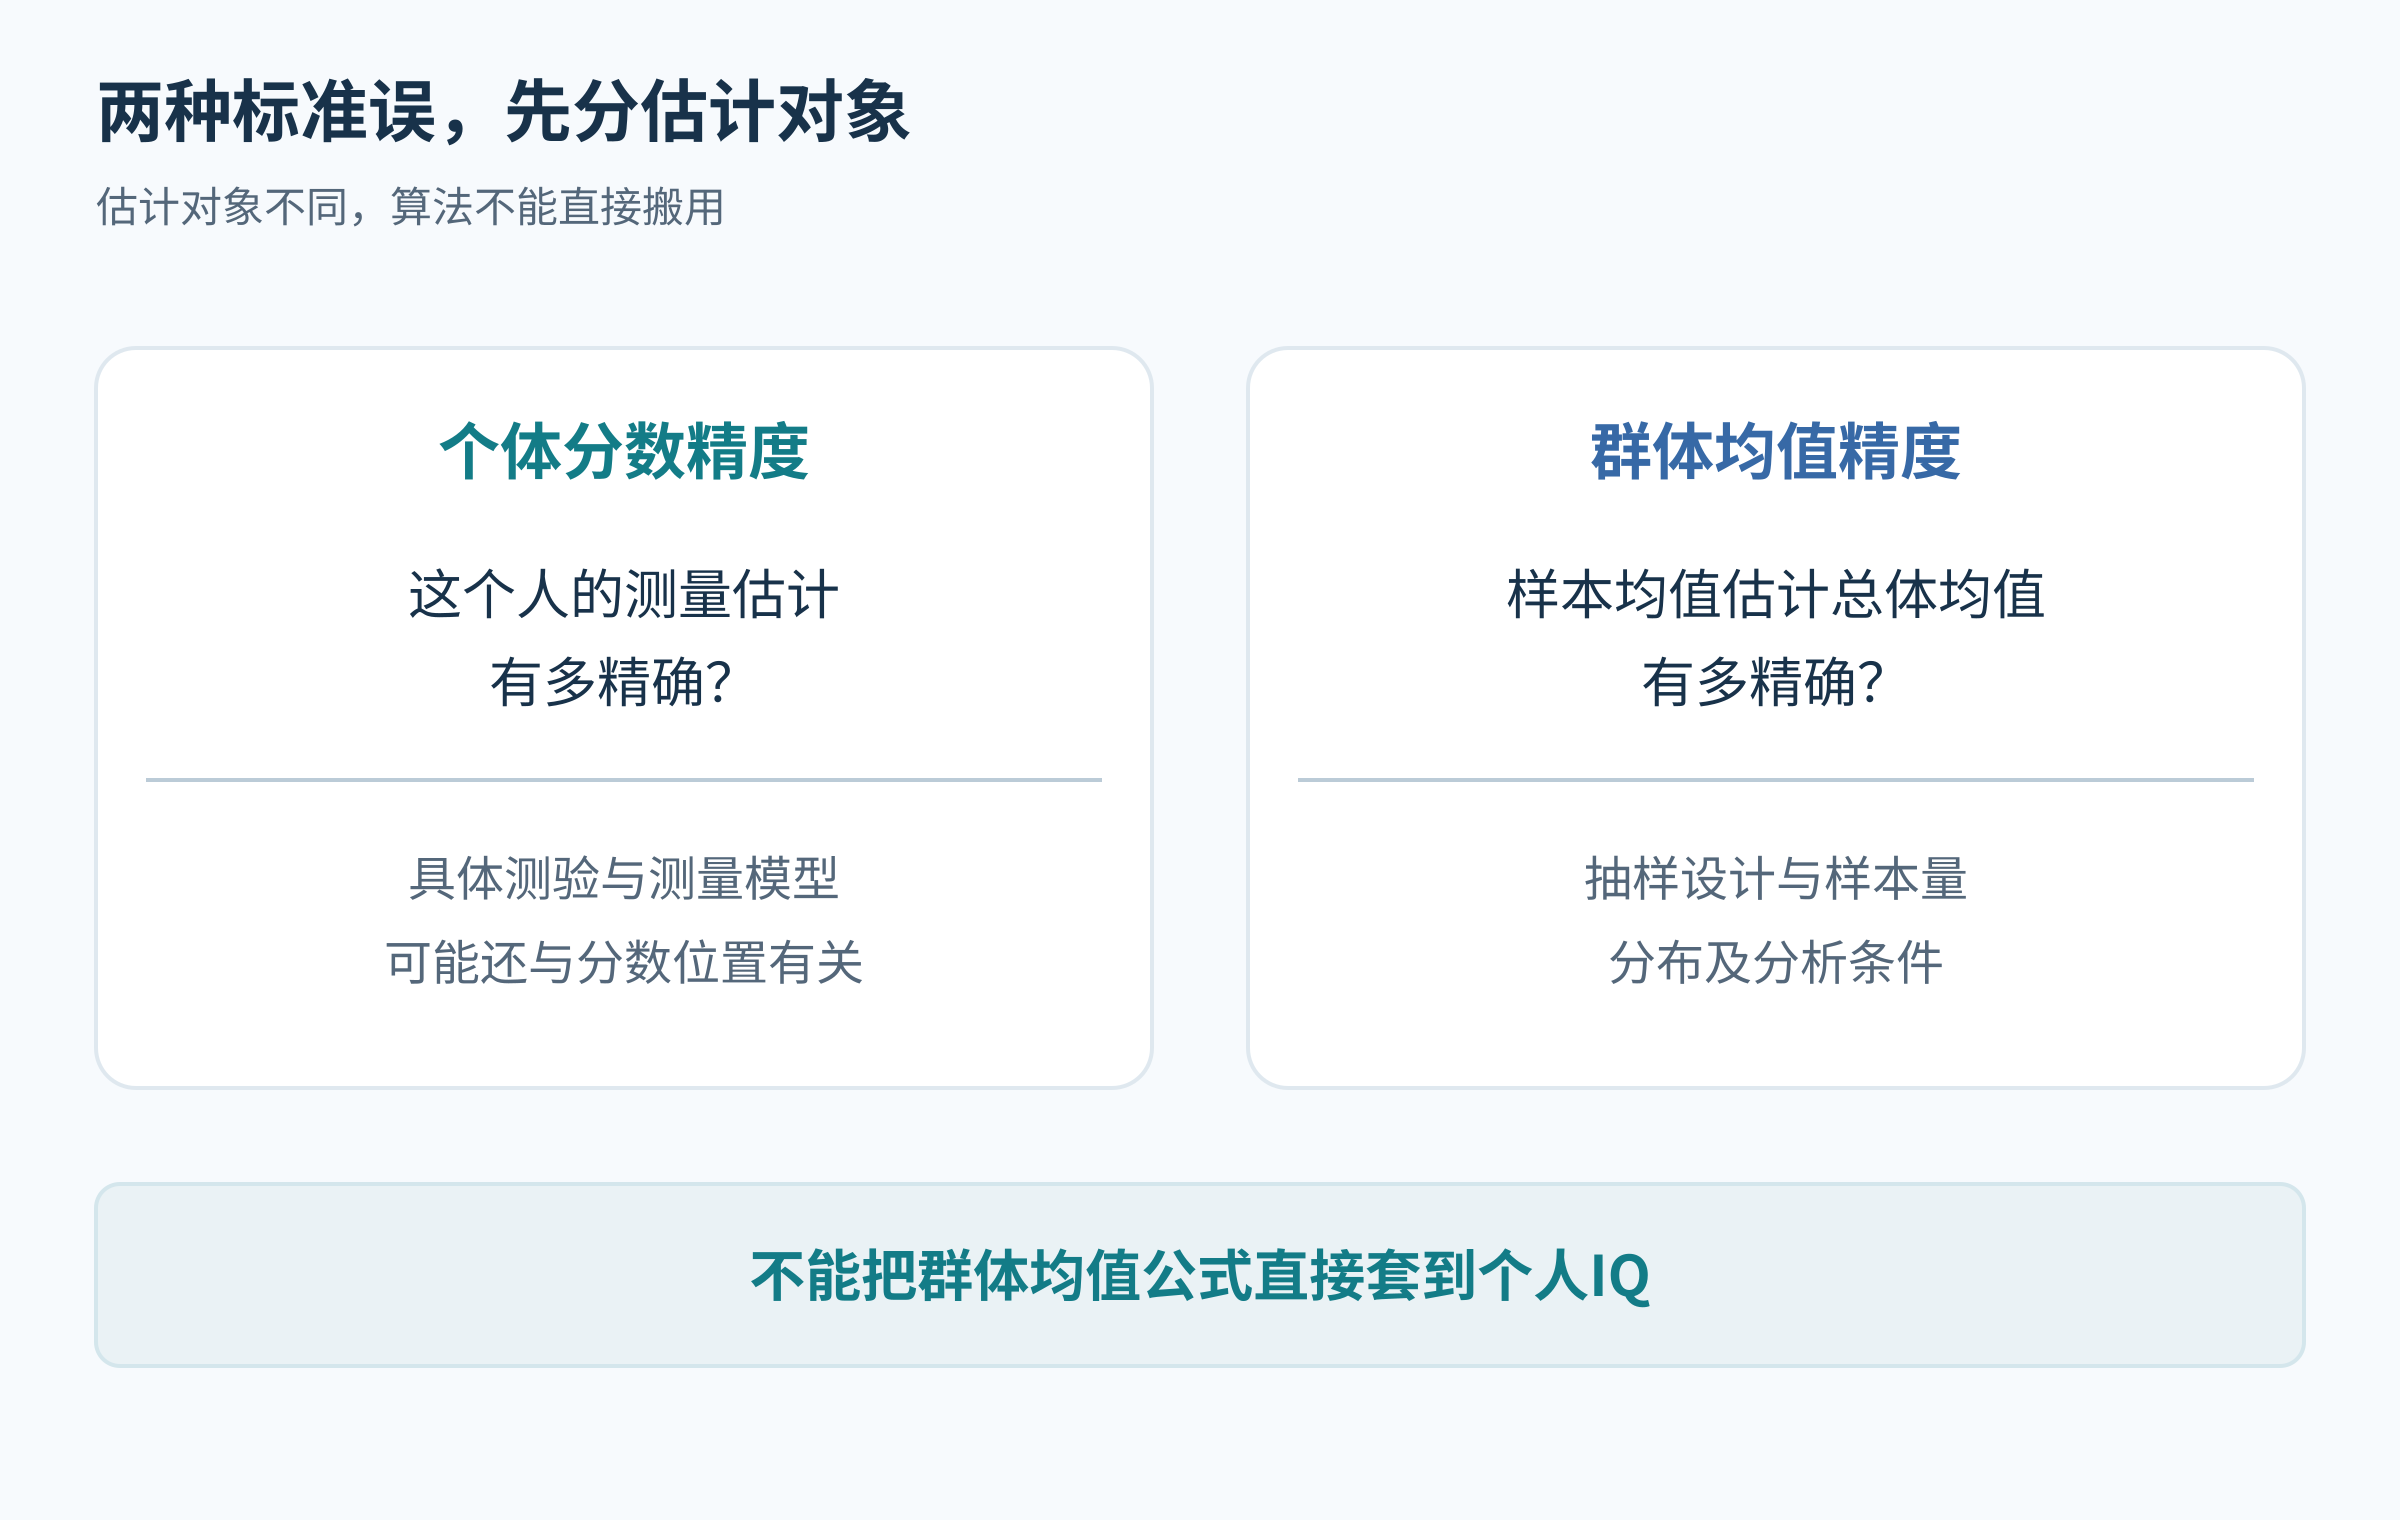
个体的测量误差,不能用样本均值公式代替
统计课中常见的“标准差除以样本量的平方根”,通常用来讨论样本均值的标准误。在相应抽样条件下,样本增多有助于更精确地估计群体均值。
但某个人的IQ测得多精确,是另一项问题。它涉及具体测验的可靠性、计分模型、分数位置和施测条件等。不能因为常模有几千人,就把这个人的分数误差简单除以几千人的平方根;也不能据此宣布个人区间已经很窄。《教育与心理测验标准》分别讨论个体测量精度与群体均值精度,正是为了避免混用。[1]
同样是智力报告,区间算法也要看版本
出版方公开的WAIS-5样例报告,在列出测量标准误的同时,注明置信区间采用估计标准误计算。它提醒我们:报告上的技术名词相近,不代表可以互相替换,更不能把某个“分数±固定值”的简化算法当作所有工具的规则。[2]
如果报告没有说明区间水平,或者只有笼统的“上下浮动几分”,可以问施测方:这个范围来自哪一版手册,反映的是哪种不确定性,是否适用于本人的年龄与这项分数。一般读者不必自行重算,重点是得到清楚、与工具一致的解释。
一两分差距,不宜单独承担重要判断
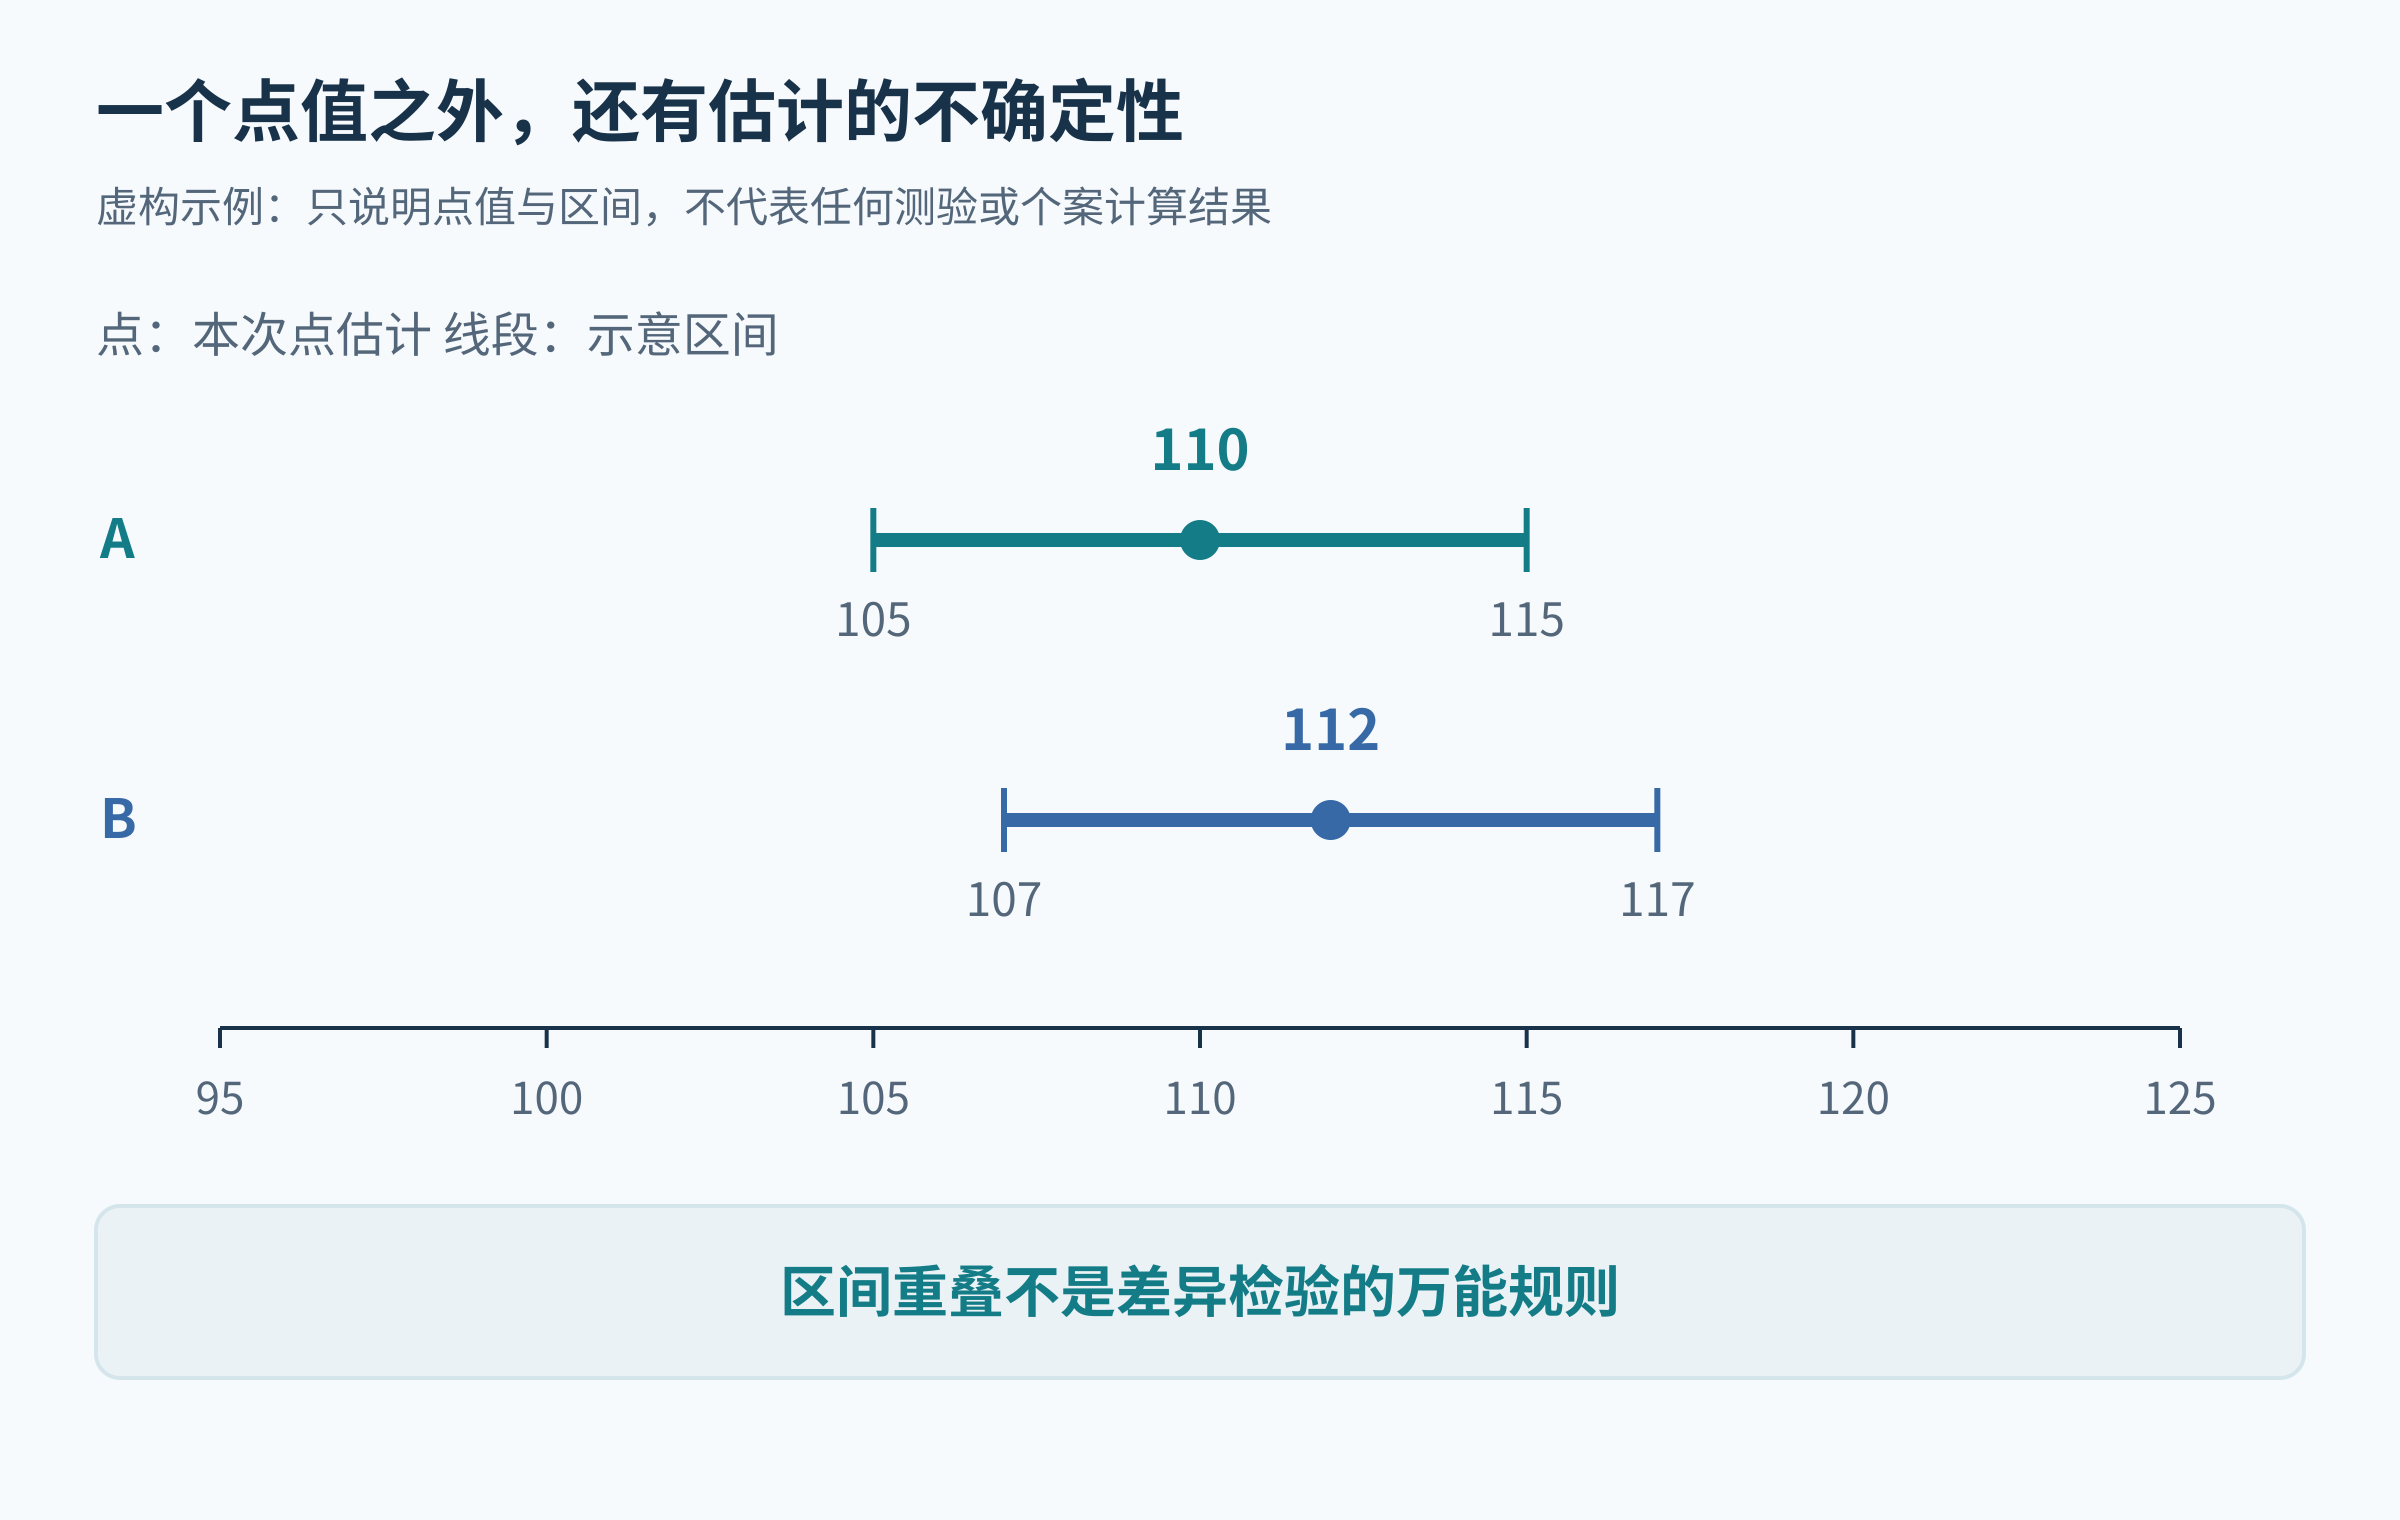
面对两个很接近的点值,先看各自精度,通常比立刻排出高低更合理。不过,两个区间是否重叠,并不是判断差异是否达到统计标准的万能方法。比较同一个人的两个指数,或前后两次结果,还可能涉及分数间关联、练习效应以及不同的比较规则。
同样,区间较宽只能提示估计不够精确,不能直接告诉你一定是当天情绪、理解偏差或哪道题出了问题。原因需要结合施测记录和具体情境了解。
如果分差涉及重要决定,可以把问题交给负责解释的人:“这个差异是否超出该工具预期的波动?比较依据是什么?除了分数,还需要哪些信息?”这比仅凭相差一两分决定支持安排更稳妥。
区间也不能单独充当临床处置规则。是否需要进一步评估或支持,要结合真实困难和专业判断;不能只因某个区间跨过一个界值,就统一决定“观察复测”或立即干预。
让误差说明留在报告里
像橙星云这样的平台,在生成4500多万份心理报告的过程中发现,用户对“误差提示”的关注度远低于对主分数的兴趣。
目前,包括橙星云在内的不少专业心理服务平台,已在职业性格、情绪状态等高频测评中逐步引入误差提示机制。
读报告时,留意有没有精度说明、适用限制和与当前问题相关的解释。承认测量有一定误差,不会让结果失去价值;它帮助我们把结论说得恰如其分。